Voice Agents That Handle Interrupts - Chintan Agrawal and Daniel Wirjo, AWS
📺 원본 영상: Voice Agents That Handle Interrupts - Chintan Agrawal and Daniel Wirjo, AWS
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-20
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 음성 에이전트의 품질을 결정하는 핵심 요소가 단순히 LLM의 성능이 아니라, 사용자가 언제 말을 끝냈는지와 언제 에이전트가 말을 멈춰야 하는지를 판단하는 오디오 파이프라인에 있다는 점을 다룬다. Chintan Agrawal과 Daniel Wirjo는 AWS APJ Startup 팀의 솔루션스 아키텍트로서, 음성 에이전트의 턴테이킹(turn-taking) 문제를 200ms 인간 대화 제약, Voice Activity Detection(VAD), STT 기반 턴 감지, 로컬 Smart Turn 모델, 그리고 실제 데모 관점에서 설명한다.
강연의 핵심 메시지는 명확하다. 완벽한 LLM을 사용하더라도 에이전트가 사용자의 끼어들기를 늦게 알아차리거나, 사용자가 아직 생각 중인데 먼저 답변을 시작하면 대화 경험은 깨진다. 따라서 음성 에이전트의 실전 품질은 모델 지능뿐 아니라 입력 오디오 감지, 턴 종료 판단, 인터럽트 분류, 파이프라인 플러시, 지연 시간 예산을 함께 설계하는 능력에 달려 있다.
음성 에이전트가 어려운 이유는 LLM보다 대화 타이밍에 있다
Chintan은 강연 초반에 같은 사용자, 같은 문장, 같은 LLM을 사용해도 결과 경험이 완전히 달라질 수 있다고 설명한다. 한쪽 사례에서는 사용자가 “I want to fly…”라고 말하다가 중간에 수정하려 하지만, 에이전트가 거의 2초 동안 계속 말해 사용자가 끼어들 기회를 얻지 못한다. 반면 다른 사례에서는 에이전트가 200ms 이내에 사용자의 인터럽트를 감지하고 즉시 발화를 멈추기 때문에, 사용자는 자연스럽게 자신의 말을 이어갈 수 있다.
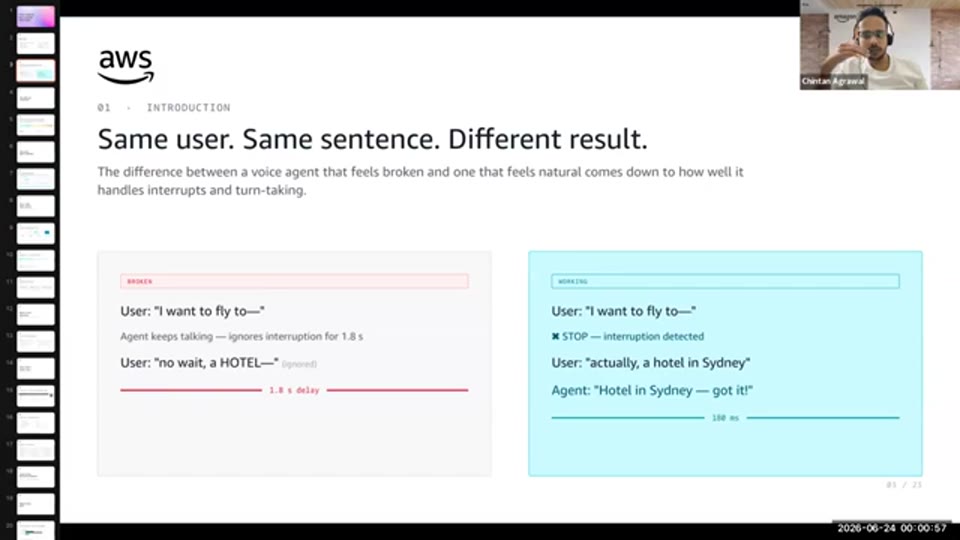
01:50 - 동일한 사용자 문장과 동일한 LLM에서도 인터럽트 감지 속도에 따라 사용자 경험이 달라지는 문제 사례를 비교하는 화면
이 차이는 모델의 추론 능력에서 나온 것이 아니라 오디오 파이프라인이 “다른 사람이 지금 말하고 있다”는 신호를 얼마나 빨리 알아차리고, 그 신호에 따라 TTS와 LLM 생성을 얼마나 빠르게 중단하느냐에서 발생한다. 텍스트 챗봇에서는 몇 초의 응답 지연도 사용자가 크게 불편하게 느끼지 않을 수 있지만, 음성 대화에서는 침묵과 겹쳐 말하기가 즉각적인 불쾌감으로 이어진다. 강연자는 인간 대화에서 턴 전환이 대략 200ms 수준으로 일어난다고 설명하며, 800ms부터는 어색함이 생기고 1.5초 수준에서는 사용자가 통화를 끊고 싶어질 수 있다고 강조한다.
이 지점에서 음성 에이전트 설계의 기준은 “얼마나 똑똑한 답을 생성하는가”에서 “언제 말해야 하고 언제 멈춰야 하는가”로 이동한다. 특히 고객 상담, 여행 예약, 세일즈 콜처럼 실시간 대화 흐름이 중요한 영역에서는 답변 내용이 맞더라도 턴테이킹이 불안정하면 사용자는 시스템을 신뢰하지 않는다. 강연이 턴 감지를 별도의 엔지니어링 문제로 분리해 다루는 이유도 여기에 있다.
200ms 제약과 음성 파이프라인의 구조
강연자는 일반적인 음성 에이전트 파이프라인을 STT(Speech-to-Text), LLM, TTS(Text-to-Speech)의 연쇄 구조로 설명한다. 사용자의 오디오가 들어오면 STT가 텍스트로 변환하고, LLM이 답변을 생성하며, TTS가 다시 음성으로 출력한다. 그러나 이 익숙한 세 구성요소만 보면 턴테이킹의 실제 위치를 놓치기 쉽다. Chintan에 따르면 턴테이킹을 제어하는 중요한 컴포넌트는 파이프라인 맨 앞에 위치한 VAD(Voice Activity Detection)이다.
VAD의 역할은 사용자가 말하고 있는지, 혹은 멈췄는지를 판단하는 것이다. 하지만 실제 대화에서는 단순히 음성이 있느냐 없느냐만으로 충분하지 않다. 사용자가 숨을 고르는 300ms의 침묵과 문장을 완전히 끝낸 뒤의 300ms 침묵은 오디오 신호만 보면 비슷할 수 있지만, 대화 의미상으로는 완전히 다르다. 따라서 VAD 신호 위에는 Smart Turn Detection처럼 음향 특징과 언어적 맥락을 함께 보는 판단 계층이 필요해진다.
인터럽트 핸들러도 별도의 핵심 컴포넌트로 등장한다. 사용자가 에이전트의 발화 도중 끼어들면 파이프라인은 다운스트림으로 flush 신호를 전파해 TTS를 멈추고 LLM 생성을 취소해야 한다. 강연자는 이 전체 정리가 약 15ms 내에 일어나야 파이프라인이 새 사용자 입력을 받을 준비를 할 수 있다고 설명한다. 결국 음성 에이전트의 자연스러움은 STT, LLM, TTS 각각의 품질뿐 아니라 이 구성요소들이 실시간으로 중단, 재개, 대기 상태를 전환하는 방식에 의해 결정된다.
레벨 1 - Silero VAD로 침묵을 감지하는 가장 단순한 접근
첫 번째 접근은 Silero VAD를 사용해 침묵 시간을 기준으로 턴 종료를 판단하는 방식이다. 강연자는 이를 “레벨 1”이라고 부르며, 많은 프로덕션 시스템이 여전히 이 방식만으로 음성 에이전트를 운영한다고 설명한다. Silero VAD는 약 30만 개 파라미터를 가진 작은 모델로, raw audio를 Short-Time Fourier Transform(STFT)을 통해 spectral feature로 변환하고, convolutional layer와 LSTM을 거쳐 speech probability를 산출한다. 즉, 이 모델은 현재 오디오 프레임에 사람이 말하고 있을 확률을 빠르게 계산하는 데 초점을 둔다.
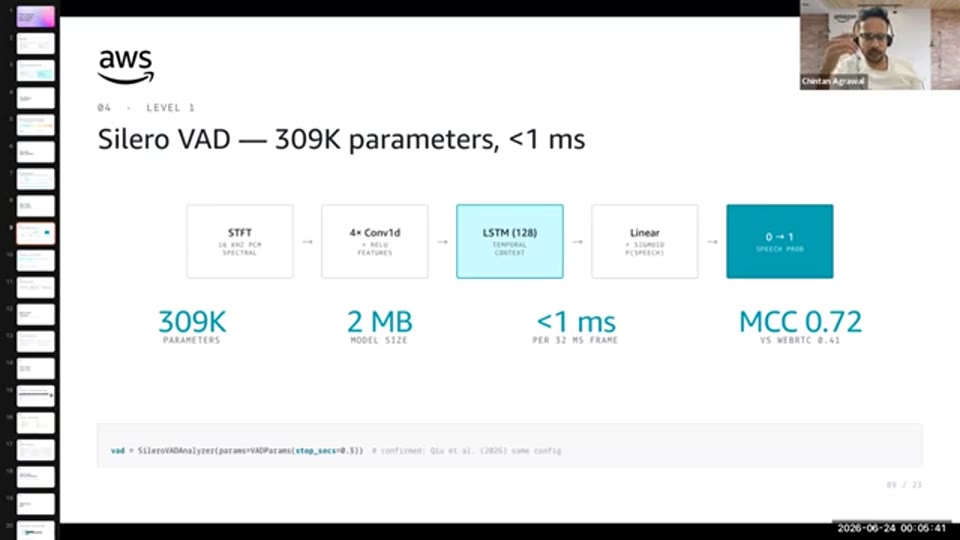
05:46 - Silero VAD의 모델 구조와 speech probability 산출 방식을 설명하는 슬라이드 또는 다이어그램
이 방식의 사용자 경험은 사실상 minimum_silence_ms 같은 하나의 파라미터에 크게 좌우된다. 침묵 기준을 너무 낮게 잡으면 에이전트가 사용자가 아직 생각하는 중인데도 말을 시작해 “말을 자르는” 느낌을 준다. 반대로 기준을 너무 높게 잡으면 에이전트가 지나치게 오래 기다리면서 사용자는 연결이 끊겼거나 시스템이 멈췄다고 느낄 수 있다. Chintan은 세일즈 에이전트처럼 빠른 응답이 중요한 환경에서는 200ms 수준을 원할 수 있지만, 사용자가 고민하고 답해야 하는 도메인에서는 1000ms에서 1200ms 정도의 여유가 더 적절할 수 있다고 설명한다.
Silero VAD의 장점은 단순성과 통제 가능성이다. 개발자는 로컬에서 이 컴포넌트를 완전히 소유하고, 로그와 설정을 직접 조정할 수 있다. 그러나 이 접근은 침묵의 의도를 구분하지 못한다는 근본적인 한계를 갖는다. 같은 침묵이라도 완성된 문장, 미완성 사고, 생각하는 중간 pause, 단순 맞장구일 수 있는데, VAD는 이 네 경우를 모두 같은 종류의 “음성 없음”으로 취급한다. 따라서 레벨 1은 빠르고 실용적이지만, 대화의 의미를 이해하는 턴 감지라고 보기는 어렵다.
레벨 2 - STT 제공자의 턴 감지에 맡기는 방식
두 번째 접근은 STT 서비스가 턴 종료를 직접 알려주도록 맡기는 방식이다. 강연에서는 Cartesia Ink 계열 STT 서비스와 Deepgram Nova 3의 endpointing 기능이 예시로 언급된다. 이 방식에서는 오디오가 STT 서버로 스트리밍될 때 transcription과 turn detection이 함께 수행되고, 서버가 “이 턴은 끝났다”고 판단하는 이벤트를 emit한다. 강연자는 Cartesia Ink의 P50 latency를 약 300ms, Deepgram Nova 3의 P50 latency를 약 250ms 수준으로 설명한다.
이 접근의 장점은 VAD보다 풍부한 정보를 사용할 수 있다는 점이다. STT 제공자는 단순한 음성 유무뿐 아니라 전체 오디오 신호와 일부 언어적 맥락을 함께 볼 수 있기 때문에, 사용자가 문장을 끝냈는지 아직 이어 말하려는지 더 정교하게 판단할 가능성이 있다. Daniel의 데모에서도 단순 침묵 감지 방식에서는 “I’m thinking of going to…”처럼 끝나지 않은 문장 뒤에 에이전트가 바로 응답했지만, STT 기반 턴 감지에서는 에이전트가 답변하지 않고 기다리는 모습을 보여준다.
하지만 이 방식에는 투명성의 비용이 있다. 감지가 잘 작동할 때는 매우 편리하지만, 잘못된 순간에 사용자를 끊거나 지나치게 오래 기다릴 때 개발자는 내부 판단 이유를 확인하기 어렵다. Chintan은 그 결정이 “다른 사람의 서버 안에서” 내려지기 때문에, 왜 그런 판단이 나왔는지 로그로 해석하기 어렵다고 지적한다. 따라서 레벨 2는 구현 부담을 줄이고 성능을 높일 수 있지만, 디버깅 가능성과 정책 제어권을 일부 포기하는 선택이다.
레벨 3 - VAD 위에 Smart Turn 모델을 얹는 방식
세 번째 접근은 로컬 VAD를 유지하면서 그 위에 Smart Turn 모델을 추가하는 방식이다. 이 구조에서 VAD는 여전히 기본적인 “지금 음성이 있는가” 신호를 제공하고, Smart Turn 모델은 침묵 구간에서 그 pause가 실제 턴 종료인지 아니면 사용자가 아직 생각 중인지를 판단한다. 강연자는 Smart Turn v3.2를 최신 모델로 소개하며, 약 58.9% recall과 68.4% precision 수치를 언급한다. 이 수치는 모델이 문장 종료를 빠르게 잡아내는 능력이 아직 완벽하지 않지만, VAD timer와 결합하면 실용적인 하이브리드 시스템을 만들 수 있음을 보여준다.
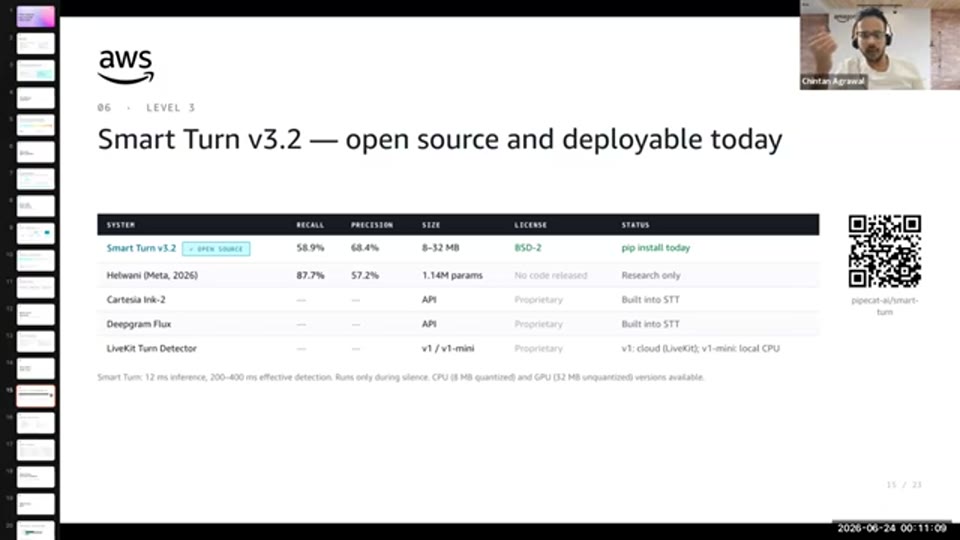
10:20 - Smart Turn v3.2의 recall, precision, deployability 관련 수치를 설명하는 화면
Chintan의 설명에 따르면 Smart Turn이 확신할 때는 빠르게 응답하고, 확신하지 못할 때는 아래에서 돌아가는 VAD timer가 안전망 역할을 한다. 예를 들어 Smart Turn이 턴 종료를 감지하지 못하더라도 stop_seconds 설정이 300ms라면, 시스템은 결국 해당 기준에 따라 응답을 시작한다. 이 구조의 장점은 빠른 응답과 안전한 fallback을 동시에 얻는 데 있다. 모델이 확신하는 경우에는 자연스러운 속도를 얻고, 확신하지 못하는 경우에는 지나치게 오래 멈춰 있지 않도록 보장한다.
강연자는 Smart Turn이 BSD-2 라이선스의 약 8MB 소형 모델이며, 현재 배포 가능한 형태로 사용할 수 있다고 설명한다. 또한 별도의 연구에서는 더 높은 recall 수치가 보고되었지만 코드가 공개되지 않아 실제 배포에는 활용하기 어렵다고 덧붙인다. 이 대목은 음성 에이전트 시스템에서 논문 성능보다 운영 가능한 모델, 로그를 볼 수 있는 모델, 인프라에 올릴 수 있는 모델이 더 중요하다는 현실적인 메시지를 전달한다.
인터럽트 처리의 핵심은 “멈출지 말지”를 구분하는 것이다
음성 에이전트에서 인터럽트는 단순히 사용자가 소리를 냈다는 이유만으로 처리할 수 없다. 강연자는 사용자가 에이전트 발화 중 “yeah”라고 맞장구를 치는 경우와 “wait, no, that was wrong”처럼 정정을 요구하는 경우를 구분해야 한다고 설명한다. 전자는 에이전트가 계속 말해도 되는 신호일 수 있지만, 후자는 즉시 멈추고 사용자에게 발화권을 넘겨야 하는 신호다.
강연에서는 이를 색상으로 구분한 개념적 분류가 소개된다. 빨간색은 correction에 해당하므로 모든 것을 멈춰야 하고, amber는 filler나 배경 반응일 수 있어 계속 진행하되 더 조용히 처리할 수 있으며, 파란색은 cough나 background noise처럼 무시해도 되는 신호에 가깝다. 화면상 색상 분류가 언급되지만, STT에는 실제 슬라이드의 세부 도식이 포함되어 있지 않으므로 여기서는 강연자가 말로 설명한 범위까지만 정리한다.
💡 [영상 참조] 강연자는 이 부분에서 인터럽트를 correction, filler, background noise 등으로 나누는 화면 자료를 참조하며 설명합니다.
📺 원본 영상에서 확인하세요.
이 구분이 중요한 이유는, 오늘날 많은 시스템이 사용자의 소리가 들어올 때마다 무조건 에이전트 발화를 중단하기 때문이다. 하지만 실제 인간 대화에서는 모든 겹침 발화가 중단 요청은 아니다. 레벨 3 방식처럼 개발자가 interruption classification을 소유하면, 시스템은 진짜 끼어들기와 단순 반응을 구분하는 방향으로 발전할 수 있다. 이는 음성 에이전트가 “말을 잘하는 시스템”에서 “대화 예절을 아는 시스템”으로 이동하기 위한 중요한 단계다.
세 접근법은 코드보다 구성 철학의 차이에 가깝다
Chintan은 세 가지 예제의 Python 파일을 비교하면서, 코드 구조는 거의 동일하고 달라지는 것은 “사용자가 말을 끝냈는지 어떻게 판단할 것인가”라고 설명한다. 첫 번째 파일에서는 Silero VAD Analyzer를 넣어 사용자가 300ms 동안 침묵하면 끝났다고 가정한다. 두 번째 파일에서는 Cartesia Turn STT Service 클래스를 사용해 STT 서버가 턴 종료를 알려주게 한다. 세 번째 파일에서는 Silero VAD Analyzer를 유지하면서 Smart Turn Analyzer v3를 추가해 prosody와 intonation을 기반으로 pause의 의미를 해석한다.
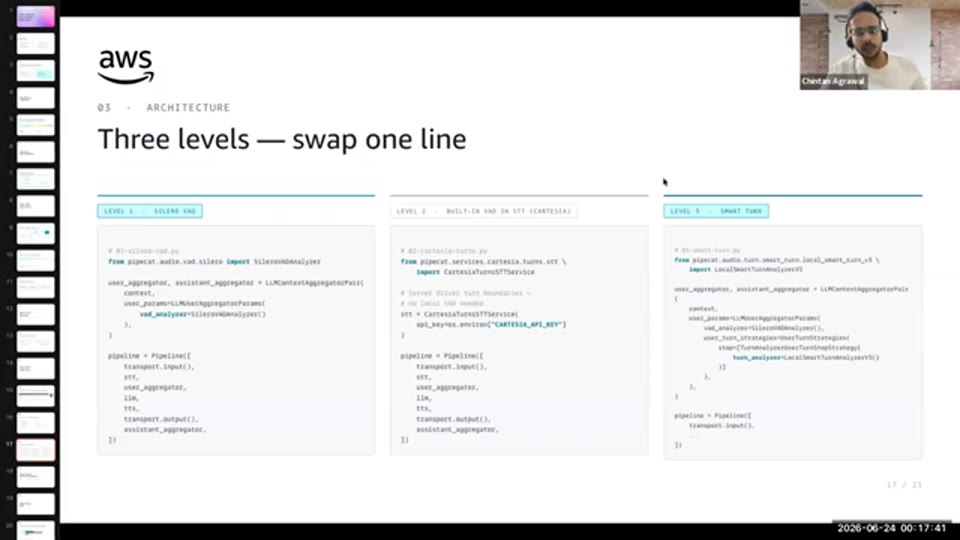
13:56 - 세 가지 Python 예제에서 VAD, STT 기반 턴 감지, Smart Turn analyzer 구성이 어떻게 달라지는지 보여주는 코드 화면
이 비교는 음성 에이전트 아키텍처에서 턴 감지가 교체 가능한 정책 계층처럼 동작할 수 있음을 보여준다. 같은 STT, 같은 LLM, 같은 TTS를 사용하더라도 턴 종료 판단만 바꾸면 사용자 경험은 완전히 달라진다. 따라서 프로덕션 시스템에서는 “어떤 LLM을 쓸 것인가”만큼이나 “턴 감지를 어디에 맡길 것인가”가 중요한 설계 결정이 된다.
Daniel의 데모도 이 차이를 구체적으로 보여준다. Silero VAD만 사용한 첫 번째 예제에서는 “I’m thinking of going to…”라는 미완성 문장 뒤에 침묵이 생기자, stop seconds 설정에 의해 에이전트가 바로 응답한다. STT 기반 턴 감지를 사용한 두 번째 예제에서는 같은 미완성 문장에도 에이전트가 기다렸고, 사용자가 “Sydney?”라고 목적지를 말한 뒤에야 응답했다. Smart Turn을 사용한 세 번째 예제에서는 불완전한 문장에서는 incomplete로 판단하고, “I’m actually thinking of going to Sydney”처럼 완성된 문장에서는 complete로 분류해 다음 턴으로 넘어가는 모습을 보여준다.
지연 시간 예산에서 가장 큰 병목은 STT와 LLM이다
강연 후반부는 latency budget으로 이동한다. Chintan은 표준적인 클라우드 API 기반 cascaded pipeline에서 전체 voice-to-voice 지연이 대략 1100ms에서 1300ms 수준이 될 수 있다고 설명한다. 이 안에는 encoding 약 40ms, network-in 약 52ms, transcription과 endpointing 약 300ms, LLM time-to-first-byte 약 500ms에서 650ms, network-out과 playback, TTS 구간의 추가 지연이 포함된다. 핵심은 네트워크와 모델 호출이 합쳐지면서 인간 대화의 200ms 턴 전환 속도와 큰 차이가 벌어진다는 점이다.
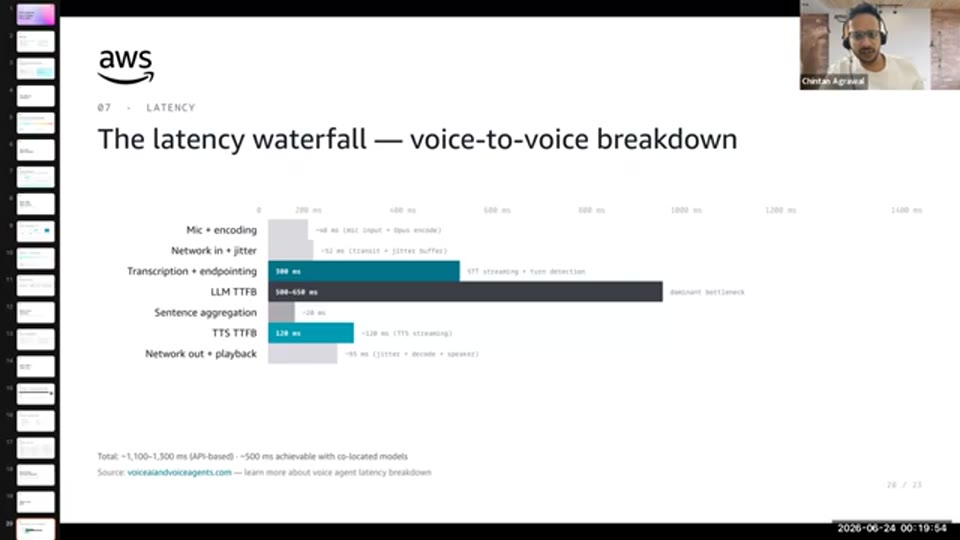
15:47 - encoding, network, STT, LLM, TTS로 나뉜 voice-to-voice latency budget breakdown 화면
| 구간 | 강연에서 언급된 대략적 지연 |
|---|---|
| Encoding | 약 40ms |
| Network-in | 약 52ms |
| Transcription + endpointing | 약 300ms |
| LLM time-to-first-byte | 약 500~650ms |
| 전체 cloud API 기반 구성 | 약 1100~1300ms |
| 모델 co-location 최적화 구성 | 약 500ms voice-to-voice |
이 표에서 보듯, 전체 지연을 의미 있게 줄이려면 STT와 LLM을 중심으로 최적화해야 한다. 강연자는 STT와 LLM이 전체 latency budget의 약 3분의 2를 차지한다고 설명하며, 이 두 계층이 지연 시간 지표를 움직일 수 있는 실질적인 레버라고 말한다. 반대로 encoding이나 일부 네트워크 구간은 물리적 제약에 가까워 큰 폭의 개선 여지가 제한적이다.
또한 co-location은 강력한 최적화 수단으로 언급된다. 한 팀은 모든 모델을 같은 GPU cluster에 배치해 서버 간 network hop을 제거함으로써 약 500ms voice-to-voice를 시연했다고 한다. 그러나 대부분의 개발자가 여러 클라우드 API를 호출하는 현실적인 구성에서는 800ms에서 1300ms 범위에 머물 가능성이 크다. 따라서 실무적으로는 절대 지연을 인간 수준까지 줄이는 것만이 아니라, 턴테이킹을 정교하게 만들어 체감 품질을 끌어올리는 전략이 필요하다.
음성용 LLM 평가는 평균보다 P95가 중요하다
강연자는 2026년 6월 기준으로 음성 에이전트용 LLM benchmark를 수행했으며, 목표는 time-to-first-token 혹은 time-to-first-output을 700ms 아래로 유지하는 것이었다고 설명한다. STT 결과에는 “time to first open”처럼 들리는 표현이 반복되지만, 문맥상 첫 출력 토큰 또는 첫 응답 청크 지연을 의미하는 것으로 해석된다. 이 기준을 넘어서면 전체 응답 시간이 사용자가 체감할 수 있는 한계를 넘기 쉽기 때문에, 음성 에이전트에서는 첫 응답 지연이 특히 중요하다.
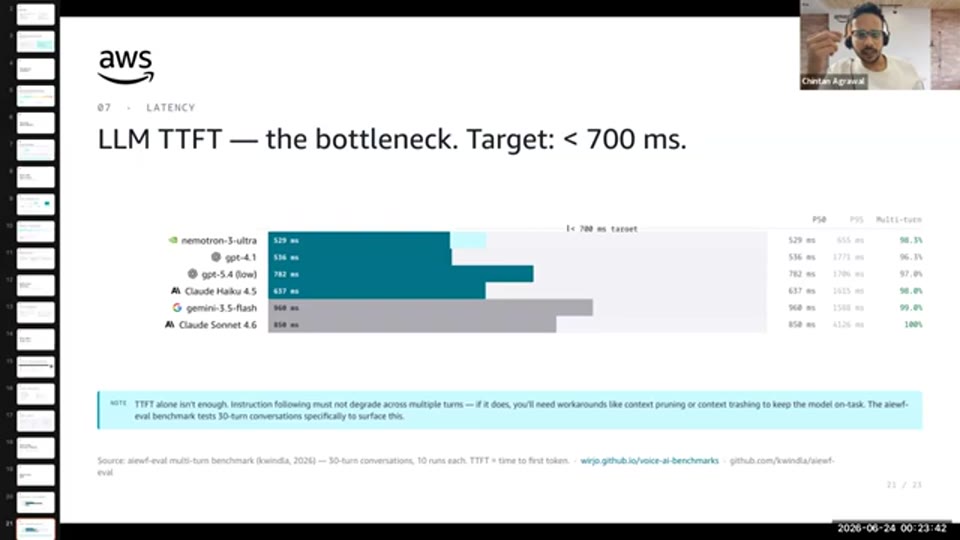
18:57 - 2026년 6월 기준 음성 에이전트용 LLM latency benchmark와 P50, P95 차이를 설명하는 화면
강연에서 언급된 수치에 따르면 Nemotron 3 Ultra는 P50 기준 약 529ms, GPT-4.1은 P50 기준 약 536ms를 보였다. 그러나 Chintan은 평균적 체감에 가까운 P50보다 tail latency인 P95가 더 중요하다고 강조한다. GPT-4.1은 P50에서는 빠르지만 P95에서 약 1.7초까지 튀었고, Claude Sonnet으로 추정되는 모델은 P95가 4초 이상까지 올라갔다고 설명한다. 음성 대화에서는 여러 턴 중 한 번만 느려도 전체 흐름이 무너지기 때문에, 평균이 빠른 모델보다 tail latency가 안정적인 모델이 더 적합할 수 있다.
이 관점은 음성 에이전트 평가 방식 자체를 바꾼다. 텍스트 챗봇에서는 품질, 가격, 평균 latency를 함께 비교하는 경우가 많지만, 음성에서는 P95 지연, multi-turn 안정성, 지시문 준수 지속성이 더 중요해진다. 강연자는 15~20턴 이후 모델이 system prompt 일부를 무시하거나, 지나치게 장황해지거나, 대화 스타일이 흐트러지는 문제가 생길 수 있다고 말한다. 음성에서는 긴 텍스트를 한꺼번에 출력하는 것이 치명적이기 때문에, context pruning이나 session reset 같은 운영 전략도 함께 고려해야 한다.
프로덕션에서는 잘못된 인터럽트가 곧 에스컬레이션 비용으로 이어진다
강연자는 실제 운영에서 관찰한 문제로 false interruption을 지목한다. 에이전트가 사용자의 말을 잘못 끊거나, 단순 맞장구를 정정 요청으로 오해해 자주 멈추면 사용자는 시스템이 자신을 제대로 이해하지 못한다고 느낀다. 그 결과 human-in-the-loop support, 즉 사람 상담원 요청 비율이 올라갈 수 있다. 음성 에이전트의 턴테이킹 품질이 단순한 UX 문제가 아니라 운영 비용과 직결되는 이유다.
또한 강연자는 cascaded pipeline에서 측정된 우수한 voice-to-voice 지연도 여전히 인간 대화 속도에는 못 미친다고 설명한다. Salesforce가 2026년 3월 26일 발표한 결과로 언급된 755ms 수준도 인간의 자연스러운 200ms 턴 전환보다 약 4배 느리다. 따라서 “지연을 완전히 없애는 것”은 현실적으로 어렵고, 시스템은 그 지연이 덜 거슬리게 느껴지도록 턴테이킹을 설계해야 한다. 예를 들어 사용자가 아직 말할 가능성이 높을 때는 기다리고, 사용자가 명확히 끝냈을 때는 빠르게 응답하며, 사용자가 정정할 때는 즉시 멈추는 식의 세밀한 정책이 필요하다.
인프라 운영 측면에서도 난도가 높다. 음성 에이전트는 STT, LLM, TTS, VAD, 턴 감지 및 인터럽트 처리처럼 서로 다른 지연 특성과 스케일링 특성을 가진 여러 시스템을 동시에 운영해야 한다. Chintan은 관리형 호스팅으로 Pipecat Cloud를 검토하거나, 엔터프라이즈 배포에서는 AWS reference architecture를 참고할 수 있다고 언급한다. 이는 실험용 데모와 프로덕션 음성 에이전트 사이에 인프라, 관측성, 보안, 컴플라이언스의 간극이 있다는 점을 보여준다.
Daniel의 데모가 보여준 실전 구현 감각
Daniel은 Pipecat 기반 turn detection demo repository를 통해 세 가지 접근을 실제로 실행해 보인다. 첫 번째 예제에서는 Silero VAD를 Pipecat 환경에 통합하는 흐름을 설명하며, confidence trigger, turn end 전 silence duration, minimum audio volume 같은 파라미터를 조정할 수 있다고 말한다. 음성 파이프라인은 Cartesia STT, Anthropic Claude Haiku LLM, Cartesia Sonic 계열 TTS로 구성된 것으로 설명된다. 데모의 travel assistant는 사용자의 여행지를 묻는 간단한 역할을 수행한다.
첫 번째 데모에서 Daniel이 “I’m thinking of going to…”라고 말한 뒤 잠시 멈추자, 에이전트는 사용자가 문장을 끝내지 않았는데도 “I’m all ears. Where are you thinking of heading?”이라고 응답한다. 로그에는 end of turn complete가 찍히며, 그 이유는 stop seconds가 300ms로 설정되어 있기 때문이라고 설명된다. 이 장면은 침묵 기반 VAD가 빠르지만, 사용자의 사고 pause를 문장 종료로 오해할 수 있음을 매우 직관적으로 보여준다.
두 번째 데모에서는 STT 모델에 내장된 turn detection을 사용한다. 같은 “I’m thinking of going to…” 입력에 대해 에이전트는 즉시 답하지 않고 기다리며, 사용자가 “Sydney?”라고 덧붙이자 그때 완성된 턴으로 판단하고 여행 관련 후속 질문을 한다. Daniel은 실전에서는 이 방식에도 silence detection을 함께 넣어야 한다고 말한다. 사용자가 너무 오래 무음 상태에 머물 경우, STT 기반 턴 감지만으로는 에이전트가 끝없이 기다릴 수 있기 때문이다.
세 번째 데모에서는 로컬 Smart Turn 모델을 사용한다. “I’m thinking of going to…”처럼 미완성 문장에서는 end of turn state가 incomplete로 표시되지만, silence fallback 때문에 결국 다음 턴으로 넘어간다. 반면 “I’m actually thinking of going to Sydney”처럼 완성된 문장에서는 Smart Turn 모델이 높은 확률로 complete를 판단하고, 에이전트가 즉시 응답한다. 이 데모는 VAD timer와 Smart Turn 판단을 결합하는 하이브리드 방식이 왜 현실적인 타협점인지 잘 보여준다.
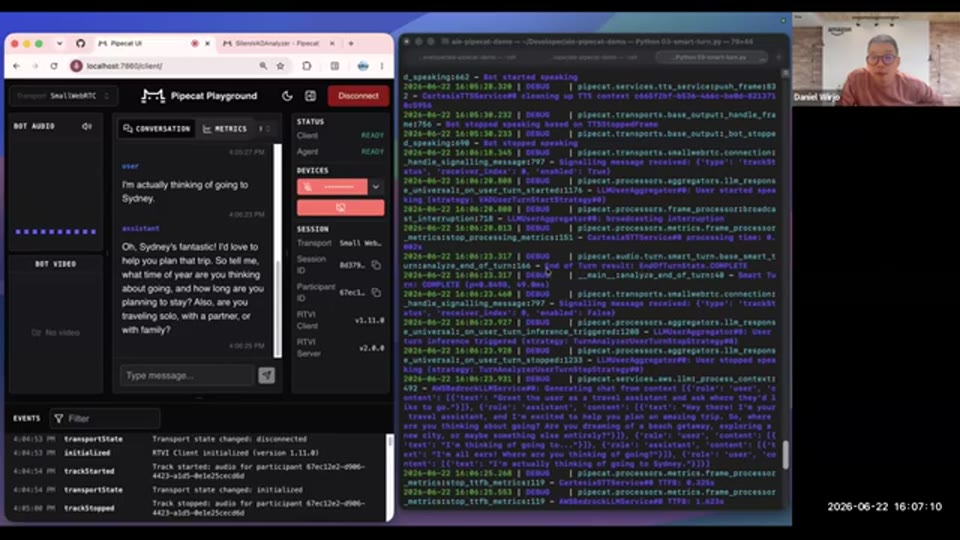
32:18 - Smart Turn 모델이 end of turn state를 complete로 분류하고 문장 완료 확률을 판단한 debug log 화면
마무리 / 핵심 정리
이 강연의 핵심은 음성 에이전트의 품질이 LLM 하나로 결정되지 않는다는 점이다. 사용자가 말을 끝냈는지, 아직 생각 중인지, 단순히 맞장구를 친 것인지, 실제로 에이전트 발화를 끊고 정정하려는 것인지를 구분하지 못하면 아무리 좋은 모델을 붙여도 대화는 부자연스럽게 느껴진다. 특히 인간 대화의 턴 전환 속도가 약 200ms라는 기준을 고려하면, 현재의 cascaded voice pipeline은 구조적으로 느릴 수밖에 없고, 이 간극을 메우는 핵심 장치가 바로 턴테이킹과 인터럽트 처리다.
Silero VAD 기반 접근은 단순하고 제어 가능하지만 침묵의 의미를 이해하지 못한다. STT 제공자 기반 접근은 더 풍부한 신호를 활용할 수 있지만 내부 판단이 불투명하다. Smart Turn을 결합한 접근은 로컬 제어권과 의미 기반 판단을 함께 추구하며, 아직 완벽하지는 않지만 현재 배포 가능한 현실적인 방향으로 제시된다. 결국 프로덕션 음성 에이전트의 설계자는 LLM benchmark뿐 아니라 P95 latency, multi-turn drift, false interruption, fallback timer, 인프라 co-location까지 함께 고려해야 한다.
이 강연은 음성 에이전트를 “말하는 챗봇”이 아니라 “실시간 오디오 시스템”으로 보게 만든다. 텍스트 기반 에이전트에서는 답변 품질과 추론력이 중심이었다면, 음성 기반 에이전트에서는 타이밍, 침묵, 끼어들기, 중단, 재개가 동등하게 중요해진다. 따라서 앞으로의 경쟁력은 더 큰 모델을 붙이는 것뿐 아니라, 사용자가 자연스럽게 말하고 멈출 수 있도록 대화의 리듬을 설계하는 데서 나올 가능성이 크다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Voice Agents That Handle Interrupts - Chintan Agrawal and Daniel Wirjo, AWS |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-20 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.