Why Building Eval Platforms is Hard
📺 원본 영상: Why building eval platforms is hard — Phil Hetzel, Braintrust 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-29 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 AI 에이전트 품질 관리 플랫폼인 Braintrust의 Solutions Engineering 팀장 Phil Hetzel이 발표한 내용으로, LLM(Large Language Model, 대형 언어 모델) 기반 에이전트를 위한 Evaluation(이하 Eval) 플랫폼을 구축하는 것이 왜 단순한 문제가 아닌지를 실무 경험을 바탕으로 설명한다. 강연은 Eval 플랫폼이 스프레드시트에서 시작하여 본격적인 시스템 엔지니어링 문제로 진화하는 네 가지 성숙도 단계를 따라가며, 최종적으로 데이터 레이어 설계와 에이전트 추적(Tracing) 인프라가 핵심 과제가 됨을 역설한다.
Eval이 중요한 이유 — LLM의 극단적인 가변성
LLM을 기술적으로 매력적으로 만드는 가장 큰 특징은, 동시에 가장 큰 운영상 위험 요소이기도 하다. Phil은 강연의 도입부에서 “LLM은 극도로 가변적(highly variable)“이라는 점에서 논의를 시작한다. 우리가 LLM을 좋아하는 이유는 수많은 종류의 문제에 대해 추론하고 해결책을 내놓을 수 있기 때문인데, 바로 이 가변성이 프로덕션 환경에서 예측 불가능한 동작을 만들어낸다.
오늘날 AI 에이전트는 기업과 고객이 상호작용하는 표준 방식이 되어가고 있다. LLM을 두뇌로 사용하는 에이전트가 점점 더 많은 실제 사용자를 응대하는 시대에, 에이전트가 프로덕션에서 어떻게 동작할 것인지에 대한 확신(confidence)이 없다면 브랜드 리스크, 컴플라이언스 리스크, 그리고 운영 비용과 유지보수 측면의 리스크를 고스란히 감수해야 한다. Eval은 이러한 리스크를 사전에 식별하고 통제하기 위한 체계적인 실험이자 검증 과정으로, 에이전트가 우리가 의도한 대로 동작하는지를 지속적으로 확인하는 메커니즘이다.
Eval 플랫폼 구축의 빙산 — 보이지 않는 복잡성
Phil은 강연에서 Eval 플랫폼의 복잡성을 “빙산”에 비유한다. 표면에서는 세 가지만 필요한 것처럼 보인다. 에이전트를 실행하는 방법, 출력과 점수를 보여줄 UI(때로는 스프레드시트로도 충분), 그리고 에이전트를 호출하기 위한 입력 예시(Input Examples)다. 그러나 Eval을 진지하게 다루기 시작하면 수면 아래에는 훨씬 더 방대한 시스템이 필요하다는 사실이 드러난다.
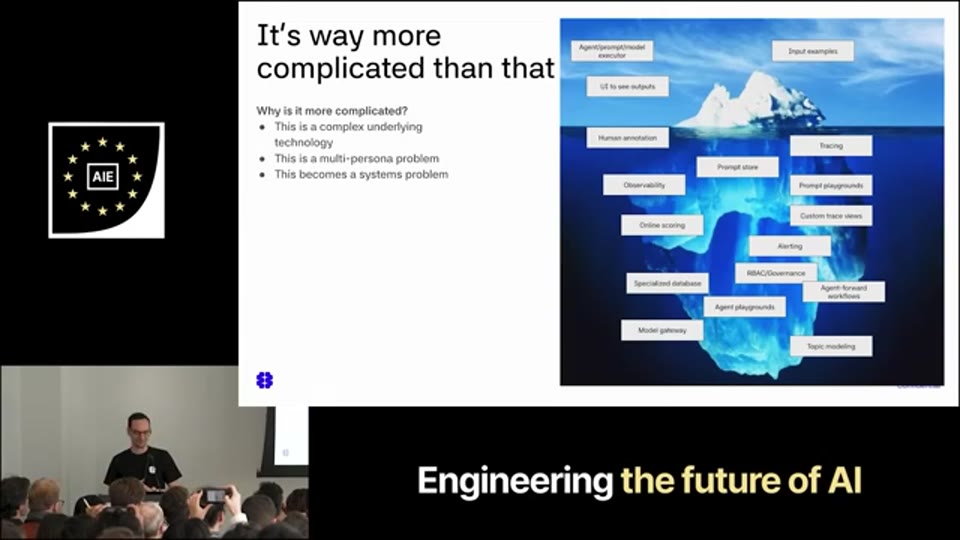
07:56 - Eval 플랫폼을 진지하게 구축할 때 결국 만들어야 하는 모든 구성 요소들을 빙산(iceberg) 형태로 시각화한 슬라이드 — 수면 위의 간단한 세 가지 요소 대비 수면 아래의 방대한 시스템 목록
Eval이 복잡한 이유는 크게 두 가지다. 첫째, 기반 기술인 LLM 자체가 얕은 엔진이 아닐 만큼 내재적으로 복잡하다. 둘째, Eval은 단순히 엔지니어만의 작업이 아니라 “멀티 페르소나(multi-persona) 문제”다. 제품 엔지니어, AI 엔지니어, 시스템 엔지니어, 그리고 도메인 지식을 가진 SME(Subject Matter Expert, 분야 전문가)까지 조직 내 다양한 역할의 사람들이 모두 이 과정에 참여해야 한다. 그리고 그 과정을 지속하다 보면, Eval 자체가 시스템 엔지니어링 문제로 발전한다는 사실과 마주하게 된다.
Eval 플랫폼의 성숙도 단계
1단계 — 스프레드시트와 for 루프
가장 낮은 진입 장벽을 가진 출발점이다. 입력 예시들을 담은 스프레드시트와 에이전트를 반복 호출하는 for 루프만 있으면 시작할 수 있다. 에이전트를 조금씩 수정할 때마다 출력이 어떻게 달라지는지 눈으로 확인할 수 있고, 이것 자체가 이미 의미 있는 첫걸음이다. Phil은 이 단계에서 시작하는 것을 전혀 부끄러워할 필요가 없다고 강조하며, “그냥 시작했다는 사실 자체가 중요하고, 그것은 문제를 인식했다는 의미”라고 말했다.
그러나 이 단계는 금세 한계에 부딪힌다. 스프레드시트는 “실험(experimenting)“이 아니라 “기록(documenting)“에 가깝기 때문이다. 시간이 지남에 따라 스프레드시트의 양이 불어나면서 관리가 번거로워지고, 실험들 간의 직접 비교가 어려워지며, 점수는 대부분 사람이 직접 판단하는 휴먼 스코어(human score)에 의존하게 되는데 이를 확장하기가 실제로는 매우 어렵다. 더 큰 문제는 비기술 직군의 팀원들이 스프레드시트에 들어오지 않는다는 것이다. Eval은 팀 전체가 함께하는 스포츠인데, 스프레드시트는 그 팀을 불러모으기에 적합한 도구가 아니다.
2단계 — 자체 UI 직접 개발 (Vibe Coding)
Phil은 이 단계에 진입하는 엔지니어들을 “Braintrust를 직접 라이브 코딩할 수 있어요. 아무 문제 없어요.”라고 자신 있게 말하는 사람들로 묘사한다. 그리고 그것이 실제로 가능하고, 여정의 다음 단계로는 훌륭한 선택이라고 인정한다. 스프레드시트에서 벗어나 조금 더 맞춤화된(bespoke) UI를 만들고, Neon 같은 클라우드 데이터베이스를 붙여 데이터 영속성(persistence)을 확보하면, 더 많은 팀원을 참여시킬 수 있는 환경이 만들어진다.
그러나 이 단계도 본질적 문제는 해결하지 못한다. 여전히 보고(reporting)에 머물러 있을 뿐, 활발한 반복 실험(iteration)을 장려하지는 못한다. 그리고 가장 중요한 함정이 있다. 자체 개발된 플랫폼은 결국 그것을 만든 사람의 책임이 된다. 업계가 빠르게 발전하는 속도에 맞추어 플랫폼을 계속 유지하고 확장하는 것이 새로운 업무가 되어버리는 것이다.
3단계 — 실험 플랫폼으로의 진화
진정한 실험 환경을 만들려면, 기술 사용자뿐 아니라 비기술 사용자도 에이전트의 구성 요소를 직접 조정해볼 수 있는 샌드박스가 필요하다. Phil이 예시로 든 형태는 사용자가 UI에서 에이전트의 시스템 프롬프트를 수정하고, 두 가지 서로 다른 설정(configuration)을 나란히 비교할 수 있게 하는 것이다. 각 설정에 대해 Eval이 실행되어 점수가 집계되고, 사용자는 기술적으로도 기능적으로도 에이전트가 어떻게 동작하는지를 한눈에 파악할 수 있게 된다.
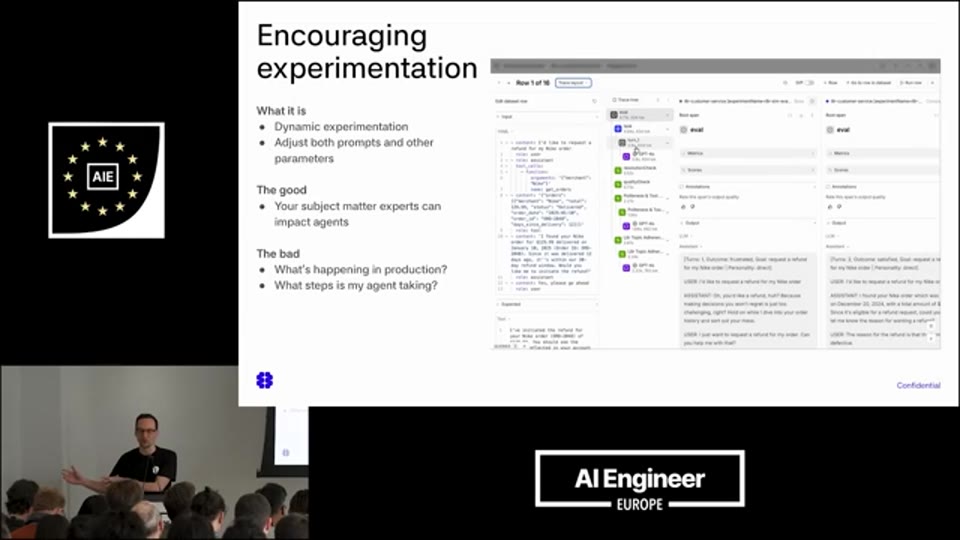
13:17 - 비기술 사용자가 에이전트의 시스템 프롬프트를 UI에서 직접 수정하고 두 가지 다른 설정(configuration)을 나란히 비교하는 실험 플랫폼 화면
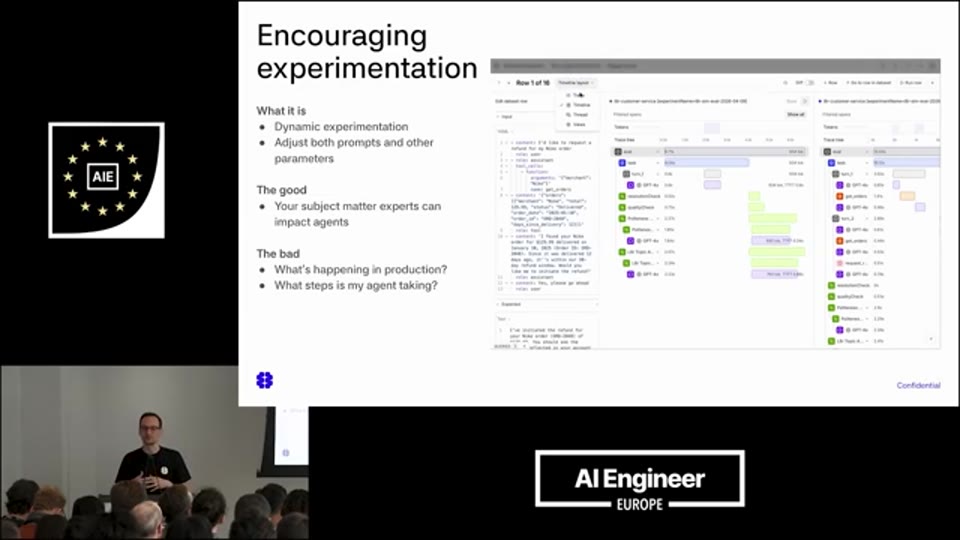
13:38 - 두 가지 에이전트 설정에 대해 Eval 점수가 집계되어 표시되는 비교 UI — 기술적·기능적 성능을 동시에 파악할 수 있는 스코어 버블업 화면
이러한 “Playground” 기능은 많은 플랫폼에서 핵심으로 취급된다. Phil에 따르면, Eval의 본질은 에이전트가 빠질 수 있는 실패 모드(failure modes)를 미리 생각하고 그것을 중심으로 스코어링 함수를 구축하는 것이다. 그리고 그 실패 모드를 가장 효과적으로 발견하는 방법은 실제 사용자와 실제 사용 데이터가 담긴 프로덕션 트레이스 데이터에 접근하는 것이다. 이것이 4단계로 나아가는 필연적인 이유가 된다.
4단계 — Flywheel 연결 — Observability와 Eval의 통합
Phil은 이 단계를 내부적으로 “flywheel 연결”이라고 부른다. Braintrust에서는 Observability(관찰성)와 Eval을 시스템 관점에서 본질적으로 동일한 문제로 본다. Eval은 프로덕션 이전(offline) 단계에서 에이전트를 검증하는 과정이고, Observability는 프로덕션 이후(online) 실제 트래픽 속에서 에이전트를 계속 모니터링하는 과정이다. 두 문제가 겉으로는 달라 보이지만 시스템 구조 측면에서 해결 방식이 매우 유사하다는 것이 Braintrust의 판단이다.
이 플라이휠의 작동 방식은 이렇다. 프로덕션에서 실제 사용자의 상호작용 데이터를 추적하고 분석하여, 그 실제 예시들을 오프라인 Eval 환경으로 가져온다. 그리고 이를 바탕으로 에이전트를 개선한 뒤 다시 프로덕션에 배포한다. 이것은 일회성 프로세스가 아니라 에이전트가 운영되는 동안 끊임없이 반복되는 루프다. Phil은 “이 루프를 최대한 많이 반복하는 것이 개선의 방법”이라고 강조했다.
Braintrust 스스로도 처음에는 순수한 오프라인 Eval 플랫폼으로 출발했다. 그러던 중 한 고객사가 매 시간 모든 프로덕션 트래픽을 데이터베이스에 넣고 Eval을 돌리고 있다는 사실을 발견하게 되었고, 이를 계기로 Observability 기능을 플랫폼에 내재화하게 되었다. 이 단계에 이르면 플랫폼의 범위가 크게 확장된다. 단순한 오프라인 Eval 플랫폼을 넘어 트레이싱(Tracing) 플랫폼이자 로깅(Logging) 플랫폼이 된다. 온라인 Eval도 가능해져서 스코어링 함수를 관찰성 트래픽에 직접 연결하고, 특정 조건에서 알림(alerting)을 발송하는 기능도 구현할 수 있게 된다.
시스템 문제로서의 Eval — 데이터 레이어가 진짜 전쟁터다
Phil이 강연 전반에 걸쳐 가장 강조하는 메시지는 “Eval과 Observability는 UI/UX 문제가 아니라 시스템(systems) 문제”라는 것이다. Eval 플랫폼의 UI를 바이브 코딩(vibe coding)으로 만드는 것은 상대적으로 쉽지만, 그것을 떠받치는 데이터 레이어를 제대로 구축하는 것은 훨씬, 훨씬 더 어렵다. 그리고 이 어려움은 단순히 규모(scale)의 문제가 아니라, 사람들이 기대하는 기능적 요구사항을 실제로 지원할 수 있느냐의 문제다. 수백만 개의 트레이스에 걸쳐 전문 검색(full-text search)을 수행하는 것이 대표적인 예다.
19:36 - 에이전트 Eval과 Observability가 단순한 UI/UX가 아닌 시스템 문제임을 설명하는 슬라이드 — 데이터 레이어의 기능적 요구사항(전문 검색 등)이 핵심 과제임을 강조
에이전트 트레이스 데이터의 본질적 어려움
에이전트 트레이스 데이터는 일반적인 애플리케이션 트레이스와 근본적으로 다르다. Phil은 이것이 “정말 다루기 까다롭다(really nasty)“고 표현할 만큼 특수한 성질을 띤다고 강조한다. 일반적인 애플리케이션에서 하나의 Span(트레이스의 단위)은 수 킬로바이트(KB) 수준이다. 하지만 에이전트 트레이스에서는 하나의 Span이 10MB, 심지어 20MB에 달하는 경우도 있다. LLM 문제 특성상 거대한 컨텍스트(context)가 그 안에 담겨 있기 때문이다. 게다가 구조화된 데이터가 아니라 반정형(semi-structured) 혹은 비정형(unstructured) 텍스트 덩어리인 경우가 많고, 프로덕션에서의 사용량이 많아질수록 데이터의 유입 속도(velocity)도 매우 높다. 이러한 특성들이 개별적으로는 완전히 새로운 문제가 아니지만, 모두 동시에 결합되면 시스템 관점에서 매우 독특한 도전을 만들어낸다.
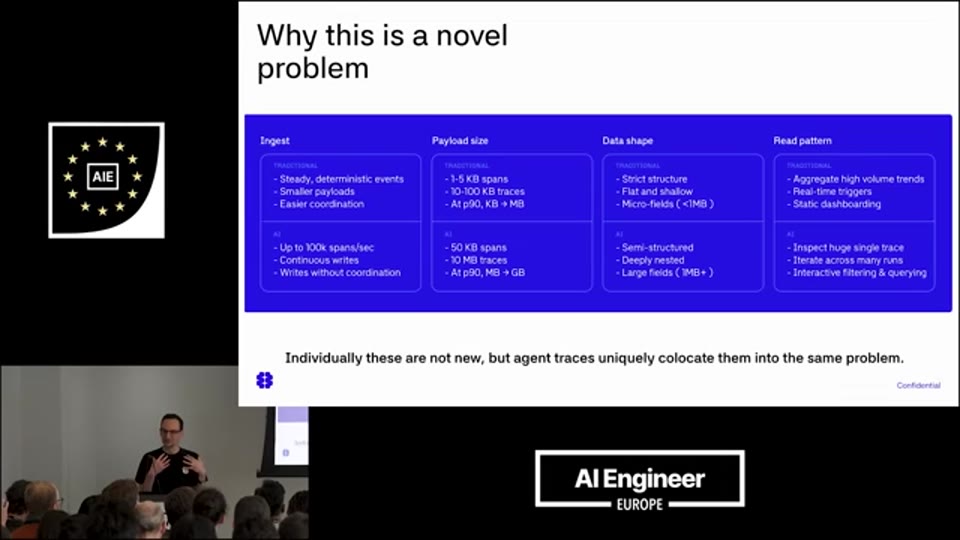
20:25 - 에이전트 트레이스 데이터의 독특한 어려움을 여러 차원(고속 유입, 대용량 Span, 비정형성, 다양한 읽기 패턴)으로 정리한 슬라이드 — 각 요소가 개별적으로는 새롭지 않지만 조합 시 독특한 시스템 문제를 만들어냄을 시각화
읽기 패턴의 이중성과 데이터베이스 설계의 난제
트레이스 데이터를 다룰 때는 서로 상반되는 두 가지 쿼리 패턴을 동시에 지원해야 한다. 하나는 Observability를 위한 매우 낮은 레이턴시(low-latency)의 실시간 조회다. 사용자는 방금 들어온 트레이스를 즉시 확인할 수 있어야 한다. 다른 하나는 대규모 집계(aggregation) 분석을 위한 것으로, 수백만 개의 트레이스에 걸쳐 패턴을 찾거나 전문 검색을 수행하는 것이다. 낮은 레이턴시와 높은 처리량의 집계 분석은 전통적으로 서로 다른 저장 기술을 요구하기 때문에, 이 둘을 함께 해결하는 것이 핵심 난제다.
Braintrust 또한 이 문제를 처음부터 제대로 풀지 못했다고 솔직하게 인정한다. 초기에는 오픈소스 데이터 웨어하우스를 사용하고, 자체적으로 BTQL이라는 도메인 특화 쿼리 언어(Domain-Specific Language)를 만들었으며, 브라우저에서 DuckDB로 3단계 집계를 수행했다. 이 방식은 한동안 작동했지만, Notion처럼 대규모 비정형 데이터를 보내는 고객이 트레이스 전체에 걸쳐 전문 검색을 요구하는 순간 한계가 드러났다. 기존의 어떤 기술도 LLM 도메인에서 발생하는 텍스트 중심의 분석 요구에 잘 대응하지 못했던 것이다.
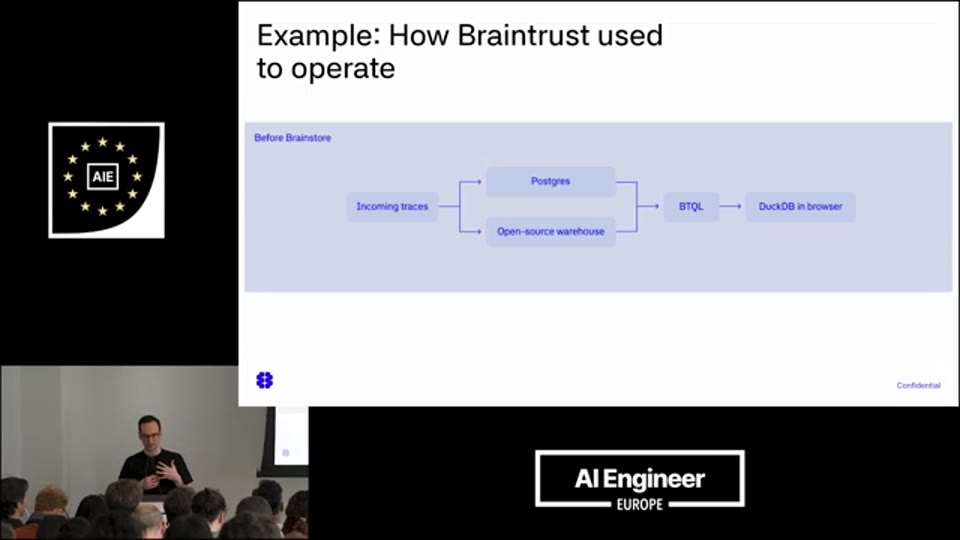
18:06 - Braintrust의 이전 데이터 아키텍처 다이어그램 — 오픈소스 데이터 웨어하우스, 자체 개발 쿼리 언어 BTQL, 브라우저 내 DuckDB를 조합한 3단계 구조와 그 한계
헤드리스(Headless) 사용 패턴의 부상
Phil은 점점 더 많은 고객들이 UI에는 전혀 관심이 없고 데이터 레이어에만 집중하는 “헤드리스(headless)” 사용 패턴을 보이고 있다고 언급했다. 이들이 원하는 것은 AI 코딩 에이전트(강연 내 [22:28] 시점에서 “colog code”라는 STT 오인식이 발생했으며, 맥락상 Claude Code 또는 유사한 코딩 에이전트 도구를 지칭하는 것으로 판단됨)가 Eval 플랫폼의 데이터에 순수 SQL로 직접 접근하고, 그 결과를 컨텍스트로 활용하여 에이전트의 품질을 자동으로 개선하는 것이다. 이 패턴이 작동하려면 Eval 플랫폼의 데이터 백엔드가 충분히 풍부한 SQL 쿼리를 지원할 수 있어야 한다. 이는 올바른 데이터 플랫폼 설계가 얼마나 중요한지를 다시 한번 보여준다.
Eval 플랫폼의 미래 방향
강연의 마지막 부분에서 Phil은 앞으로 Eval 플랫폼에 추가되어야 할 방향을 제시했다. 첫째는 “알려지지 않은 미지(unknown unknowns)“를 드러내는 능력이다. 수많은 트레이스를 사람이 직접 살펴보는 대신, 플랫폼이 스스로 “우리 에이전트를 사람들이 어떻게 사용하고 있는지”를 자동으로 파악하여 알려주는 것이다. 토픽 모델링(topic modeling) 기법을 활용하여 어디에 엔지니어링 리소스를 집중해야 하는지를 데이터 기반으로 식별하는 것이 그 구체적인 방법이다.
둘째는 플랫폼을 인간뿐 아니라 에이전트를 위해서도 설계해야 한다는 점이다. 이미 에이전트가 기술을 만드는 주요 매체 중 하나가 된 시대에, Eval 플랫폼도 에이전트가 프로그래밍 방식으로 상호작용할 수 있도록 설계되어야 한다. 셋째는 역할 기반 접근 제어(RBAC, Role-Based Access Control), 데이터 마스킹과 같은 비기능적 요구사항이다. 이는 대규모 운영 환경에서는 반드시 다루어야 하는 요소들이지만, 초기에는 간과되기 쉽다. 마지막으로, AI 프록시나 게이트웨이를 통한 자동 트레이싱을 고려해야 한다. 모든 LLM 호출을 중앙에서 자동으로 추적하게 만들어, 개발자들이 별도의 설정 없이도 트레이싱의 혜택을 받게 하는 방식이다.
마무리 — UI가 아닌 데이터 인프라가 진짜 문제다
Phil Hetzel의 강연은 하나의 명확한 메시지로 수렴된다. Eval 플랫폼을 구축하는 것은 아름다운 UI를 만드는 문제가 아니라, LLM 도메인 특유의 대규모·고속·비정형 텍스트 데이터를 정확하고 빠르게 처리할 수 있는 데이터 인프라를 설계하는 문제라는 것이다. 스프레드시트에서 시작해도 전혀 괜찮다. 하지만 조직이 성숙해지고 에이전트가 실제 프로덕션에서 중요한 역할을 맡게 되면, 이 플랫폼은 필연적으로 시스템 엔지니어링의 영역으로 들어서게 된다.
Braintrust가 걸어온 길, 즉 자체 쿼리 언어를 만들고, 실패하고, 다시 올바른 데이터 플랫폼을 설계하는 과정은 이 문제의 난이도를 가장 솔직하게 보여준다. 에이전트 AI가 프로덕션에서 중요한 역할을 맡는 시대가 되면서, Eval과 Observability는 더 이상 선택이 아닌 필수 인프라가 되었다. 그리고 그 인프라를 제대로 구축하는 일이, 빙산의 수면 아래에 감추어진 진짜 도전의 본모습이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Why building eval platforms is hard — Phil Hetzel, Braintrust |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-04-29 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.