You Might Not Need 50 Diffusion Steps
📺 원본 영상: You Might Not Need 50 Diffusion Steps — Ziv Ilan, Nvidia 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-17 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
NVIDIA AI Labs 소속의 Ziv Ilan은 파리를 거점으로 다양한 프런티어 모델 빌더들과 협업하며 확산(Diffusion) 모델 생태계를 연구하고 있다. 이 강연에서 그는 확산 모델이 이미지·영상 생성에서 이미 뛰어난 품질을 입증했음에도 불구하고, 실제 개발자 혹은 기업 환경에서 활용하기 위해서는 반드시 넘어야 할 지연 시간(latency)의 벽이 존재함을 지적한다. 그 벽을 허무는 세 가지 핵심 도구—양자화(Quantization), 캐싱(Caching), 증류(Distillation)—를 실용적인 관점에서 소개하며, 궁극적으로 단일 GPU 위에서 실시간 영상 생성을 달성한 사례를 공유한다.
확산 모델, 왜 실용화가 어려운가
확산 모델의 작동 원리는 자기회귀(Autoregressive) 방식의 LLM과 근본적으로 다르다. LLM이 토큰을 한 번에 하나씩 순차적으로 생성하는 반면, 확산 모델은 무작위 노이즈에서 시작하여 이를 점진적으로 제거해 나가는 디노이징(Denoising) 과정을 통해 이미지나 영상을 만들어낸다. 이 디노이징 과정이 통상 20~50 스텝에 걸쳐 반복된다는 것이 문제의 핵심이다. 한 장의 고품질 이미지를 얻기 위해서도 상당한 연산이 필요한데, 1080p 혹은 720p 해상도의 영상이라면 그 부담은 몇 배로 커진다.
Ziv Ilan에 따르면, 확산 모델 생태계는 최근 들어 눈에 띄게 성숙하고 있다. 이미지 생성 분야에서는 Flux 2(Black Forest Labs), 영상 생성 분야에서는 LTX Video, Google의 영상 생성 모델 계열1 등 높은 품질의 오픈소스 모델들이 속속 등장하고 있다. 그러나 모델의 품질이 아무리 뛰어나더라도 생성에 수십 초가 소요된다면, 로봇공학을 위한 월드 모델, 게임 내 실시간 콘텐츠 생성, 스트리밍 영상 제작과 같은 실제 사용 사례에는 적용하기 어렵다. 이것이 바로 이 강연이 던지는 핵심 질문이다. “우리는 정말로 50 스텝이 모두 필요한가?”
Ziv Ilan이 제시하는 해법은 LLM 생태계에서 이미 검증된 최적화 개념들을 확산 모델 세계로 이식하는 것이다. 그는 세 가지 기법을 단순한 것부터 복잡한 것 순서로, 즉 양자화 → 캐싱 → 증류의 순서로 설명한다. 다만 실제 배포 순서는 반대이거나 혼합될 수 있음을 미리 강조한다.
첫 번째 도구: 양자화 (Quantization)
양자화는 세 가지 도구 중 가장 진입 장벽이 낮다. LLM에서 양자화를 경험해본 개발자라면 확산 모델에서도 개념적으로 유사한 접근이 가능하다. 핵심은 모델의 가중치(Weight)와 활성화(Activation) 값을 더 낮은 비트 정밀도로 표현함으로써 메모리 사용량과 연산 비용을 줄이는 것이다.
양자화에는 크게 두 가지 접근이 있다. 학습 후 적용하는 PTQ(Post Training Quantization)와 학습 과정에 통합하는 QAT(Quantization Aware Training)가 그것이다. Ziv Ilan은 많은 경우 PTQ로 시작하는 것이 현실적이라고 말하면서도, 확산 모델의 경우 이미지 품질을 유지하는 것이 LLM보다 까다롭다는 점을 덧붙인다. 또한 확산 모델은 LLM보다 어텐션(Attention) 연산의 비중이 상대적으로 높아서, 양자화로 얻을 수 있는 속도 향상이 LLM만큼 극적이지 않을 수 있다. 그럼에도 불구하고, 최신 Blackwell 아키텍처 GPU가 제공하는 고급 기능을 활용하기 위한 ‘낮은 열매(Low-hanging Fruit)‘로서의 가치는 충분하다.
Black Forest Labs와의 협업으로 FLUX 2 모델에 양자화를 적용한 사례에서는 동적 양자화(Dynamic Quantization) 방식을 사용했다. 정적 양자화가 모든 파라미터의 범위를 사전에 계산해두고 고정된 범위를 사용하는 반면, 동적 양자화는 일부 범위를 실시간으로 계산한다. 이를 통해 모델이 실제로 접하는 다양한 데이터 분포에 더 잘 적응할 수 있다는 것이 장점이다.
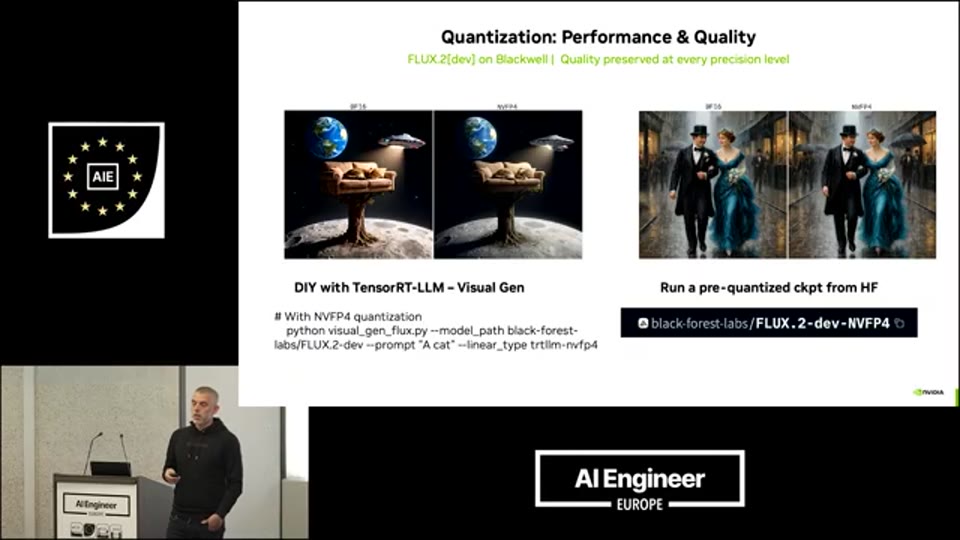
04:43 - Black Forest Labs와의 협업으로 FLUX 2 모델에 동적 양자화를 적용한 결과 및 방법론 설명 슬라이드
양자화가 가져오는 효과는 두 가지 축으로 나뉜다. 첫째로 메모리 절감인데, 이는 소비자용 GPU나 낮은 등급의 데이터센터 GPU에서도 모델을 실행할 수 있게 해준다. 둘째로 추론 성능 향상이다. NVIDIA는 이를 지원하기 위해 TensorRT-LLM Visual Gen 오픈소스 레포지토리에 예제를 공개했으며, 파트너사와 협력하여 HuggingFace에서 바로 내려받아 사용할 수 있는 **사전 양자화 체크포인트(Pre-quantized Checkpoint)**도 제공하고 있다. 별도의 파인튜닝이나 어댑터 작업이 필요 없다면 이 체크포인트를 그대로 활용하는 것이 가장 편리하다. 강연 당일 기준, 어텐션 연산에 FP4 정밀도를 적용하는 최신 연구 결과도 확인했다고 Ziv Ilan은 언급한다.
두 번째 도구: 캐싱 (Caching)
LLM 세계의 KV 캐시(KV Cache)는 이미 생성된 토큰의 Key-Value 연산 결과를 재사용함으로써 추론 속도를 높이는 기술이다. 그런데 확산 모델에는 이 방식을 그대로 적용할 수 없다. 토큰을 순차적으로 생성하는 것이 아니라, 전체 이미지나 영상의 잠재 공간(Latent Space)을 반복적으로 업데이트하는 방식으로 작동하기 때문이다. 따라서 확산 모델을 위한 캐싱은 새로운 관점에서 접근해야 한다.
Ziv Ilan이 소개하는 **T-캐시(T-Cache)**는 이 아이디어를 잘 보여주는 예시다. 20~50번의 디노이징 스텝이 진행되는 동안, 연속된 두 스텝 사이에서 실제로 크게 변화하지 않는 영역이 상당히 많다. T-캐시는 직전 스텝과 비교하여 변화량이 미미한 부분을 감지하고, 해당 부분에 대해서는 다음 스텝에서 재연산을 건너뛰는 방식으로 동작한다. 전체 픽셀 공간 또는 잠재 공간을 대상으로 이 비교를 수행하기 때문에 비교적 단순한 구현이지만, 개념을 이해하는 데 좋은 출발점이 된다.
더 현대적인 캐싱 기법은 청크 기반(Chunk-based) 접근으로 진화한다. Ziv Ilan은 이를 강연장 상황에 비유하여 설명한다. 청중 대부분은 화면을 바라보며 정적인 상태이지만, 연사인 그 자신은 계속 움직이고 있다. 이 경우 영상 전체를 다시 인코딩할 필요 없이 움직임이 있는 연사 부분(청크)만 재연산하면 충분하다는 것이다. 사용자는 이 ‘재연산 트리거’가 되는 변화량 임계값(Threshold)을 직접 조정할 수 있는데, 이 임계값 설정이 캐싱의 효과와 품질 사이의 균형을 결정하는 핵심 변수가 된다.
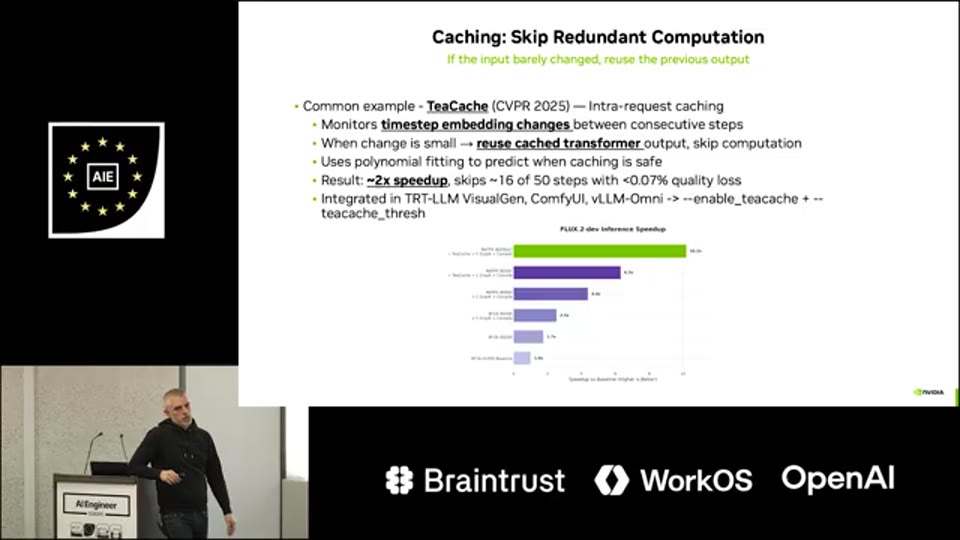
08:30 - 캐싱 기법 적용 시 기대할 수 있는 성능 향상 수치 및 품질 비교 예시 화면
캐싱을 부주의하게 적용하면 이미지 품질에 눈에 띄는 저하가 발생할 수 있기 때문에 주의가 필요하다. 월드 모델이나 콘텐츠 생성과 같이 품질이 핵심인 사용 사례에서는 반드시 성능 향상과 품질 유지 사이의 균형을 검증해야 한다. TensorRT-LLM Visual Gen 레포지토리에서는 하나의 플래그(Flag)를 활성화하고 임계값만 설정하면 캐싱을 실험해볼 수 있으며, vLLM-Omni와 SGLang-Diffusion 등의 서빙 라이브러리에서도 지원된다.
세 번째 도구: 증류 (Distillation)
세 가지 도구 중 가장 복잡하지만 동시에 가장 강력한 영향을 미치는 것이 바로 증류다. “당신은 50 스텝이 필요 없을지도 모른다”는 강연 제목이 가리키는 것이 바로 이 기법이다.
확산 모델에서의 증류는 LLM 세계의 그것과 목표가 다르다. LLM 증류는 주로 큰 모델의 지식을 작은 모델로 전달하여 파라미터 수를 줄이는 것을 목적으로 한다. DeepSeek이 대형 모델로부터 훨씬 작은 모델로 증류하여 수용할 만한 품질을 얻어냈던 사례가 그 대표적인 예다. 반면 확산 모델에서의 증류, 즉 **스텝 증류(Step Distillation)**는 파라미터 수를 줄이는 것이 아니라 디노이징 스텝의 수를 줄이는 것을 목표로 한다. 동일한 파라미터를 가진 학생 모델(Student Model)이 교사 모델(Teacher Model)이 50 스텝에 걸쳐 만들어내는 품질을, 단 4 스텝, 8 스텝, 혹은 극단적인 경우 단 1 스텝으로 달성하도록 훈련하는 것이다.
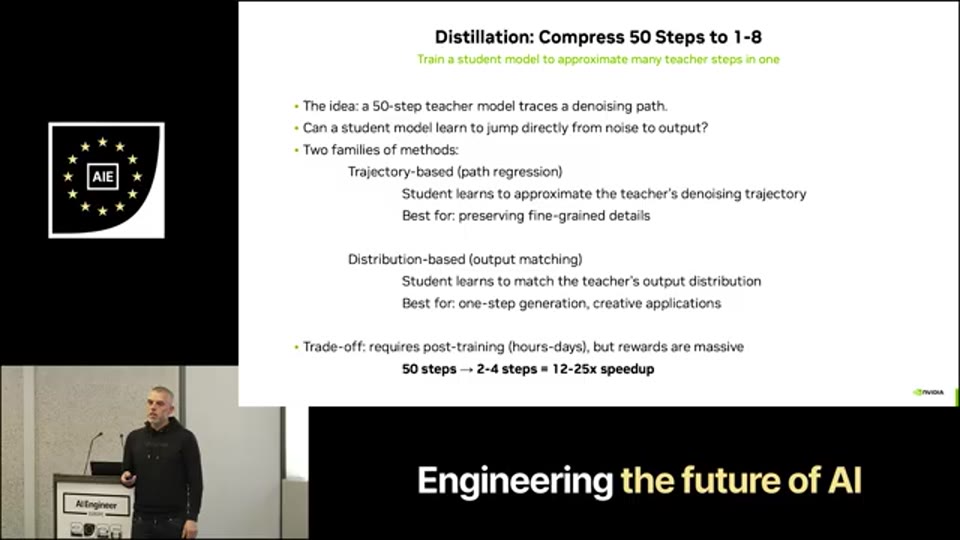
10:18 - 스텝 증류를 통한 10x~200x 성능 개선 가능성 설명 화면
이 스텝 감소가 실현되면 성능은 10배에서 최대 200배까지 향상될 수 있다고 Ziv Ilan은 강조한다. 실시간 영상 생성이라는 목표에 현실적으로 도달할 수 있는 유일한 경로가 바로 여기에 있다는 것이다. 실제로 NVIDIA는 San Jose에서 개최된 GTC 컨퍼런스에서 두 가지 증류 기법을 결합하여 실시간 영상 생성 데모를 선보인 바 있다.
스텝 증류의 접근 방식은 크게 두 가지로 나뉜다. 첫 번째는 궤적 기반(Trajectory-based) 증류로, 학생 모델이 교사 모델의 디노이징 경로를 단계별로 따라가도록 학습한다. 두 번째는 분포 기반(Distribution-based) 증류로, 최종 출력 분포만을 기준으로 삼아 학생 모델이 그 결과에 도달하는 방법을 스스로 터득하도록 한다. 현재 시점에서는 분포 기반 방식이 더 높은 품질을 낸다고 여겨진다. 최근 Fast Video 릴리즈에서는 두 방식을 결합한 하이브리드 접근법을 사용하여 품질과 학습 안정성을 동시에 잡았다.
증류가 마지막에 다루어지는 이유는 그것이 학습 이후(Post-Training) 단계에서 수행되는 기법이기 때문이다. 양자화나 캐싱과 달리, 증류는 데이터와 컴퓨팅 자원, 그리고 상당한 전문성을 요구한다. 아직 연구 주도적인 측면이 강하고 다양한 기법이 계속 등장하고 있는 분야이지만, 최신 오픈소스 모델들을 통해 점점 성숙한 기법들이 공개되고 있는 추세다.
FastGen - NVIDIA의 증류 훈련 프레임워크
증류의 복잡성을 다루기 위해 NVIDIA NV Research 그룹은 FastGen이라는 오픈소스 레포지토리를 공개했다. FastGen은 그 자체가 특정 증류 알고리즘인 것이 아니라, 증류 학습 과정 전체를 구조화하여 관리해주는 프레임워크의 성격을 가진다.
이 프레임워크가 필요한 이유는 최신 영상 생성 확산 모델의 규모에 있다. 현재 많은 모델들이 20B, 30B, 40B 파라미터에 달하고 있으며, 앞으로는 수천억 파라미터 수준으로 성장할 것으로 예상된다. 이런 규모의 모델에 대해 증류 학습을 수행하려면 여러 GPU에 걸친 샤딩(Sharding)과 같은 분산 학습 인프라가 필수다. FastGen은 이 인프라 관리를 대신 처리해주기 때문에, 개발자가 품질 개선과 레시피 조정에만 집중할 수 있게 해준다.
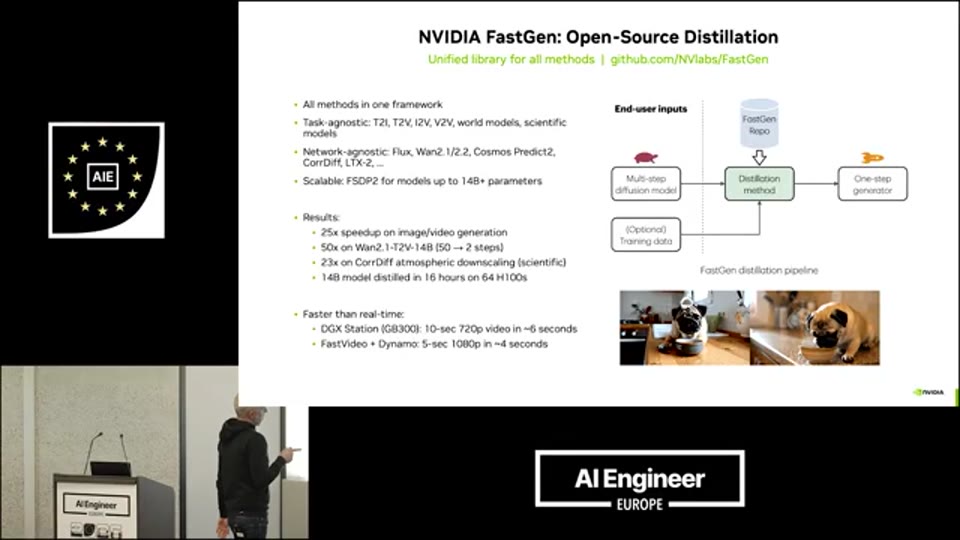
13:39 - FastGen 아키텍처 다이어그램 및 선택적 학습 데이터(Optional Training Data) 흐름도
학습 데이터와 관련하여 Ziv Ilan은 실용적인 조언을 제시한다. 오픈소스 데이터셋만으로도 일반적인 데모 수준의 결과를 얻는 데 충분하며, 실제로 NVIDIA 팀도 그 결과에 만족한다고 밝혔다. 그러나 단백질 구조 시각화처럼 특수한 데이터 분포를 가진 사용 사례라면, 해당 도메인에 특화된 데이터를 활용해야 기대하는 품질에 도달할 수 있다.
FastGen을 사용하여 달성한 성과 중 하나는 GTC에서 공개적으로 시연되었다. 단 한 대의 Blackwell B200 GPU에서 출력 품질 설정에 따라 근접-실시간 혹은 실시간 영상 생성이 가능함을 보였다. 이 시연은 증류가 실시간 생성이라는 목표에 현실적으로 도달하는 가장 직접적인 경로임을 입증한 사례다.
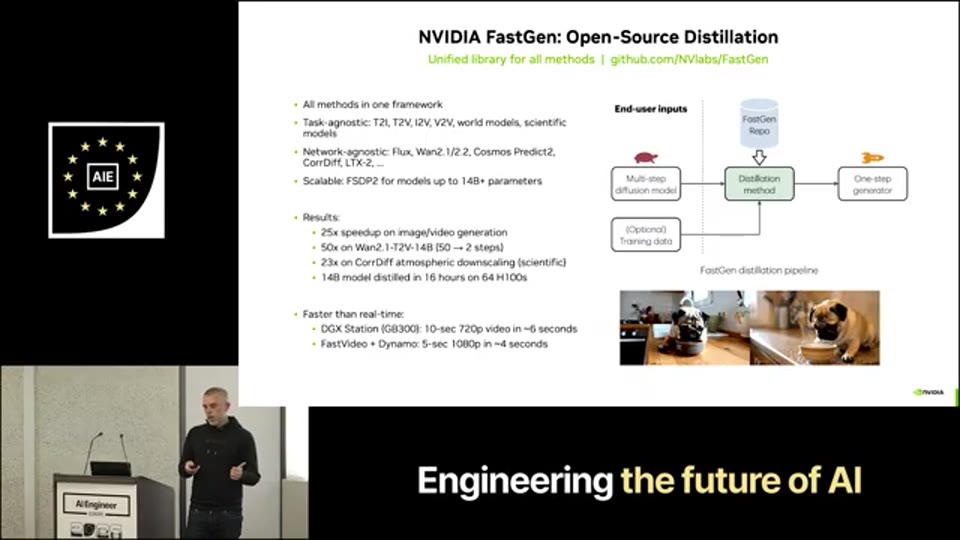
14:09 - GTC 데모 결과: 단일 Blackwell B200 GPU에서의 실시간 영상 생성 성능 수치
점진적 최적화 전략
Ziv Ilan이 강조하는 중요한 관점은 이 세 가지 기법이 상호 배타적이지 않다는 점이다. 세 기법은 모두 **증분적(Incremental)**으로 적용 가능하며, 오히려 조합하여 사용할 때 가장 큰 효과를 낼 수 있다. 강연자가 제안하는 실천적인 접근 순서는 다음과 같다.
우선 양자화부터 시작하는 것이 가장 현실적이다. 구현이 단순하고 TensorRT-LLM Visual Gen의 사전 양자화 체크포인트를 활용하면 별도의 학습 없이 바로 효과를 확인할 수 있다. 이 수준의 최적화만으로도 목표하는 성능이나 품질 요건이 충족된다면 굳이 더 나아갈 필요가 없다. 만약 그것으로 충분하지 않다면, 멀티 GPU 설정에서의 컨텍스트 병렬화(Context Parallelism), 캐싱 기법 추가, 그리고 마지막으로 증류의 순서로 단계적으로 복잡도를 높여나간다. 중요한 것은 모든 단계에서 품질 지표를 함께 추적해야 한다는 점이다. 성능을 얻는 대신 모델이 생성하는 콘텐츠의 품질이 허용 범위를 벗어나서는 안 된다.
Q&A - 컴퓨트와 데이터에 대하여
강연 이후 청중 질의에서 증류 적용에 필요한 컴퓨팅 자원과 데이터셋에 대한 질문이 나왔다. Ziv Ilan의 답변은 현실적이고 안심을 주는 내용이었다. 증류를 수행하기 위해 반드시 GB200 같은 최상위 GPU가 필요한 것은 아니다. H100, H200, B200, B300 등 다양한 세대의 GPU에서 수행할 수 있으며, 사전 훈련(Pre-training)만큼의 막대한 컴퓨팅이 요구되지는 않는다. 물론 단 하나의 인스턴스로 시작하기는 어렵고 여전히 상당한 자원이 필요하다. 모델 크기가 관건인데, 2B 혹은 4B 파라미터 수준의 소형 영상 생성 모델이라면 훨씬 적은 컴퓨팅으로 증류를 수행할 수 있다.
데이터 측면에서는 먼저 평가 방법론을 확립하는 것이 중요하다고 강조한다. 일반 데이터셋을 사용했을 때와 도메인 특화 데이터를 사용했을 때 모델이 어떻게 다른지를 측정할 수 있어야, 자신의 사용 사례에 전용 데이터가 필요한지 아닌지를 판단할 수 있기 때문이다. 일반적인 데모와 광범위한 사용 사례에서는 공개된 오픈소스 데이터셋으로도 충분히 좋은 결과를 낸다는 것이 NVIDIA 팀의 경험에서 나온 결론이다.
마무리 / 핵심 정리
Ziv Ilan의 강연은 확산 모델 최적화라는 기술적 주제를 다루면서도, 결국 하나의 실용적인 메시지로 수렴한다. 실시간 영상 생성이라는 “성배(Holy Grail)“는 이제 하나의 기법만으로는 도달하기 어렵지만, 양자화·캐싱·증류를 층층이 쌓아 적용한다면 오늘날에도 현실로 만들 수 있다는 것이다.
주목할 것은 이 모든 자원이 오픈소스로 공개되어 있다는 점이다. TensorRT-LLM Visual Gen 레포지토리, FastGen, FLUX 2 및 LTX Video 계열 모델들에 대한 지원이 이미 준비되어 있으며, 커뮤니티의 기여와 실험이 이 생태계를 더욱 빠르게 성숙시킬 것이라고 강연자는 기대한다. LLM·VLM 생태계가 지난 몇 년 동안 이룬 성숙도를, 확산 모델 생태계가 훨씬 더 빠른 속도로 따라가고 있다는 것이 그의 낙관적 전망의 근거다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | You Might Not Need 50 Diffusion Steps — Ziv Ilan, Nvidia |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-06-17 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Building Generative Image & Video models at Scale - Sander Dieleman (Veo and Nano Banana)
- Running LLMs locally - Practical LLM Performance on DGX Spark
Footnotes
-
강연자는 이 시점에서 특정 Google 모델을 언급하지만, STT 오인식으로 정확한 모델명을 특정할 수 없습니다. 원본 영상을 참조하세요. ↩