fighting slop with slop — Vaibhav Gupta, Boundary
📺 원본 영상: fighting slop with slop — Vaibhav Gupta, Boundary
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-31
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Vaibhav Gupta는 이 강연에서 AI가 생성한 느슨하고 검증되지 않은 코드, 즉 “slop”이 늘어나는 시대에 어떻게 오히려 AI와 자동화 도구를 이용해 그 slop을 통제할 수 있는지 설명한다. Boundary 팀은 코드 리뷰를 하지 않고, 엔지니어들이 병렬로 작업하며, 특정 AI 도구 사용을 표준화하지 않는다는 다소 급진적인 방식으로 BAML이라는 프로그래밍 언어를 만들어왔다. 그러나 강연의 핵심은 무질서의 방치가 아니라, 사람이 모든 코드를 읽지 않는 현실을 인정한 뒤 아키텍처, 설계 문서, 실행 추적, 타입 시스템, 에이전트 전용 도구를 통해 신뢰 가능한 개발 프로세스를 다시 설계해야 한다는 주장이다.
Slop은 “읽히지 않는 코드”에서 시작된다
강연자는 “slop”을 단순히 AI가 만든 저품질 코드로 한정하지 않는다. 그가 제시하는 정의는 더 근본적이다. slop은 결국 “읽지 않은 코드”이며, 사람이 직접 이해하고 검토하지 않은 채 코드베이스 안으로 들어온 모든 변경이 잠재적 slop이 된다. 이 정의가 중요한 이유는 AI 시대 이전에도 많은 조직이 이미 모든 코드를 완전히 읽고 이해하지 못했다는 사실을 드러내기 때문이다. AI 에이전트가 코드 생산량을 폭발적으로 늘리면서 문제의 규모가 커졌을 뿐, 근본 원인은 개발 프로세스가 코드 이해의 병목을 인간 개인에게 과도하게 의존해왔다는 데 있다.
Boundary의 사례는 이 문제를 극단적으로 보여준다. 이 팀은 약 3년 전 프로그래밍 언어를 만들기로 했고, 프로그래밍 언어는 설계 실수의 비용이 매우 큰 시스템이다. 컴파일러, 타입 시스템, 런타임 경계, 표준 라이브러리 같은 요소는 한 번 잘못 설계하면 몇 달 또는 몇 년 뒤에도 쉽게 되돌릴 수 없다. 그럼에도 강연자는 팀이 코드 리뷰 없이, 엔지니어들이 각자 선호하는 AI 도구를 사용하며, 병렬로 작업하는 방식으로 이 시스템을 만들어왔다고 말한다. 겉으로는 무모해 보이지만, 강연의 논지는 바로 여기서 출발한다. 사람이 모든 코드를 읽는다는 이상을 붙잡는 대신, 읽지 않아도 무너지지 않는 시스템을 설계해야 한다는 것이다.
표준화의 전투: 도구가 아니라 불변 조건을 표준화한다
AI 도구가 빠르게 바뀌는 환경에서 특정 도구를 강제하는 표준화는 오래 버티기 어렵다. 강연자는 어떤 엔지니어는 Claude를 쓰고, 어떤 엔지니어는 Codex를 쓰며, 어떤 엔지니어는 Hacker News에서 방금 발견한 최신 도구를 쓰고 싶어 한다고 설명한다. 우수한 엔지니어일수록 자신에게 맞는 워크플로를 고집하는 경향이 있기 때문에, 팀이 모든 사람에게 동일한 AI 사용 방식을 강요하는 것은 현실적이지 않다. Boundary가 선택한 방식은 도구의 표준화가 아니라, 에이전트와 사람이 공유해야 하는 불변 조건을 문서화하는 것이었다.
그 결과물이 architecture.md 파일이다. 강연자는 Claude.md처럼 특정 모델이나 도구에 종속된 파일 대신, 어떤 모델도 이해할 수 있는 작고 안정적인 아키텍처 문서를 선택했다고 설명한다. 이 문서에는 몇 주마다 바뀌는 세부 구현이 아니라, 몇 달 또는 몇 년 동안 유지될 가능성이 높은 컴파일러의 계층 구조와 핵심 경계가 담긴다. 특히 컴파일러의 더 깊은 계층으로 들어갈수록 에이전트가 독단적으로 변경하지 않고 최소한 한 명 이상의 다른 사람과 논의하도록 유도한다는 점이 흥미롭다. 이 접근은 표준화를 완전히 포기하는 것이 아니라, 변화가 잦은 실행 방식은 자유롭게 두고 변화해서는 안 되는 구조적 원칙만 강하게 고정하는 방식이다.
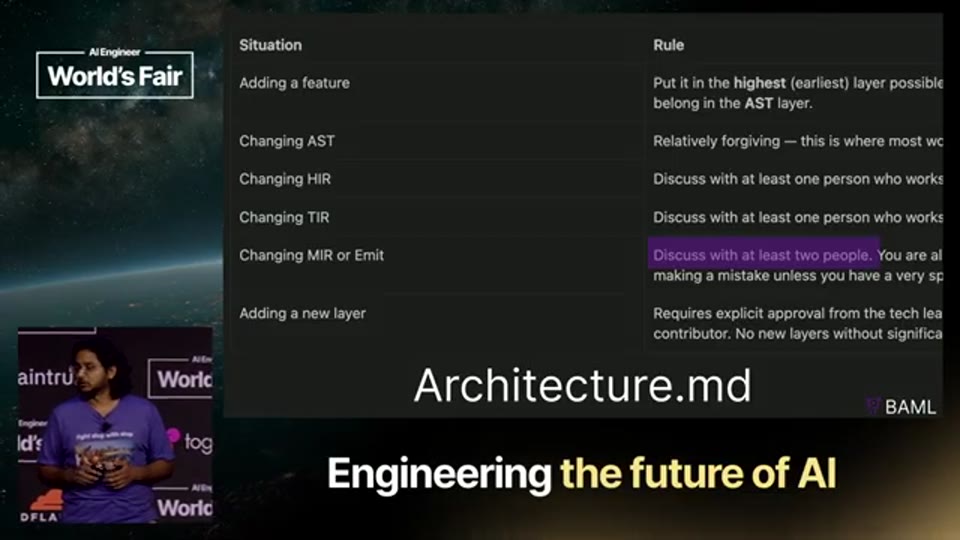
02:24 - architecture.md에 담긴 컴파일러 계층과 에이전트 작업 경계에 대해 설명하는 구간
설계 문서의 전투: 코드는 생성해도 글은 대충 쓰면 안 된다
Boundary 팀의 또 다른 원칙은 “코드는 slop이 될 수 있지만, 글은 slop이 될 수 없다”는 문장으로 요약된다. 여기서 글은 일반적인 문서 작업이 아니라, 시스템 설계의 의도와 판단 근거를 담는 design doc을 의미한다. 코드 자체는 AI가 많이 생성할 수 있지만, 왜 그런 설계를 선택했는지, 어떤 대안을 버렸는지, 장기적으로 어떤 불변 조건을 지켜야 하는지는 사람이 명확한 언어로 설명해야 한다. 강연자의 관점에서 설계 문서는 코드보다 더 오래 남는 의사결정 기록이며, 코드베이스가 병렬 작업 속에서도 수렴하게 만드는 사회적·기술적 장치다.
그러나 좋은 원칙만으로 좋은 문서 문화가 만들어지지는 않는다. 강연자는 팀이 Notion과 GitHub를 대체하는 자체 design doc 도구를 만들었다고 설명한다. 이 도구는 버전 관리, 댓글, 문서 업데이트 같은 기능을 제공하며, 내부적으로는 Markdown 파일과 단순한 CLI 스크립트 위에 구성되어 있다. 중요한 점은 이 구조가 사람뿐 아니라 AI 에이전트도 다룰 수 있는 형태라는 것이다. 문서가 GitHub처럼 다뤄지지만 GitHub 자체에 갇히지 않기 때문에, 에이전트가 문서를 읽고 수정하고 맥락으로 사용할 수 있는 기반이 생긴다.
이후 팀은 이 design doc 시스템 위에 Slack 연동을 추가했다. design doc이 업데이트될 때마다 채널에 알림이 가고, 그 채널은 회사에서 가장 인기 있는 채널이 되었다고 강연자는 말한다. 흥미로운 설계 문서가 올라오면 새벽 2시에도 여러 명이 읽기 시작할 정도였다는 일화는, 문서가 단순한 승인 절차가 아니라 엔지니어링 대화의 중심이 되었음을 보여준다. 다만 강연자는 자신이 하루에 10개의 design doc을 쏟아내는 “AI psychosis”에 빠졌다고도 말한다. 그래서 마지막으로 추가된 규칙은 design doc을 발행하려면 실제로 읽어줄 사람을 확보해야 한다는 것이었다. 문서를 쉽게 만들 수 있게 하는 것만으로는 부족하고, 읽힘과 검토라는 사회적 비용을 다시 연결해야 품질이 유지된다는 의미다.
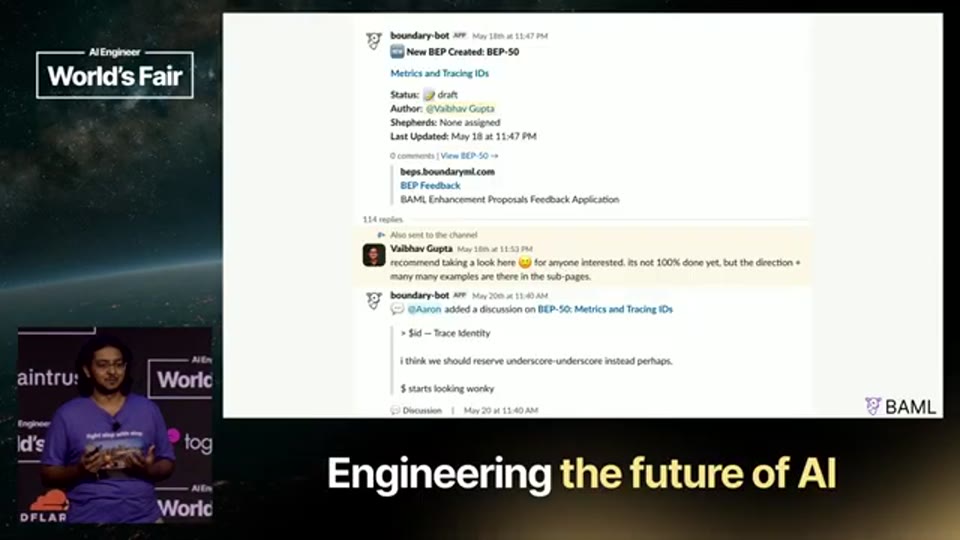
03:15 - design doc 도구와 Slack 연동이 팀 내 문서 읽기 문화를 만든 사례를 설명하는 구간
아키텍처의 전투: 코드베이스를 그래프로 보고 불변식을 강제한다
코드 리뷰가 없다면 아키텍처는 더 쉽게 무너질 수 있다. 개별 변경은 작고 합리적으로 보이더라도, 시간이 지나면서 패키지 간 의존성이 새고, 계층 경계가 흐려지며, 시스템 전체가 특정한 방향 없이 엉키기 때문이다. Boundary는 이 문제를 해결하기 위해 내부 의존성 그래프를 시각화하는 도구를 만들었다. 이 도구는 내부 패키지와 일부 외부 의존성을 함께 보여주며, 코드베이스가 시간에 따라 어떻게 변하는지 관찰할 수 있게 한다.
강연자가 강조하는 부분은 단순한 시각화보다 그 위에 구축한 CLI 도구다. 팀은 특정 아키텍처 불변식이 깨지지 않도록 보장하는 CLI를 만들었고, Claude 같은 에이전트가 새 패키지를 만들거나 부적절한 의존성을 추가하면 CI/CD나 커밋 기록을 통해 어디서 경계가 깨졌는지 확인할 수 있게 했다. 이는 “코드 리뷰어가 눈으로 발견해야 할 문제”를 “시스템이 감지할 수 있는 위반”으로 바꾸는 방식이다. 강연자에 따르면 이런 장치 덕분에 Boundary는 최근 3~4개월 동안 아키텍처를 변경하지 않고 유지할 수 있었다. 여기서 중요한 통찰은 아키텍처를 문서로만 보호하지 않고, 코드베이스의 구조 자체를 측정 가능하고 검증 가능한 대상으로 만든다는 점이다.
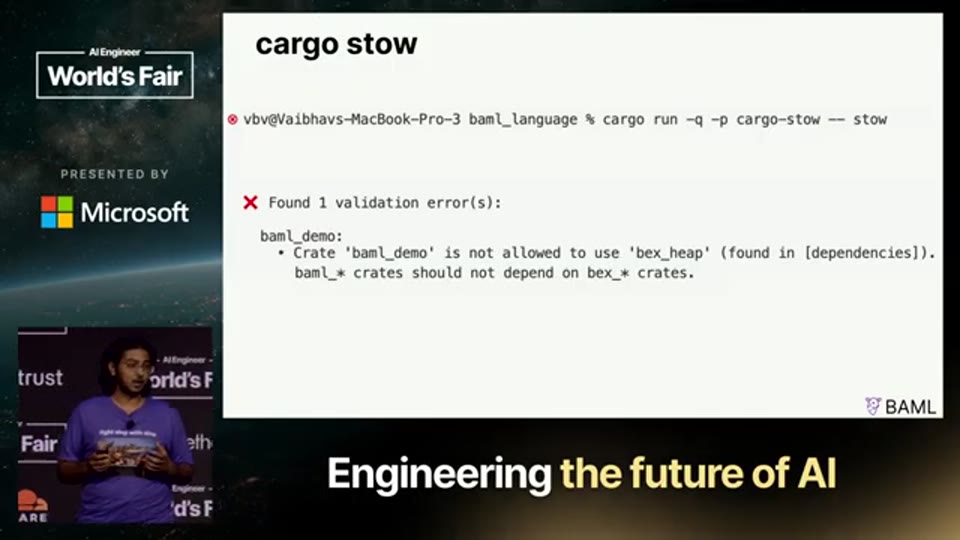
04:19 - 의존성 그래프와 CLI 기반 아키텍처 불변식 검증 도구를 설명하는 구간
언어 검증의 전투: 에이전트가 프로그램을 만들고, 에이전트가 다시 평가한다
프로그래밍 언어는 일반 애플리케이션보다 훨씬 많은 불변 조건을 가진다. 강연자는 generics, closures, memory allocation, FFI boundaries 같은 요소를 언급하며, 이런 기능들이 서로 얽힌 시스템을 코드 리뷰 없이 신뢰할 수 있느냐는 질문을 던진다. Python도 25년이 지난 뒤에도 버그가 남아 있다는 언급은, 프로그래밍 언어의 정확성이 얼마나 어려운 문제인지 강조하기 위한 사례다. Boundary가 선택한 방식은 사람이 모든 테스트 케이스와 모든 코드를 직접 검토하는 것이 아니라, 에이전트가 계속 BAML 프로그램을 만들고 실행하며 그 과정을 다시 분석하게 하는 것이다.
구체적으로 팀은 에이전트가 처음부터 BAML 프로그램을 만들도록 하고, 그 과정에서 Claude가 어떤 도구를 사용했는지, 어떤 시도를 했는지, 어디서 실패했는지를 transcript 수준에서 분석한다. 사람도 이를 검사할 수 있지만, 더 중요한 것은 다른 에이전트가 그 transcript를 읽고 무엇이 좋았고 무엇이 나빴는지 평가한다는 점이다. 이때 평가는 단순히 언어 기능이 맞게 동작했는지만 보지 않는다. 어떤 작업이 한 번의 tool call로 끝날 수 있었는데 세 번의 tool call을 필요로 했다면, 그것도 언어와 도구 설계의 개선 포인트가 된다. 즉, Boundary는 “정확한 결과”뿐 아니라 “에이전트가 얼마나 효율적으로 올바른 결과에 도달했는가”를 측정한다.
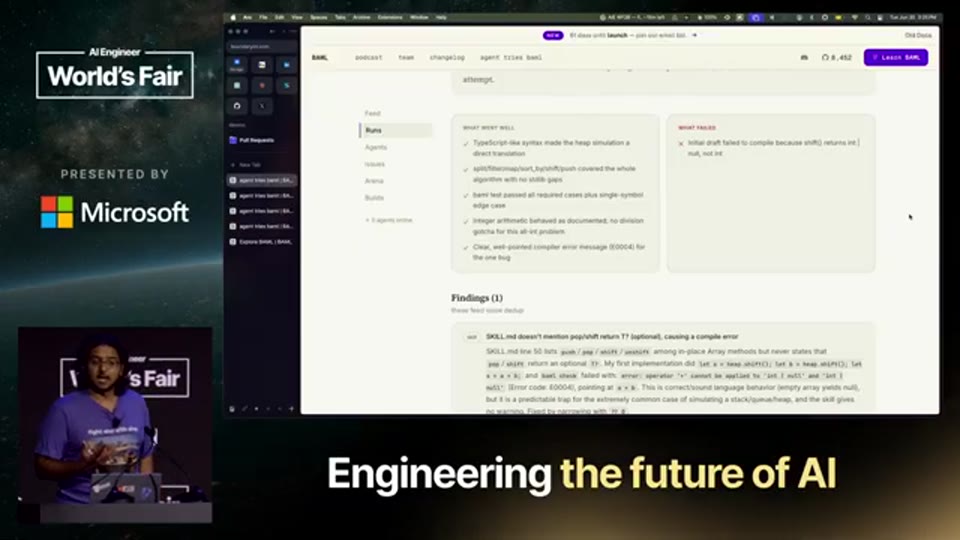
05:29 - 에이전트가 생성한 BAML 프로그램과 Claude transcript를 다시 에이전트가 평가하는 흐름을 설명하는 구간
이 접근은 언어 설계를 데이터 기반으로 바꾼다. 강연자는 새로운 언어 기능이나 skill이 실제로 좋은지 추측하는 대신 A/B 테스트할 수 있다고 설명한다. 어떤 기능이 더 적은 tool call을 유도하는지, 어떤 방식이 더 적은 오류를 만드는지, 어떤 경로가 올바른 결과를 더 자주 생성하는지 비교할 수 있다면, 언어 설계는 취향이나 직관만의 문제가 아니게 된다. 강연자의 표현을 빌리면, 이제 “한 줄의 코드를 직접 쓰지 않고도” 데이터 기반 시스템을 만들 수 있다. 정확히 말하면 이는 개발자가 구현을 전혀 하지 않는다는 뜻이라기보다, 시스템 개선의 많은 부분을 에이전트 실행 데이터와 자동 분석으로 추진할 수 있다는 의미에 가깝다.
TypeScript와 JavaScript 비판: 인간 생산성을 위해 설계된 언어의 한계
강연의 중반 이후 Gupta는 더 근본적인 층위로 논의를 옮긴다. 팀 내부 도구로 slop을 통제할 수는 있지만, 우리가 사용하는 기반 기술 자체가 slop을 품고 있다면 결국 전쟁에서 질 수 있다는 주장이다. 그는 TypeScript의 주요 설계 목표가 correctness(정확성)와 productivity(생산성)의 균형이라고 설명하면서, 여기서 말하는 생산성은 기본적으로 “인간 생산성”이라고 지적한다. 이 구분은 핵심적이다. 사람이 직접 코드를 쓰는 세계에서 타협으로 받아들여진 언어 설계가, 에이전트가 대량의 코드를 생성하고 수정하는 세계에서는 오히려 불안정성을 증폭시킬 수 있기 때문이다.
강연자는 JavaScript의 sort 동작을 예로 들며, 왜 정렬 과정에서 값이 문자열로 바뀌는가를 문제 삼는다. STT에는 화면의 코드가 포함되어 있지 않지만, 문맥상 JavaScript의 기본 배열 정렬이 요소를 문자열로 변환한 뒤 사전식으로 정렬하는 동작을 지칭하는 것으로 보인다. 그는 이런 동작을 “언어 안에 구워진 slop”이라고 표현한다. 또한 JavaScript 위에 CoffeeScript, TypeScript, Effect 같은 계층이 쌓여왔지만, 그 아래의 JavaScript가 이미 깨진 기반이라면 계속 패치하는 방식만으로는 한계가 있다고 주장한다. 이 주장은 TypeScript나 JavaScript가 쓸모없다는 단순 비판이 아니라, 에이전트 시대에는 언어의 기본 가정 자체를 다시 설계해야 한다는 문제 제기다.
코드 읽기의 대안: 시각화와 실행 추적 중심의 이해 방식
Gupta가 제시하는 새로운 방향은 “코드를 읽지 말자”가 아니라 “코드 이해의 단위를 바꾸자”에 가깝다. 그는 코드를 볼 때 텍스트 자체가 아니라 코드 구조를 시각화한 뷰를 먼저 볼 수 있다면 어떻겠느냐고 묻는다. 사용자는 시각화된 구조를 클릭하며 정확한 코드 라인으로 이동할 수 있고, 더 넓은 관점이 필요하면 확대하거나 펼치면서 코드베이스를 탐색할 수 있다. 이 방식은 모든 파일을 순서대로 읽는 대신, 사람이 이해해야 하는 부분을 선택적으로 좁혀가는 탐색 모델을 제공한다.
또 하나의 핵심은 실행 추적(execution trace)이다. 강연자는 모든 코드를 읽지 않는 세계에서는 코드가 실제로 어떻게 실행되는지를 보는 것이 이해의 중심이 된다고 말한다. 어떤 프로그램이 어느 부분에서 얼마나 시간을 썼는지, 어떤 경로로 실행되었는지, 어떤 오류와 비효율이 발생했는지를 추적할 수 있다면, 사람과 에이전트 모두 시스템을 더 정확히 이해할 수 있다. 일반적인 Python이나 TypeScript에서 모든 것을 추적하면 성능 비용이 감당하기 어렵지만, 처음부터 first principles로 설계하면 사실상 zero performance cost에 가깝게 만들 수 있다고 그는 주장한다. 이 부분은 BAML이 단순한 언어 문법이 아니라, 에이전트와 인간이 함께 이해하기 쉬운 실행 환경까지 포함하려는 시도임을 보여준다.
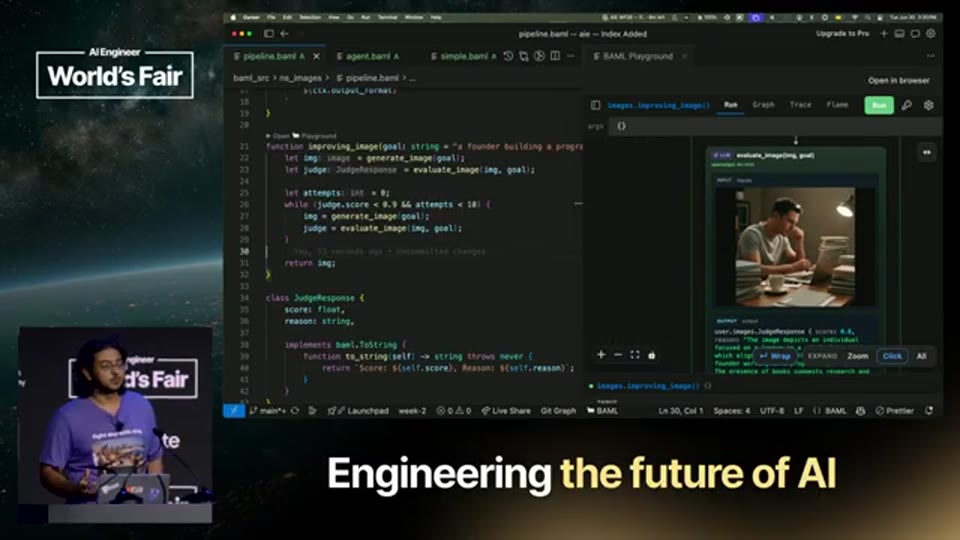
10:39 - 코드 이해를 실행 trace 중심으로 전환하는 데모를 설명하는 구간
이 접근은 에이전트 최적화와도 직접 연결된다. 모든 파일에 tracing system이 있고 Claude 같은 에이전트가 이를 탐색할 수 있다면, 에이전트는 버그, 오류, 비효율을 더 잘 찾아낼 수 있다. 사람은 모든 코드를 직접 읽는 대신, 시스템이 제공하는 구조적 정보와 실행 정보를 바탕으로 판단한다. 결국 강연자가 말하는 미래의 개발자는 코드의 모든 줄을 기억하는 사람이 아니라, 자신이 다루는 시스템의 형태와 제약을 이해하고, 그 시스템을 관찰·검증·수정할 수 있는 도구를 설계하는 사람에 가깝다.
Agent-first tooling: grep을 넘어 함수와 라이브러리를 직접 이해하는 도구
강연자는 개발 도구의 역사도 인간 중심으로 만들어져 왔다고 본다. IDE tooling은 수십 년에 걸쳐 발전했고, Vim에서 벗어나 VS Code를 쓰게 된 개인적 경험을 농담처럼 언급한다. 그러나 에이전트가 코드를 읽고 수정하는 시대에는 IDE의 사용자 자체가 사람만이 아니다. 따라서 도구도 agent-first 관점에서 다시 설계해야 한다.
그가 예로 든 것은 grep과 ripgrep의 다음 단계다. 어떤 코드베이스에서 calculate라는 이름을 검색하면 여러 사용처가 나오지만, 그것만으로는 함수의 의미, docstring, 실제 source code, 호출 관계를 한 번에 알기 어렵다. Gupta는 “calculate를 설명해 달라”고 요청하면 docstring, 실제 소스, 내부 사용처가 함께 나오는 도구를 상상한다. 이는 여러 번의 검색과 파일 열기를 하나의 tool call로 줄이는 방식이며, 특히 에이전트에게 중요하다. 에이전트의 작업 비용은 사람의 클릭 수가 아니라 tool call 수, context 사용량, 실패 가능성으로 나타나기 때문이다.
외부 라이브러리도 마찬가지다. 강연자는 자신이 코딩을 배울 때 “code is always the source of truth”라는 교훈을 얻었다고 말한다. 문서는 틀릴 수 있고 README나 architecture file도 오래되면 거짓말을 할 수 있지만, 실제 실행되는 코드는 가장 신뢰할 수 있는 근거라는 것이다. 따라서 에이전트가 외부 라이브러리를 이해할 때 웹 검색이나 문서 요약에만 의존하기보다, 실제 코드와 타입, 사용 관계를 직접 가져올 수 있어야 한다. 이 관점은 문서 중심 개발에서 코드 기반 실증 중심 개발로 무게중심을 옮긴다.
모든 함수를 CLI로 실행 가능하게 만들기
코드를 이해하는 마지막 단계는 실행이다. 강연자는 모든 함수가 즉시 간단한 CLI command로 노출된다면 어떻겠느냐고 제안한다. 예를 들어 add 함수가 있으면, 그것이 A와 B 파라미터를 가진 CLI 명령으로 자동 제공되고, 개발자나 에이전트는 즉시 실행해 결과를 확인할 수 있다. 이 방식은 특정 함수의 동작을 확인하기 위해 테스트 하네스를 만들거나 애플리케이션 전체를 띄우는 부담을 줄인다.
더 나아가 그는 개별 CLI tool을 완전한 standalone binary로 패키징할 수 있다고 설명한다. 이 binary는 실제 전체 코드베이스를 실행하지 않고도 특정 함수와 그 실행 환경을 담아낼 수 있으며, type-safe하고 deterministic한 방식으로 동작한다. 특히 Windows, macOS, Linux 같은 운영체제 차이나 WASM(WebAssembly) 같은 실행 타깃을 에이전트가 신경 쓰지 않아도 된다면, 엔지니어는 하위 시스템의 제약에 덜 묶인다. 강연자가 말하는 “agent speed”는 단순히 코드를 빨리 생성하는 속도가 아니라, 실행·검증·패키징·배포의 마찰을 줄여 전체 개발 루프를 빠르게 만드는 속도다.
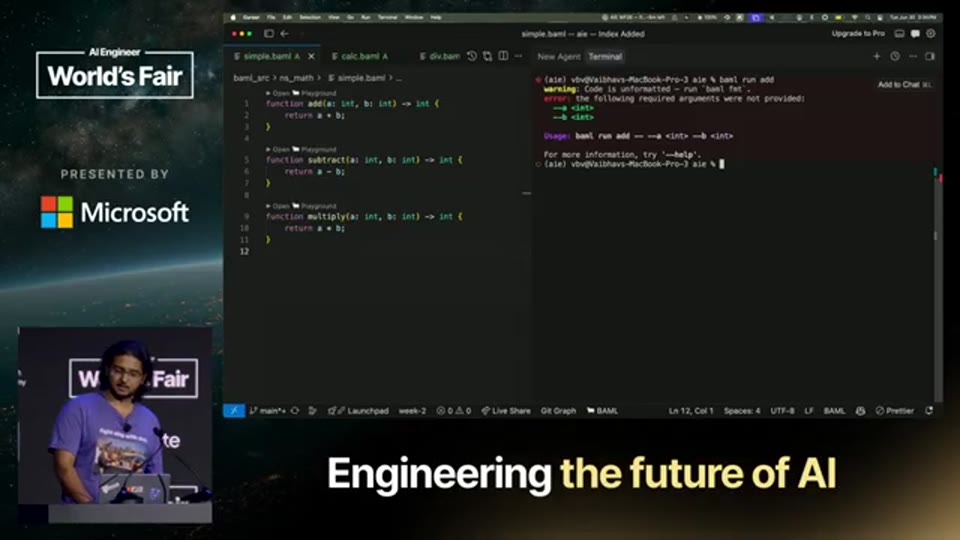
13:52 - 함수를 즉시 CLI command로 실행하고 standalone binary로 패키징하는 아이디어를 보여주는 구간
BAML의 error handling: 타입 시스템이 오류를 추론하고 증명한다
강연 후반의 가장 기술적인 부분은 error handling이다. Gupta는 JavaScript 생태계에서 에이전트가 try/catch를 중첩하다가 결국 console.log로 오류를 처리하고 포기하는 패턴을 비판한다. 이 문제는 에이전트의 능력 부족만이 아니라 언어와 타입 시스템이 오류 정보를 충분히 엄격하게 다루지 않는 데서 비롯된다. Rust를 제외하면 error handling이 아름다운 언어를 보기 어렵다는 그의 말은 다소 과장된 표현이지만, 핵심은 오류가 타입 시스템의 중심 요소가 되어야 한다는 주장이다.
BAML 예시에서 divide 함수는 division by zero error를 던질 수 있고, 함수 자체가 그 오류 가능성을 알고 있다. 더 중요한 점은 calculate 함수가 내부에서 divide를 호출하면, calculate 역시 division by zero error를 던질 수 있음을 자동으로 알게 된다는 것이다. 개발자가 매번 오류 타입을 수동으로 선언하지 않아도 오류 타입이 추론되고 전파된다면, 컴파일러는 특정 오류가 처리되었는지 exhaustively 보장할 수 있다. 어떤 API가 절대 throw하지 않는다고 보장하려는데 내부에 처리되지 않은 오류가 남아 있다면, 시스템은 그 제약을 만족하지 못한다고 판단한다.
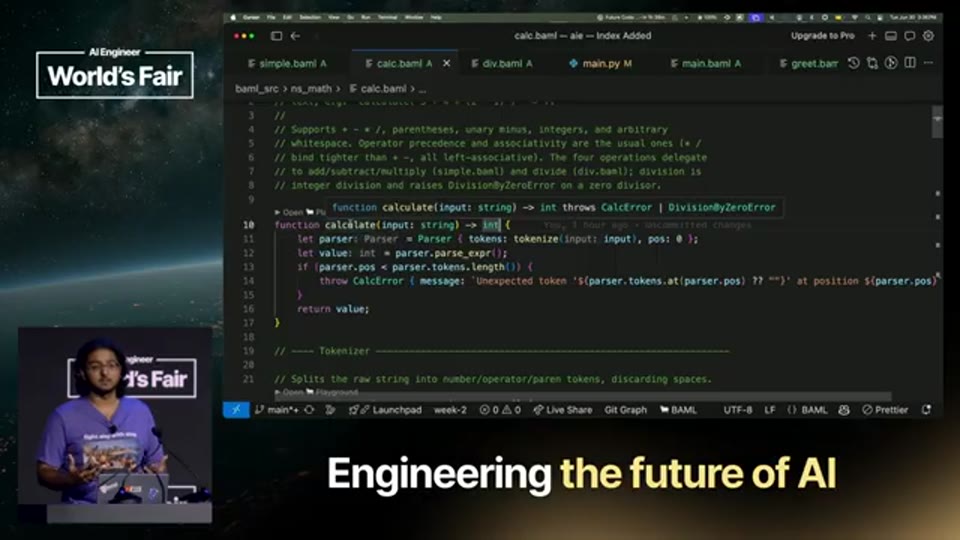
16:11 - BAML의 오류 타입 추론과 exhaustive error handling 보장을 설명하는 구간
강연자는 특정 오류를 catch하고 sentinel value를 반환하는 예를 보여준다. 예컨대 division by zero error를 잡아 항상 0을 반환하도록 처리하면, 이전에는 던질 수 있었던 오류가 더 이상 외부로 전파되지 않는다고 컴파일러와 도구가 보장할 수 있다. 이 구조는 “아마 처리했을 것이다”가 아니라 “처리되었음을 증명할 수 있다”는 차이를 만든다. 강연자의 결론은 코드가 결국 신뢰의 문제라는 것이다. 우리가 LLM이 만든 코드를 맹목적으로 쓰지 못하는 이유는 LLM 자체만의 문제가 아니라, 그 아래의 시스템들이 충분히 엄격한 보증을 제공하지 못하기 때문이다.
새 언어만으로는 충분하지 않다: 기존 언어와의 공존
Gupta는 BAML을 새로운 프로그래밍 언어로 제시하지만, 모든 사람에게 기존 코드를 버리고 새 언어로 다시 쓰라고 요구하는 것은 현실적이지 않다고 선을 긋는다. 그는 그렇게 하면 slop과의 전쟁에서 질 것이라고 말한다. 이미 세계에는 Python, TypeScript, Rust, Go, Ruby, Java 등 수많은 코드베이스가 존재하며, 이들을 한 번에 대체하는 전략은 채택 비용이 너무 크다. 따라서 Boundary가 고민한 방향은 BAML을 standalone으로만 쓰는 것이 아니라, 기존 언어 안에서 호출할 수 있게 만드는 것이다.
강연에서 그는 Python에서 BAML의 calculate 함수를 직접 호출하는 예를 설명한다. 이 호출은 type-safe하며, 동기 함수뿐 아니라 calculate async도 제공된다고 한다. 또 with timeout이라는 함수를 예로 들며, 일정 시간 안에 작업이 끝나지 않으면 timeout되는 함수를 언어 경계 너머로 사용할 수 있음을 보여준다. 더 흥미로운 부분은 Python lambda, generics, closures를 BAML과의 경계 너머로 전달할 수 있다는 점이다. 이 주장은 BAML이 단순한 DSL이 아니라, 여러 언어 사이에서 타입 안전성과 실행 보장을 유지하려는 시스템임을 시사한다.
여기서 타입 시스템은 “절대적인 진실의 중심”으로 제시된다. 에이전트가 어떤 코드를 생성하더라도 타입 시스템이 거짓말하지 않는다면, 잘못된 불변식이 코드베이스에 들어오는 것을 더 강하게 막을 수 있다. 물론 STT만으로는 실제 구현 방식이나 경계 호출의 세부 메커니즘을 확인할 수 없으므로, 이 부분은 강연자가 제시한 방향성과 데모 설명의 범위에서 이해해야 한다. 다만 큰 그림은 분명하다. 새 기반 시스템이 필요하지만, 그것은 기존 세계와 단절되는 방식이 아니라 점진적으로 스며드는 방식이어야 한다.
프로세스의 진화: 코드 리뷰 이후의 신뢰 모델
강연의 마지막 메시지는 코드 리뷰를 없애자는 단순한 주장이 아니다. 오히려 기존 코드 리뷰가 맡아왔던 기능을 더 정밀한 시스템으로 분해하자는 제안에 가깝다. 코드 리뷰는 설계 의도 확인, 아키텍처 경계 점검, 버그 탐지, 스타일 일관성 유지, 팀 지식 공유라는 여러 역할을 한 번에 수행해왔다. 하지만 AI 에이전트가 생성하는 코드량과 속도 앞에서는 사람이 모든 diff를 꼼꼼히 읽는 방식이 점점 더 병목이 된다. 따라서 Boundary는 design doc, architecture invariant, dependency graph, CI/CD 검증, 에이전트 기반 transcript 분석, 실행 trace, 타입 시스템 보증 같은 장치로 신뢰 모델을 재구성한다.
Gupta는 CI/CD 도입의 역사와 비슷한 비유를 든다. 어떤 회사는 CI/CD를 추가하면 느려진다고 말하지만, 실제로는 도입 초기에 몇 달간 느려진 뒤 장기적으로 훨씬 빠르게 움직이게 된다. AI 시대의 내부 도구와 프로세스도 마찬가지다. 처음에는 이런 도구를 만드는 데 시간이 들지만, 일단 구축되면 팀은 사람이 직접 읽고 조율하던 많은 작업을 시스템에 위임할 수 있다. 그래서 “agent speed”로 움직이기 위해서는 단순히 더 빠른 모델을 쓰는 것이 아니라, 조직의 프로세스와 기반 도구를 그 속도에 맞게 다시 설계해야 한다.
강연자는 마지막에 새로운 Git, 새로운 데이터베이스, 그리고 새로운 프로그래밍 언어가 필요하다고 말한다. 이는 현재 도구들이 완전히 쓸모없다는 뜻이라기보다, 인간이 직접 코드를 작성하고 검토하던 시대의 가정 위에 만들어진 기반 시스템들을 다시 상상해야 한다는 문제 제기다. AI가 slop을 늘리는 것은 피할 수 없는 흐름일 수 있지만, 그 slop을 측정하고 제한하고 검증하는 도구 역시 AI와 함께 만들 수 있다. 결국 이 강연의 가장 중요한 takeaway는 “AI 코드 생성이 위험하니 쓰지 말자”가 아니라, “AI가 만드는 속도를 감당할 수 있는 신뢰 인프라를 먼저 만들어야 한다”는 것이다.
마무리 / 핵심 정리
Vaibhav Gupta의 강연은 AI 에이전트 시대의 소프트웨어 엔지니어링을 낙관적으로만 보지도, 비관적으로만 보지도 않는다. 그는 코드베이스에 slop이 증가할 것이라는 현실을 인정하면서도, 그 문제를 기존 코드 리뷰와 수작업 검토만으로 해결할 수 없다고 본다. Boundary가 선택한 방식은 작은 아키텍처 문서, 강한 설계 문서 문화, 의존성 그래프와 불변식 검증, 에이전트 기반 테스트와 평가, 실행 추적, 타입 시스템 중심의 오류 보장으로 이루어진 새로운 신뢰 체계다.
이 강연이 특히 설득력 있는 이유는 “AI로 더 빨리 코딩하자”는 표면적 생산성 담론을 넘어, AI가 바꾸는 개발 프로세스의 병목을 구체적으로 짚기 때문이다. 앞으로의 엔지니어링 조직은 모든 코드를 읽는 능력보다, 읽지 않은 코드도 신뢰할 수 있게 만드는 시스템을 설계하는 능력이 더 중요해질 수 있다. 그리고 그 변화는 단순한 도구 교체가 아니라, 프로그래밍 언어, 빌드 시스템, 데이터베이스, 버전 관리, IDE, CLI, 타입 시스템 전체를 다시 생각하게 만드는 더 깊은 전환으로 이어진다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | fighting slop with slop — Vaibhav Gupta, Boundary |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-31 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.