말하면서 듣는다 — AI 글래스, 앱 시장 재편되나
📺 원본 영상: 말하면서 듣는다… AI 글래스, 앱 시장 재편되나 | 미라 무라티가 꺼낸 다음 경쟁축 🎙️ 채널: 안될공학 - IT 테크 신기술 📅 정리 일자: 2026-05-13 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
OpenAI 전 CTO 미라 무라티(Mira Murati)가 설립한 Thinking Machines Lab이 기존 AI 모델과 구조적으로 다른 ‘인터랙션 모델(Interaction Model)‘을 공개했다. 이 모델은 실시간 음성·영상을 동시에 처리하며 대화 타이밍을 스스로 판단하는 새로운 접근 방식을 채택하고 있어, 단순한 AI 모델 개선을 넘어 앱 생태계 전반의 재편 가능성을 시사한다. 특히 AI 글래스(AI Glass)와 휴머노이드 로봇 분야에서 가장 큰 파급력이 예상된다.
미라 무라티와 Thinking Machines Lab
ChatGPT와 DALL-E 개발을 진두지휘한 OpenAI의 전 CTO, 미라 무라티(Mira Murati)는 2023년 Sam Altman 해임 사태 당시 OpenAI 임시 CEO를 잠시 맡은 것으로도 잘 알려진 인물이다. “ChatGPT의 어머니”라는 별칭이 붙을 만큼 OpenAI의 핵심 제품을 이끌었던 그녀는 2024년 OpenAI를 떠난 후, 2025년 2월 Thinking Machines Lab을 설립했다.
회사 설립 이후 OpenAI, Meta, Mistral 등 주요 AI 기업 출신 연구자들을 영입하며 빠르게 체제를 갖췄다. 첫 번째 공개 제품은 모델 파인튜닝(Fine-tuning) 도구인 ‘Tinker’였지만, 이번에 공개된 인터랙션 모델이 업계의 주목을 한 몸에 받고 있다. 강연자에 따르면, 미라 무라티가 궁극적으로 지향하는 방향은 단순한 AI 모델이나 챗봇 서비스가 아니라, “AI와 사람이 협업하는 방식 자체”를 근본적으로 바꾸는 것이다.
현재 AI의 구조적 한계 — Collaboration Bottleneck
Thinking Machines Lab이 자사 홈페이지에서 정의하는 핵심 문제는 ‘Collaboration Bottleneck(협업 병목)‘이다. 오늘날의 AI 모델은 기본적으로 ‘단일 스레드(Single Thread)‘에서 현실을 경험한다. 즉, 모델이 응답을 생성하고 있는 동안에는 사용자로부터 새로운 정보를 받아들이지 못하며, 모델은 사용자가 무엇을 하고 있는지 인지하지 못한 채 기다리는 구조다.
이는 구조적인 문제다. 사용자의 입력이 끝나야 AI가 반응하고, AI가 반응하는 동안 사용자의 발화를 처리하지 못하는 Turn-based 방식은 채팅 인터페이스에서 시작한 AI 모델의 원초적 한계이기도 하다. Gemini Live처럼 기존에도 대화 중 끼어들기를 지원하는 시도가 있었고 당시에는 큰 화제가 됐지만, 사용자가 도중에 말을 끊으면 AI 응답의 질이 저하되는 현상을 완전히 해결하지는 못했다. Thinking Machines의 인터랙션 모델은 이 문제를 정면으로 돌파하려 한다. 별도의 대화 관리(Dialogue Management) 컴포넌트 없이 AI 모델 자체가 언제 답해야 할지를 판단한다는 것이 핵심 주장이다.
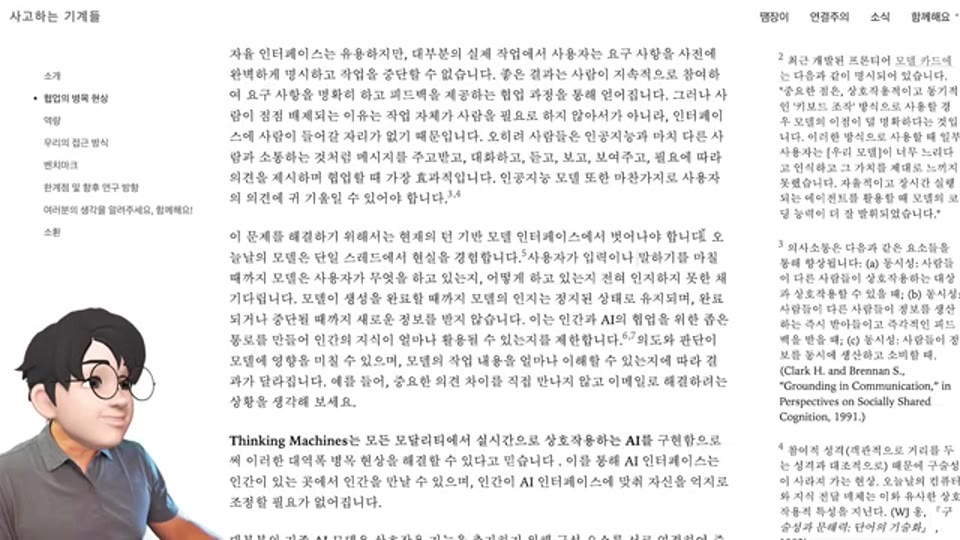
03:10 - Thinking Machines 홈페이지 화면 — Collaboration Bottleneck 개념 및 ‘단일 스레드’ 문제 설명
기술적 접근 — 200ms Micro Turn-based 아키텍처
Thinking Machines의 인터랙션 모델이 Collaboration Bottleneck을 해결하는 방법은 타이밍 관리를 극도로 세분화하는 것이다. 기존의 Turn-based 구조를 유지하되, 그 턴의 단위를 약 **200밀리초(200ms)**로 쪼갠다. 비디오와 오디오 스트림을 이 마이크로 턴(Micro Turn) 단위로 Time-aligned하여 모델이 지속적으로 인지하고 반응할 수 있도록 설계되어 있다.
이 접근 방식이 기존과 결정적으로 다른 점은 대화 타이밍 판단 로직이 모델 외부가 아닌 모델 내부에 통합되어 있다는 것이다. 기존 시스템에서는 “말이 끝났음을 감지하는 컴포넌트”나 “인터럽트(Interrupt) 로직”을 모델 바깥에 별도로 구현해야 했다. 반면 인터랙션 모델은 이 모든 판단을 스트리밍으로 들어오는 실시간 데이터로부터 직접 수행한다. 사람의 커뮤니케이션이 말뿐 아니라 제스처, 표정, 시선, 화면 변화 등 복합적인 정보로 이루어진다는 점에서, 시간의 흐름 자체를 문맥(Context)으로 활용하는 이 설계는 훨씬 자연스러운 상호작용을 가능하게 한다고 강연자는 설명한다.
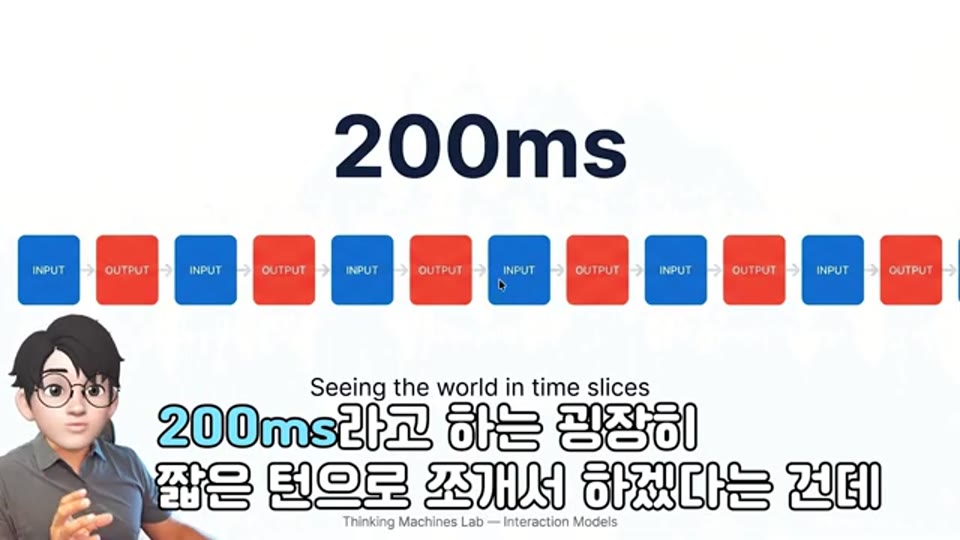
05:25 - 200ms 마이크로 턴 기반 아키텍처 설명 화면
데모에서 확인된 세 가지 능력
강연자가 소개한 데모 영상들에서는 인터랙션 모델의 실제 동작 방식이 구체적으로 드러났다.
첫 번째는 능동적 대기 능력이다. 사용자가 말하다가 커피를 마시거나 잠시 생각에 잠기면, 모델은 조용히 기다린다. 사용자가 생각 중인지, 말을 마쳤는지를 스스로 판단하며 섣불리 반응하지 않는 것이다. 이는 단순히 음성 신호에서 발화 종료를 감지하는 것과는 차원이 다르다. 모델이 영상과 오디오 스트림을 지속적으로 인지하면서 상황 전체를 이해하고 있음을 보여준다.
두 번째는 주도적 인터럽트 능력이다. AI가 사용자의 말을 듣다가 잘못된 방향으로 흐르고 있다고 판단하면, 스스로 “Wait, no”라고 끊어버린다. 강연자에 따르면 이것은 AI가 언제 개입해야 가장 효과적인지를 스스로 판단하는 것으로, 마치 숙련된 협업자처럼 동작하는 것이다. 이 능력 역시 별도 인터럽트 로직 없이 모델 자체에서 나온다는 점에서 구조적으로 의미가 있다.
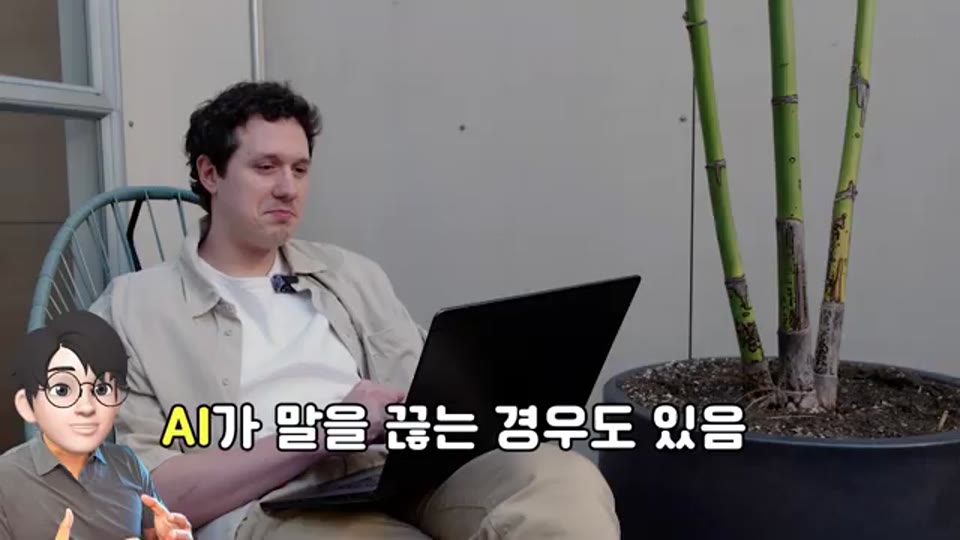
04:33 - AI가 대화 중 스스로 인터럽트하는 데모 장면 (‘Wait, no’ 발화)
세 번째는 동시 발화 능력이다. 사용자가 말하는 동시에 AI가 그 내용을 실시간으로 통역하거나 변환한다. 강연자는 이것이 현실에서 실시간 통역사가 하는 행동 그대로라고 설명한다. 상대방의 말을 멈추게 하거나 발화를 끊지 않고, 자연스럽게 병렬로 처리하는 방식이다. 이 기능이 실용화되면 진정한 의미의 실시간 동시통역이 가능해진다.
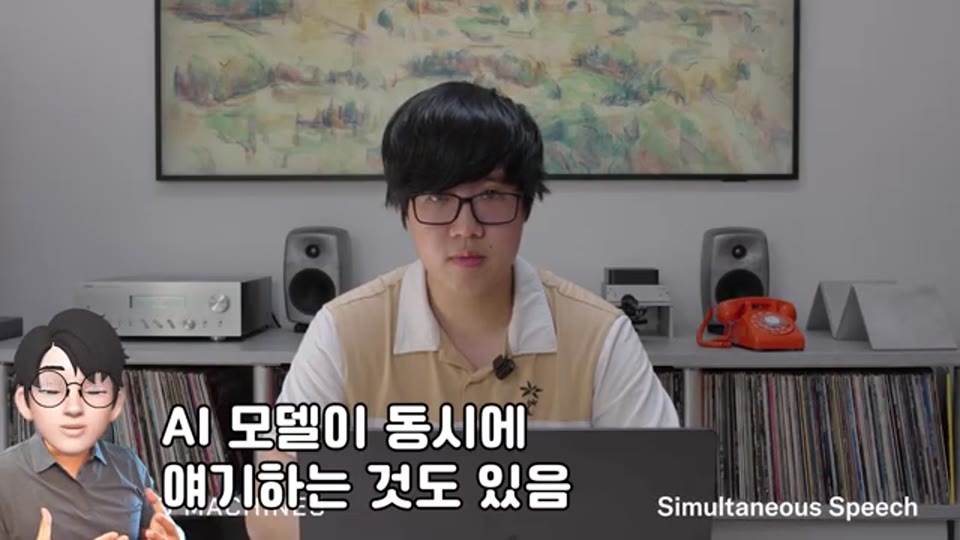
06:12 - 사용자와 AI가 동시에 발화하는 실시간 동시통역 데모
경쟁 구도의 새로운 축 — 인터페이스를 누가 쥐는가
지금까지 OpenAI, Google, Anthropic이 벌여온 프런티어(Frontier) AI 경쟁의 주된 축은 어려운 문제를 추론(Reasoning)하거나, 긴 컨텍스트를 다루거나, 자율 에이전트(Agent)를 만드는 능력에 집중되어 있었다. 강연자는 Thinking Machines의 인터랙션 모델이 이 경쟁의 판을 바꿀 수 있다고 분석한다.
그 근거는 다음과 같다. AI가 채팅창에 갇혀 있으면 “검색 보조” 수준에 머문다. 이어폰 안으로 들어가면 “실시간 통역사”가 된다. 그러나 AI 글래스 안에 있으면, 사용자가 보는 것과 듣는 것을 함께 인지하며 상황을 이해하는 “진정한 비서”로 진화할 수 있다. AI 모델이 어떤 인터페이스 레이어에 붙느냐에 따라 다음 레이어로 전달되는 정보가 달라지고, 그 구조 위에서 만들어지는 앱과 UX가 모두 달라진다. 강연자는 이런 관점에서 앞으로 디바이스 설계, OS 운용, 앱 UX 모두가 재편될 공산이 있다고 짚는다.
텍스트에서 출발한 기존 모델들이 뒤늦게 실시간성 기능을 덧붙이는 방식이라면, Thinking Machines는 처음부터 실시간 시간 추적(Real-time temporal tracking)을 핵심 설계 원칙으로 삼았다. 이 출발점의 차이가 쌓이면서 인터랙션 품질에서 점진적인 격차가 생길 수 있다는 것이 강연자의 시각이다.
AI 글래스와 휴머노이드 — 가장 큰 수혜 영역
강연자는 이 인터랙션 모델의 기술 특성이 AI 글래스와 휴머노이드 로봇 분야에서 가장 강력하게 발휘될 것으로 전망한다. AI 글래스는 본질적으로 사용자가 보고 듣는 것을 실시간으로 처리하면서, 필요할 때 적시에 정보를 제공해야 한다. 이것이 바로 인터랙션 모델이 설계된 방식과 정확히 일치한다.
07:47 - AI 글래스 및 인터랙션 모델 적용 시나리오 설명
2025년에는 Meta 외에도 Apple이 AI 글래스를 출시할 것이라는 소식이 전해지고 있으며, 강연자는 직접 Google I/O에 참석해 관련 발표를 취재할 예정이라고 밝혔다. 이런 흐름 속에서 Thinking Machines가 Google I/O 직전 시점에 인터랙션 모델을 공개한 것은, 업계를 향한 일종의 기술 선언이자 견제의 메시지로도 읽힌다고 강연자는 분석한다.
휴머노이드 분야 역시 마찬가지다. 복잡한 연산은 백그라운드 대형 모델이 처리하고, 결과가 나오면 인터랙션 모델이 자연스럽게 실시간으로 개입하는 구조 — 마치 Daniel Kahneman이 제안한 시스템 1(빠른 직관)과 시스템 2(느린 추론)를 병렬로 운용하는 방식이 로봇의 두뇌에서 구현되는 그림이다. 강연자는 이러한 구조가 로봇이나 휴머노이드에서도 자연스럽게 도입될 것이라고 전망한다.
인프라 지형의 변화 — 스트리밍, SRAM, 하이브리드 AI
인터랙션 모델의 확산은 AI 인프라 요구사항도 근본적으로 바꾼다. 기존에는 대용량 배치(Batch)나 청크(Chunk) 단위로 데이터를 처리하는 방식이 주류였다면, 인터랙션 모델은 오디오·영상 스트림을 실시간으로 끊임없이 처리해야 하기 때문에 스트리밍 아키텍처가 필수가 된다. 네트워크 지형과 음성·영상 스트림 처리 능력이 AI 인프라의 핵심 경쟁 요소로 부상하는 것이다.
메모리 측면에서도 변화가 예상된다. 강연자는 레이턴시(Latency)를 최소화하기 위해 더 빠른 SRAM 형태의 메모리를 대량으로 탑재하고, 캐시를 적극 활용하는 방향으로 하드웨어가 진화할 것이라고 내다본다. 또한 실시간 세션을 대규모로 유지해야 하는 특성상, AI 인프라 경쟁의 초점이 “한 번에 거대한 모델을 잘 돌리는 것”에서 “수많은 사람들의 실시간 세션을 어떻게 효율적으로 유지할 것인가”로 이동하게 된다.
이 맥락에서 Qualcomm CEO 크리스티아노 아몬(Cristiano Amon)이 강조해온 ‘하이브리드 AI’ 개념이 다시 부각된다. 엣지(Edge) 디바이스와 클라우드 간의 역할 분담을 잘 설계하는 것이 핵심 경쟁력이 되는 시대가 도래하는 것으로, 강연자는 로컬 디바이스가 실시간 인터랙션을 담당하고 복잡한 추론은 클라우드 대형 모델이 맡는 협업 구조가 표준이 될 것으로 전망한다.
한편, Thinking Machines Lab은 2025년 3월 NVIDIA의 Vera Rubin 시스템을 기반으로 최소 1GW 규모의 컴퓨팅 사용을 약속하는 대형 파트너십을 발표한 것으로 알려졌다. 스타트업 단계에서도 이 정도 규모의 인프라 투자가 이루어지고 있다는 사실은, 인터랙션 AI 경쟁이 얼마나 본격적으로 불붙었는지를 방증한다.
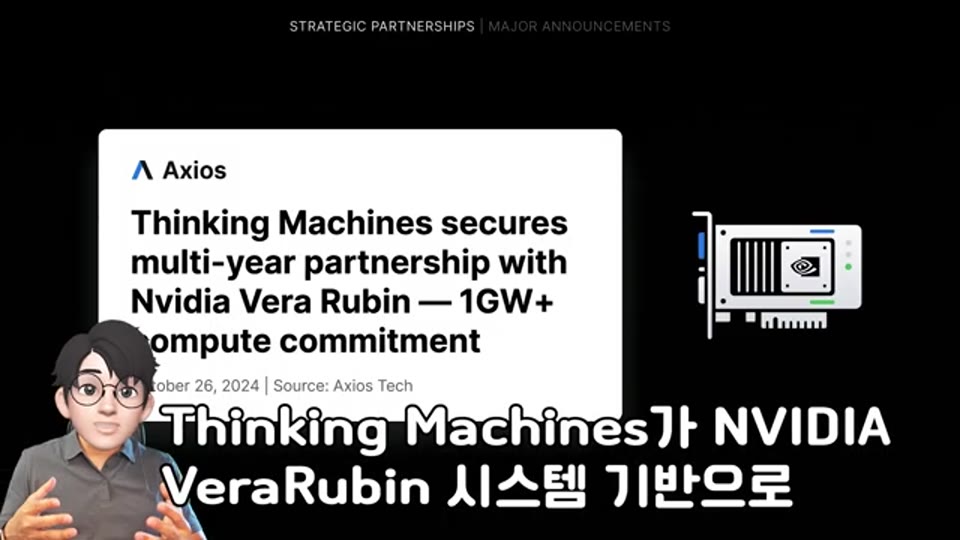
09:55 - Thinking Machines와 NVIDIA Vera Rubin 파트너십 언급 기사/내용
마무리 — 다음 경쟁축이 시작됐다
Thinking Machines Lab의 인터랙션 모델은 현재 퍼블릭 프로덕트(Public Product)가 아닌 프리뷰(Preview) 버전이다. 따라서 실제 서비스 환경에서의 성능, 특히 대규모 동시 세션 처리 시의 레이턴시와 안정성은 아직 검증이 필요하다. 강연자 역시 이 점을 솔직하게 언급하며, 앞으로 실제 서빙 환경에서 어떻게 동작할지 지속적인 관찰이 필요하다고 밝혔다.
그럼에도 이 기술이 제기하는 질문은 묵직하다. AI가 채팅창을 벗어나 이어폰, 글래스, 로봇으로 확장될 때, 각 인터페이스 레이어를 누가 장악하느냐에 따라 그 위에 쌓이는 앱·OS·UX의 생태계 전체가 달라진다. OpenAI·Google·Anthropic이 지능 자체의 우열을 다투는 사이, 미라 무라티는 그 지능이 세상과 상호작용하는 방식에서 새로운 전선을 열었다. 말하면서 듣고, 보면서 판단하고, 적시에 끼어드는 AI — 이것이 다음 경쟁축의 시작점이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | 말하면서 듣는다… AI 글래스, 앱 시장 재편되나 | 미라 무라티가 꺼낸 다음 경쟁축 |
| 채널 | 안될공학 - IT 테크 신기술 |
| 리포트 작성 | 2026-05-13 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.