엔비디아 GTC 2026 키노트, 핵심만 깊게 정리
📺 원본 영상: 엔비디아 GTC 2026 키노트, 핵심만 깊게 정리 | Rubin·NemoClaw·삼성 메모리까지 🎙️ 채널: 안될공학 - IT 테크 신기술 📅 정리 일자: 2026-03-18 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있으며, 일부 고유명사 및 전문 용어는 문맥 기반으로 교정하였습니다.
개요
NVIDIA의 GTC 2026은 단순한 신제품 발표회가 아니었다. 이 행사에서 NVIDIA는 자신들을 GPU 회사로 규정하는 시대를 공식적으로 마감하고, AI 팩토리 인프라 회사이자 에이전트 런타임과 운영체제를 만드는 회사, 그리고 물리 AI와 로보틱스 플랫폼 회사로 스스로를 재정의했다. Rubin 플랫폼, Dynamo 1.0, NemoClaw, 이종 가속기 아키텍처, 그리고 HBM4를 정점으로 하는 메모리 계층 재편까지—이번 GTC 2026이 그린 미래의 전모를 기술적 관점에서 깊게 살펴본다.
💡 [영상 참조] 진행자는 해외여행 중 라이브 스트리밍으로 키노트를 시청한 후, 직접 녹음 대신 AI가 내레이션을 담당하는 형식으로 영상을 제작했습니다. 상세 내용은 원본 영상을 확인하세요.
엔비디아의 정체성 재정의: GPU 회사에서 AI 산업 운영체제로
GTC 2026에서 NVIDIA가 보낸 가장 강렬한 신호는 기술 스펙보다 자기 정체성의 재정의였다. NVIDIA는 이번 행사에서 AI 팩토리(AI Factory), 에이전트(Agent), AI 추론(AI Inference), 물리 AI(Physical AI)라는 네 가지 핵심 축을 중심으로 자사의 비전을 공식 선언했다. 예전의 NVIDIA가 “좋은 GPU를 만드는 회사”였다면, 이제는 “AI가 실제로 돌아가는 공장 전체를 설계하는 회사”로 전환을 선포한 것이다.
이 변화가 단순한 마케팅 수사가 아님을 보여주는 근거는 구체적인 제품군에 있다. DSX(Data Center eXchange) 레퍼런스 디자인, Omniverse DSX 블루프린트, Dynamo 1.0, 그리고 Vera Rubin 플랫폼의 발표가 전부 같은 방향을 가리키고 있다.
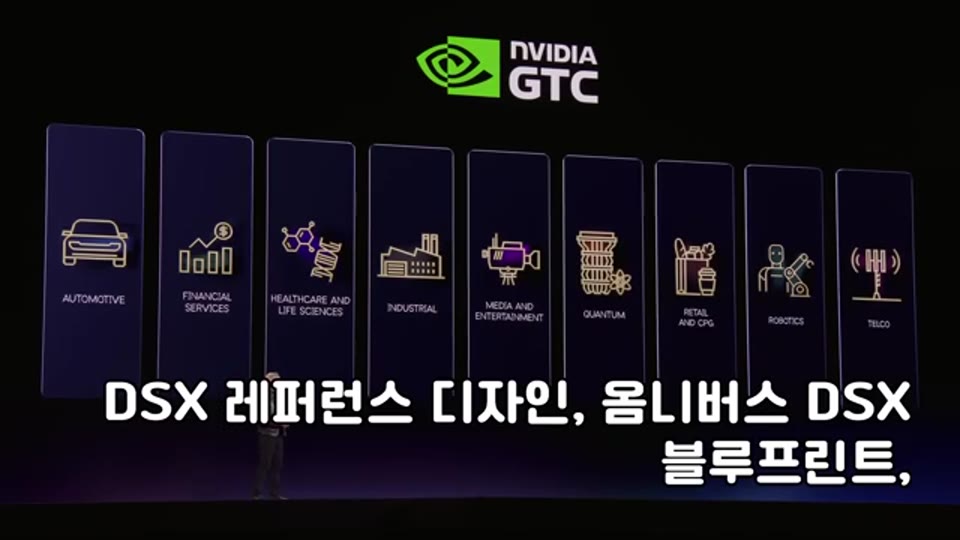
01:29 - DSX 레퍼런스 디자인, Omniverse DSX 블루프린트, Dynamo 1.0, Vera Rubin 플랫폼 발표 슬라이드
핵심 키워드는 “훈련(Training)“이 아니라 “추론(Inference)”, “모델”이 아니라 “운영(Operation)“이었다. AI 산업의 무게 중심이 거대한 모델을 한 번 학습시키는 단계에서, 수백만 사용자의 요청을 실시간으로 처리하는 대규모 추론 단계로 이동하고 있다는 강력한 선언이다.
이번 행사는 시장 규모를 재정의하는 자리이기도 했다. NVIDIA는 AI 칩 시장 기회를 2027년까지 최소 1조 달러 규모로 제시하며, 자신들이 그 파이를 얼마나 크게 보고 있는지를 공개적으로 밝혔다. 또한 루빈(Rubin) 이후의 차세대 아키텍처인 파인만(Feynman) 로드맵까지 언급함으로써, 상세 스펙은 아직 미공개 상태이지만 중장기 방향성 자체는 흔들림 없이 가져가겠다는 의지를 드러냈다.
AI 진화의 4단계와 에이전트 시대의 인프라 요구
진행자는 이번 GTC에서 NVIDIA가 제시한 AI 진화의 네 단계를 강조하며 핵심 메시지로 꼽았다. 1단계는 인식하는 AI(Perceptive AI), 2단계는 생성하는 AI(Generative AI), 3단계는 추론하는 AI(Reasoning AI), 그리고 4단계는 실제로 작업을 수행하는 에이전트 AI(Agentic AI)다.
에이전트 AI와 기존 챗봇(Chatbot)의 차이는 단순히 성능 차이가 아니다. 챗봇은 한 번 답하고 끝나지만, 에이전트는 계획을 세우고, 툴(Tool)을 호출하고, 파일을 읽고, 코드를 실행하며, 여러 단계를 거쳐 작업을 완료한다. 이 과정에서 토큰(Token) 사용량은 기존과 비교할 수 없을 정도로 폭발하고, 메모리·CPU·네트워크·저장장치 부하도 함께 급증한다. 즉, 에이전트 시대에는 모델의 지능 수준만큼, 혹은 그 이상으로 인프라의 안정성과 효율이 중요해진다는 뜻이다.
이 맥락에서 Dynamo 1.0의 등장이 가지는 의미가 선명해진다. Dynamo 1.0은 단순한 컨셉이 아니라, 대규모 AI 추론 운영을 위한 실전형 운영체제(Inference Operating System)로서 상용 진입을 선언했다. 에이전트가 실제로 돌아가는 환경에서는 권한 관리, 샌드박스 보안(Sandbox Security), 장기 실행 환경, 시스템 연동 같은 인프라 요소들이 필수가 된다. Dynamo 1.0은 바로 이 공백을 채우기 위해 설계된 소프트웨어 계층이다.
루빈 플랫폼의 세 축: CUDA-X, 완성형 시스템, AI 팩토리
NVIDIA는 이번 행사에서 자신들의 경쟁력을 세 가지 축으로 명확히 정의했다. 이 세 축을 이해하면 루빈(Rubin) 플랫폼 전체의 설계 철학이 보인다.
첫 번째 축은 CUDA-X다. CUDA-X는 이제 단순한 GPU 프로그래밍 언어를 넘어섰다. AI, 데이터 분석, 과학계산, 그래픽, 시뮬레이션, 로보틱스까지를 아우르는 거대한 가속 라이브러리 생태계로 진화했으며, 특정 개발 툴이 아니라 산업 소프트웨어 전반의 뼈대이자 표준 계층임을 강하게 주장하고 있다. 소프트웨어 생태계의 Lock-in 효과를 극대화하는 전략이기도 하다.
두 번째 축은 완성형 시스템이다. 이제 NVIDIA는 GPU 칩 하나를 파는 회사가 아니다. CPU, 네트워크, 메모리, 냉각, 랙(Rack), 설계, 운영, 안정성까지 포함한 완성형 시스템 단위로 접근한다. Vera Rubin NVL-72 발표에서도 아예 랙 단위 구조로 이야기한 것이 이를 상징적으로 보여준다.
03:22 - Vera Rubin NVL-72 랙 단위 구조 - 케이블 없는 설계와 빠른 배포 구조 설명
세 번째 축은 AI 팩토리(AI Factory)라는 개념 자체다. AI를 연구용 컴퓨터에 가둬두는 시대가 끝나고, “지능 토큰(Intelligence Token)을 대량 생산하는 새로운 시대의 공장”으로 보는 관점이다. 이 표현이 중요한 이유는, 앞으로의 데이터 센터가 웹서비스나 데이터베이스 중심이 아니라 AI 추론, 에이전트 실행, 합성 데이터 생성, 로봇 훈련, 물리 시뮬레이션을 전용으로 처리하는 공장형 인프라로 전환된다는 뜻이기 때문이다. 이렇게 되면 GPU 칩 하나의 성능표보다 랙 전체의 전력 효율, 네트워크 병목, 메모리 구조, 냉각 효율, 설치 난이도가 훨씬 중요한 구매 기준이 된다. Vera Rubin NVL-72가 케이블 없는(Cable-free) 구조와 빠른 배포(Rapid Deployment)를 강조한 것도 이 맥락이다. 쉽게 비유하면, 예전 NVIDIA가 좋은 엔진을 만드는 자동차 회사였다면, GTC 2026의 NVIDIA는 도로, 주유소, 정비망, 내비게이션, 교통 관제 시스템까지 세트로 파는 회사가 되겠다고 선언한 것이다.
OpenClaw와 NemoClaw: 에이전트 통제 계층의 확보
에이전트 AI 인프라에서 NVIDIA의 소프트웨어 전략은 OpenClaw와 NemoClaw로 구체화된다. NVIDIA는 OpenClaw 스택 위에 자사 모델인 Nemotron, 새로운 오픈소스 런타임, 보안 기능까지 얹어 에이전트 환경을 한 번에 구축하도록 설계했다. 이를 겉으로만 보면 누구나 쓸 수 있는 오픈 에이전트 비전처럼 보인다.
그러나 진행자는 이 부분에서 훨씬 날카로운 해석을 제시한다. 실제로는 에이전트 통제 계층(Agent Control Layer)을 NVIDIA가 자기 스택 안에 묶고 있다는 것이다. 즉, 개방성을 표방하면서도 핵심 실행 런타임, 보안 계층, 모델 패밀리를 자신들의 플랫폼에 의존하도록 설계하는 방식이다. 이런 전략의 실체는 NVIDIA가 공개한 모델 패밀리를 보면 더 선명해진다. 120B(1,200억) 파라미터급 Nemotron 3 Super, Cosmos, [알파마요 - 원본 영상 확인 권장], Isaac Bio-NeMo 같은 공개 모델들은 칩을 파는 하드웨어 회사를 넘어, 산업 군별 AI 모델 계열까지 다 묶는 풀스택(Full-Stack) 전략의 표현이다.
Vera CPU: 에이전트 시대가 다시 불러낸 CPU의 귀환
많은 이들이 AI 서버는 GPU 성능이 전부라고 생각하지만, 에이전트 AI 시대의 도래와 함께 CPU의 역할이 다시 핵심으로 부상하고 있다. 에이전트는 툴을 호출하고, 요청을 스케줄링하고, 네트워크를 처리해야 하는데, 이 작업들의 중심에는 여전히 CPU가 있기 때문이다. NVIDIA가 자체 개발한 Vera CPU는 바로 이 필요성에 응답한 결과물이다.
NVIDIA는 Vera CPU를 대놓고 “에이전트 AI를 위해 만들었다”고 선언했다. 88개의 Olympus 코어를 탑재하고, 컴파일러(Compiler)와 런타임(Runtime) 제어에 최적화된 높은 성능을 내세우는 것이 핵심 특징이다. 그러나 여기서 가장 중요한 포인트는 코어 수가 아니라 메모리 구조다. Vera CPU는 LPDDR5X와 SOCAMM(Small Outline CAMM, 서버용 저전력 메모리 모듈화 규격) 기반 구조를 채택했다.
05:52 - Vera CPU의 LPDDR5X SOCAMM 메모리 구조 설명 - 저전력 서버 메모리 모듈화 규격
전력을 많이 소비하는 서버용 DDR 메모리에서 벗어나 저전력·고대역폭 메모리가 데이터 센터 안으로 들어온 것이며, 이는 데이터 센터의 발열과 전력 문제를 구조적으로 해결하겠다는 NVIDIA의 강한 의지를 담은 선택이다. 루빈 플랫폼 안에서 Vera CPU는 단순한 부수 부품이 아니라, GPU·네트워크·스토리지와 함께 AI 팩토리를 구성하는 핵심 두뇌로 자리매김한다.
네트워크 인프라의 재편: 칩 성능을 넘어선 연결성 경쟁
수천 개의 칩이 묶여 돌아가는 AI 팩토리에서, 칩들 사이를 어떻게 연결하느냐는 시스템 전체의 가성비를 결정하는 핵심 변수다. NVIDIA가 루빈 플랫폼에서 “GPU 수를 줄이고 운영 비용을 대폭 낮출 수 있다”고 주장하는 배경에도 이 강력한 네트워크 구조가 자리한다.
구체적으로는 세 가지 기술 계층이 맞물려 작동한다. 랙 내부를 하나의 GPU처럼 묶는 NVLink 6, 랙과 시스템 전체를 잇는 Spectrum-X와 Quantum X800, 그리고 CPU와 함께 전력·발열을 줄이면서 속도를 끌어올리는 CPO(Co-Packaged Optics, 광통신 소자와 네트워크 칩을 하나로 패키징하는 기술)가 그것이다. HBM4가 아무리 빠르더라도 데이터가 지나가는 네트워크 경로가 막히면 의미가 없다. 결국 AI 인프라 경쟁력의 기준이 칩 성능 자체를 넘어, 네트워크·전력·냉각 효율의 복합적 조합으로 이동하고 있다는 것이 이번 GTC 2026의 또 다른 핵심 메시지다.
이종 가속기 시대의 개막: Groq LPX와 목적별 최적화
이번 GTC에서 가장 상징적인 장면 중 하나는, 줄곧 “우리는 GPU가 최고”를 외치던 NVIDIA가 Groq LPX(Language Processing Unit eXtended) 추론 가속기 랙을 루빈 플랫폼의 구성 요소로 공식 포함시킨 것이다. Groq LPX는 GPU처럼 범용(General-Purpose)이 아니라, 초저지연(Ultra-Low Latency)·대규모 컨텍스트 처리·예측 가능한 토큰 생성에 특화된 가속기다. 이 칩은 HBM 대신 128GB SRAM을 사용하는 독특한 아키텍처를 채택하고 있으며, 이 때문에 SRAM 특유의 낮은 지연(Latency)과 결정론적(Deterministic) 처리 특성을 활용할 수 있다.
⚠️ [STT 교정 주의] 원본 트랜스크립트에서 “그룹3 LPX”로 표기된 부분을 문맥 및 기술 도메인 지식에 근거하여 “Groq LPX”로 교정하였습니다. 정확한 명칭은 원본 영상에서 확인하시기 바랍니다.
이로써 AI 인프라는 CPU·GPU·LPU(Language Processing Unit)·네트워크를 목적별로 섞어 쓰는 이종 아키텍처(Heterogeneous Architecture) 시대가 공식화됐다. 이제 최적의 AI 팩토리란 단일 아키텍처를 극한까지 끌어올리는 것이 아니라, 각 워크로드(Workload)의 특성에 따라 가장 적합한 하드웨어를 배치하고 이를 유기적으로 연결하는 시스템 설계 능력이 된다. 에이전트 시대의 경쟁이 칩 회사 간의 경쟁에서 플랫폼 생태계 간의 경쟁으로 전환되는 것을 이 선택이 상징적으로 보여준다.
AI 시대의 메모리 계층 재편: GTC 2026의 또 다른 선언
진행자는 이번 GTC 2026이 사실상 “AI 시대의 메모리 계층 재편 선언”이었다고 평가한다. 루빈 플랫폼 전체를 관통하는 메모리 구조는 목적에 따라 명확히 분화되어 있다.
07:39 - HBM4, GDDR7, LPDDR5X SOCAMM, SRAM의 역할 분리 구조
역할별로 나누어 보면, GPU에는 가장 빠르고 비싼 288GB HBM4가 핵심 메모리로 탑재된다. Vera CPU에는 1.5TB LPDDR5X SOCAMM이 적용되어 저전력 고대역폭을 확보한다. 초거대 컨텍스트 추론에 특화된 루빈 CPX에는 비용 효율적인 GDDR7(128GB)이 들어가고, 초저지연 추론에 최적화된 Groq LPX는 SRAM(128GB) 중심 구조를 취한다. 이렇게 HBM4·GDDR7·LPDDR5X SOCAMM·SRAM이 역할을 분리해 계층화된 형태로 작동하는 것이 루빈 플랫폼의 메모리 구조적 특징이다.
SOCAMM이라는 규격 자체도 주목할 만한 포인트다. 스마트폰에 쓰이는 저전력 메모리인 LPDDR은 전기를 덜 먹지만, 서버 환경에서는 교체가 어렵다는 단점 때문에 그동안 데이터 센터에서 잘 활용되지 못했다. SOCAMM은 이 문제를 해결하기 위해 모듈화(Modularization)한 규격으로, 서버에서도 쉽게 탈착하며 운영할 수 있도록 설계되었다. NVIDIA가 루빈 플랫폼에 SOCAMM LPDDR5X를 전면 채택했다는 것은, 데이터 센터의 발열과 전력 문제를 저전력 메모리 아키텍처로 구조적으로 해결하겠다는 방향을 공식화한 것으로 해석된다.
삼성전자의 GTC 2026: 복귀 무대와 전략적 기회
반도체 관점에서 보면, 이번 GTC 2026은 삼성전자에게도 매우 중요한 무대였다. 삼성전자는 2026년 초 HBM4 양산 및 고객사 출하 소식을 공개했고, 현장에서는 차세대 제품인 HBM4E까지 선보였다.
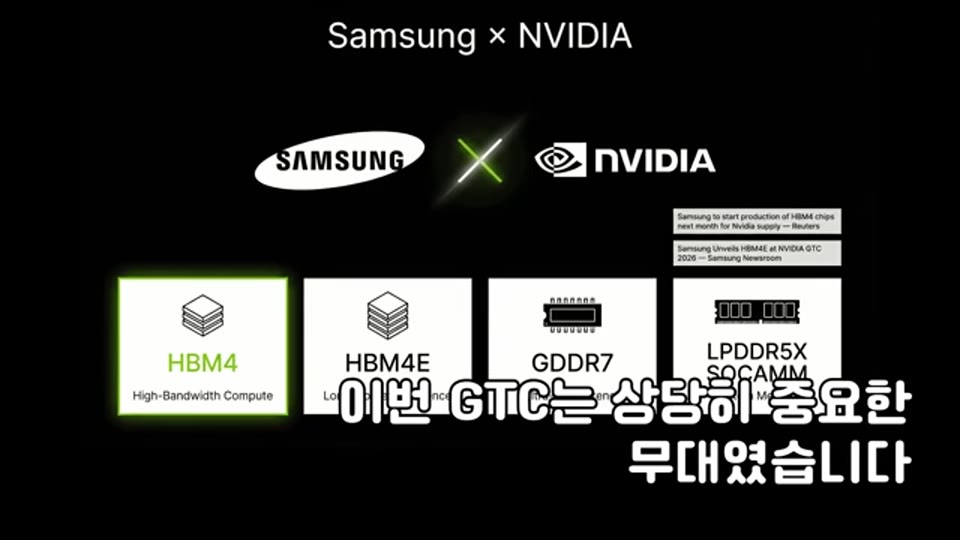
09:18 - 삼성전자 HBM4 양산 및 HBM4E 공개 관련 GTC 현장 발표 화면
그동안 HBM 경쟁에서 SK하이닉스에 비해 상대적으로 열세를 보였던 삼성 입장에서, 이번 GTC는 일종의 복귀 무대에 가까웠다고 볼 수 있다.
주목할 점은 삼성의 전략 방향이 단순한 메모리 공급자(Memory Supplier)를 넘어서고 있다는 것이다. NVIDIA의 디지털 트윈 및 제조 AI 흐름과 연계하며 판을 키우려는 행보가 감지되었다. 또한 많은 이들이 HBM에만 집중하는 동안, 루빈 CPX에 탑재되는 GDDR7의 중요성도 간과해서는 안 된다. 장문맥(Long Context)을 유지하면서 비용을 절감해야 하는 추론 환경에서는, 값비싼 HBM보다 가성비가 뛰어나고 용량이 넉넉한 GDDR7이 훨씬 유리한 경우가 많기 때문이다. 즉, HBM만이 아니라 GDDR까지 포함한 메모리 포트폴리오 전체가 중요해지는 시대가 되었고, 이 구도는 HBM·GDDR·LPDDR을 모두 다루는 삼성 입장에서 유리한 포인트가 될 수 있다.
SOCAMM 공급과 관련하여 진행자는 “NVIDIA가 SOCAMM을 채택했다는 것은 공식 팩트이지만, 삼성이 독점 공급하는지는 아직 공식 확정이 아니다”라고 명시하며, 현 시점에서는 유력 후보 정도로 보는 것이 적절하다고 판단했다. 다만 종합 메모리 솔루션을 제공할 수 있는 삼성의 입지는 이 다층화 시대에 분명한 경쟁력이 된다.
물리 AI의 본격화: 로봇과 디지털 트윈의 통합
AI는 이제 화면 속 텍스트 응답만이 아니다. 현실 세계로 나오는 물리 AI(Physical AI)가 본격화되고 있으며, 이번 GTC 2026에서는 Newton, Omniverse, Cosmos, GR00T(NVIDIA의 휴머노이드 로봇 파운데이션 모델)가 총출동했다.
로봇이 현실에서 가져야 할 신뢰성은 소프트웨어와 차원이 다른 요구사항을 만들어낸다. 현실에서 한 번의 실패가 큰 물리적 문제를 일으킬 수 있기 때문에, 실전 투입 전 방대한 양의 시뮬레이션과 합성 데이터(Synthetic Data)로 반복 학습이 필수적이다. 이 데이터를 찍어내는 공정이 바로 Open-MiLi AI Data Factory Blueprint다. NVIDIA가 이 행사에서 제시한 가장 큰 그림은, 컴퓨터 안에서 일하는 에이전트와 현실에서 움직이는 로봇을 같은 연장선의 플랫폼으로 묶어버리는 것이다. 이 통합 관점에서 Omniverse는 가상과 현실을 잇는 디지털 트윈 엔진으로, Cosmos는 물리 AI 학습을 위한 세계 시뮬레이터로 위치한다.
엔비디아의 영향력 확장: 데이터 센터를 넘어서
NVIDIA의 영향력은 이제 데이터 센터 안에만 머물지 않는다. 현대기아의 자율주행, T-Mobile의 통신망 연동, 글로벌 로보틱스, 우주 컴퓨팅까지 데이터 센터 바깥의 실제 산업과 엣지(Edge) 환경 전반으로 촉수를 뻗고 있다는 점이 이번 GTC 2026에서 재확인됐다. 특히 지멘스(Siemens) 같은 글로벌 산업 소프트웨어 기업들이 NVIDIA 생태계 아래로 편입되는 흐름은 단순한 파트너십을 넘어서는 구조적 변화를 의미한다.
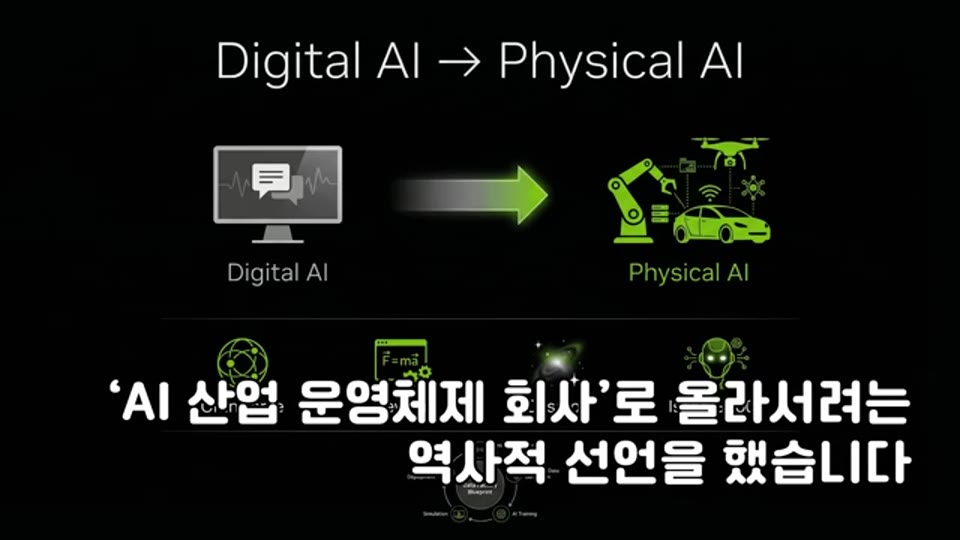
10:53 - 엔비디아의 산업 전방위 확장 - 지멘스 등 글로벌 산업 소프트웨어의 NVIDIA 생태계 편입
결국 칩·메모리·네트워크·에이전트·로봇·시뮬레이션이 모두 NVIDIA가 짜놓은 거대한 판 위에서 정렬되어 돌아가는 구조를 지향하고 있다. 이것은 특정 산업 영역의 지배가 아니라, AI 시대 산업 인프라 전체의 표준을 장악하려는 전략이다.
마무리 / 핵심 정리
NVIDIA의 GTC 2026은 역사적 선언이었다. 이 행사를 통해 NVIDIA는 AI 산업의 운영체제를 자임하는 회사로의 전환을 공식화했다. 훈련에서 추론으로, 모델 성능에서 인프라 효율로, 칩 한 개의 스펙에서 완성형 시스템 설계 역량으로—AI 경쟁의 판 자체가 바뀌고 있다.
이런 전환 속에서 인프라 설계의 기준도 달라졌다. 이제 승패를 가르는 것은 단일 칩의 성능이 아니라, CPU·GPU·LPU·메모리·네트워크·냉각을 목적에 맞게 조합하는 시스템 통합 능력이다. NVIDIA는 이 전체 판을 자신들이 설계하겠다는 야심을 이번 GTC 2026에서 가장 선명하게 드러냈다. 루빈 플랫폼이 단순한 GPU 세대 교체가 아니라 AI 팩토리 인프라의 새로운 표준을 제시하는 이유가 바로 여기에 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | 엔비디아 GTC 2026 키노트, 핵심만 깊게 정리 |
| 채널 | 안될공학 - IT 테크 신기술 |
| 리포트 작성 | 2026-03-18 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.