급되고 있다는 신호가 복합적으로 나타나고 있는 셈이다.
노령화 사회와 일본 1980년대의 교훈
교수는 일본의 1970~80년대 경험을 흥미로운 비유로 든다. 1970년대 일본 기업들은 화려한 성장기를 보냈지만 오히려 자금이 모자랐다. 급격한 성장에 맞춰 설비를 계속 증설해야 했기 때문이다. 그러나 1985년 플라자 합의(Plaza Accord) 이후 성장이 정체되면서 기업 규모는 이미 거대해진 반면 추가 투자처가 사라졌고, 넘쳐나는 자금이 주식과 부동산으로 쏠리며 1980년대 말 비정상적 자산 거품이 탄생했다. 현재 전 세계적으로 진행 중인 노령화 현상도 같은 메커니즘을 만들어낸다. 자녀가 어릴 때는 교육비, 의료비 등으로 돈이 실물경제로 나가지만, 자녀가 성장한 이후에는 투자 여력이 금융자산으로 집중된다. 수명이 길어지는데 은행 예금 이자만으로는 노후를 감당할 수 없는 상황에서, 신기술주가 희망의 빛을 보여주기만 하면 대규모 자금이 그쪽으로 쏠리는 구조가 이미 형성되어 있다.
💡 핵심 투자 전략: AI 병목 해소 집중
전략 원리 (Logic)
AI 인프라의 성장을 가로막는 병목은 크게 세 가지다. 첫째, 전력 부족—데이터 센터의 전력 수요가 에너지 인프라의 한계를 시험하고 있다. 둘째, 반도체 부족—빅테크들이 고가의 AI 반도체를 경쟁적으로 매입하면서 공급이 수요를 따라가지 못한다. 셋째, 데이터 통신 속도—초당 수십 테라바이트(TB)씩 데이터를 주고받아야 하는 AI 클러스터에서 기존 구리선이 물리적 한계를 드러내고 있다. 교수는 이 세 가지 병목을 해소하는 기술과 기업들이 AI 버블 여부와 무관하게 구조적 수혜를 받을 것이라는 관점 하에 포트폴리오를 구성하고 있다. 핵심은 “AI가 무너지더라도 그 인프라를 고치는 역할을 하는 기업들은 살아남는다”는 논리다.
실행 방법 (How-to)
교수의 개인 포트폴리오는 70%를 신기술·신성장주 ETF로 채우고 30%는 현금(Dry Powder)으로 유지한다. AI 버블이 와서 주가가 흔들리면, 그 30%의 현금으로 하락 시마다 추가 매수하는 Buy the Dip 전략이다. 그는 “한 테마만 찍으라면 AI 병목 해소 쪽”이라고 명확히 밝히며, 그 중에서도 레이저 광통신을 통한 데이터 전송 속도 혁신을 가장 핵심 테마로 꼽는다. 이는 2021년 Nvidia를 추천했던 경험과 같은 맥락이다. 당시 시장이 Nvidia를 단순한 GPU 업체로 볼 때 그는 CUDA 생태계가 만드는 시뮬레이션 플랫폼 표준화—진정한 해자(Moat)—를 보고 매수했다고 설명한다. 이후 주가가 반토막 나는 시기에도 오히려 큰돈을 버는 기회로 활용했다는 것이다. 지금 Marvell Technology에서 시장이 “통신·신호 처리 기술의 중요성을 간과”하고 있다는 점이 그때와 비슷하다고 교수는 진단한다.
주의 사항 (Risk)
AI 버블이 현실화될 경우 신기술주 전반의 동반 하락 리스크는 엄연히 존재한다. Shopify, Figma 같은 개인창업 인프라 기업들은 빅테크가 유사 서비스를 직접 출시하면 사업 모델 자체가 위협받을 수 있다. 실제로 Salesforce 주가 하락의 주된 이유가 Anthropic의 Claude 같은 AI가 CRM 기능을 직접 수행할 수 있다는 우려에서 비롯되었다. 교수는 이런 기업들이 생존하려면 빅테크가 쉽게 모방하기 어려운 핵심 경쟁력이 필요하고, 이것이 없으면 Microsoft의 GitHub 인수처럼 빅테크에 흡수되는 경로를 밟을 것이라고 진단한다. 또한 ChatGPT에 월 22달러를 내고 사용하던 교수 본인도 최근 무료 버전의 Gemini가 더 낫다고 느끼기 시작했다며 OpenAI의 경쟁 우위에 의문을 갖기 시작했다고 고백한 것은, 빅테크 AI 시장에서의 경쟁 지형 변화가 예측보다 빠를 수 있음을 시사한다.
AI 전력 소비의 구조적 분석
NVIDIA 수석 과학자가 밝힌 전력 배분의 진실
AI가 전력을 소모하는 방식은 일반적 인식과 크게 다르다. NVIDIA의 수석 과학자(Chief Scientist) Bill Dally는 실제 조사 결과를 바탕으로 AI 전력 소비를 네 항목으로 분류했다. 데이터 전송이 전체의 40%로 가장 크고, 그 과정에서 발생하는 발열을 냉각하는 데 35%, 실제 계산 자체에 15%, 데이터 유지·저장에 10%가 소모된다. 즉 우리가 ‘컴퓨팅 파워’라고 부르는 연산 그 자체는 전체 전력의 고작 15%에 불과하다. 나머지 85%는 데이터를 옮기고 그 과정의 열을 식히는 데 쓰인다. 이 사실은 AI 인프라 효율화의 핵심이 연산 속도 자체보다 데이터 이동 경로와 발열 관리에 있음을 명확히 보여준다.
37:20 - AI 전력 소비 구조: 데이터 전송 40%, 냉각 35%, 계산 15%, 저장 10% (NVIDIA Bill Dally 조사 기반)
더욱 주목할 만한 것은 병목 구간의 누설 전류 문제다. 신호가 정체되어 대기 상태에 놓일 때 전류가 그대로 소모되는 누설(Leakage) 현상이 상당한 전력 손실을 초래한다. 기존 구리선은 수많은 데이터가 몰릴 때 저항이 극대화되어 열이 발생하고, 이로 인해 신호가 약해지면 다시 증폭해야 하는데 이때 수백 배의 추가 전력이 소모된다. 이는 단순히 선을 굵게 만드는 것으로는 해결이 안 되는 구조적 문제이며, 초당 수십 테라바이트씩 데이터를 주고받아야 하는 미래의 AI 클러스터에서는 구리선이 물리적으로 불가능한 영역에 진입한다. 이것이 레이저 광통신(Laser Optical Communication)으로의 전환이 불가피한 물리적 근거다.
저전력 솔루션 기술 지형
SRAM의 재발견: GPU 내부에서 답을 찾다
HBM(High Bandwidth Memory)에서 GPU로 데이터를 가져오는 과정의 전력 낭비를 줄이기 위한 핵심 해법이 SRAM(Static Random-Access Memory)의 적극 활용이다. 교수는 이를 학생의 공부 환경으로 비유한다. GPU가 두뇌(계산기)라면, 책상 위에 펼쳐진 책들이 SRAM이고, 멀리 있는 책장의 책들이 HBM이다. 32비트 계산에 드는 기준 전력을 1로 놓을 때, 온칩 SRAM에서 데이터를 가져오는 데는 5~10의 전력이 소모되지만, HBM에서 가져올 경우 200~1,000까지 든다. 최대 200배에 달하는 전력 차이다. 이 때문에 자주 쓰거나 긴급한 데이터는 SRAM에 올려두고 처리하는 것이 에너지 효율 면에서 압도적으로 유리하다.
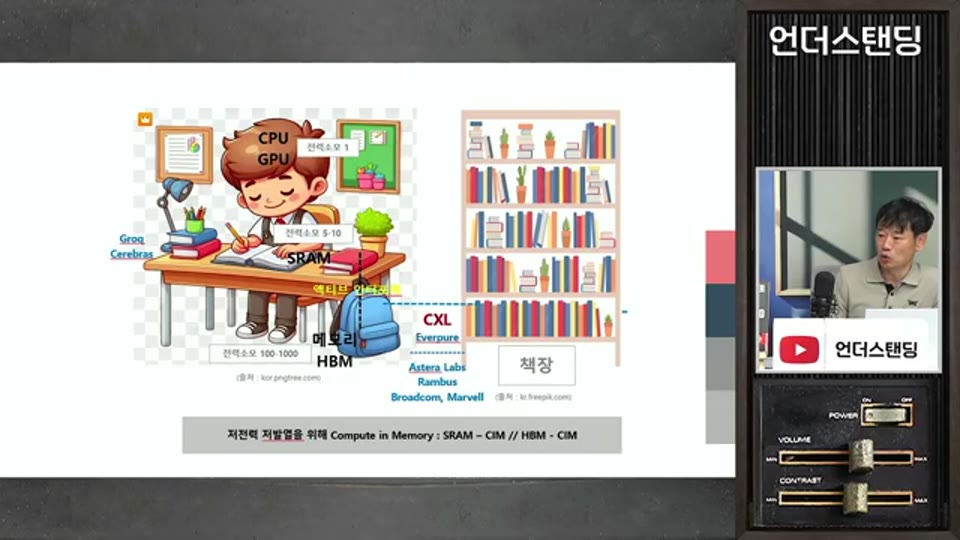
39:36 - SRAM vs HBM 전력 비교: 32비트 계산 기준 온칩 SRAM 5~10배, HBM 200~1000배 전력 소모
이 원리를 극단까지 밀어붙인 아키텍처가 Groq와 Cerebras의 접근법이다. 두 회사는 HBM을 사용하지 않고 SRAM만으로 칩 전체를 가득 채우는 방식을 선택했다. SRAM은 용량이 작고 부피가 크며 비용도 높다는 핸디캡이 있지만, 초저전력과 초저발열이 요구되는 특수 추론 환경에서는 탁월한 선택지가 된다. 한편 DRAM 가격이 상승하면서 SRAM과 DRAM의 가격 격차가 좁혀지고 있다는 점도 SRAM 활용의 경제성을 높이는 요인이다. GPU 내부에 SRAM을 충분히 넣기 어려운 경우를 위한 대안으로는, GPU 바깥쪽 인터포저(Interposer)에 SRAM과 간단한 연산기를 달아 처리하는 ‘액티브 인터포저(Active Interposer)’ 개념도 현재 개발되고 있다.
CIM/PIM: 메모리와 연산의 일체화
SRAM에서 데이터를 꺼내 연산하는 과정에서도 5~10배의 전력이 든다는 점에 착안한 것이 CIM(Compute-In-Memory) 또는 PIM(Processing-In-Memory) 아키텍처다. 메모리 안에 연산기를 직접 내장해, 데이터가 이동하지 않고 저장된 자리에서 바로 계산하는 일체형 구조다. AI 추론은 크게 두 단계로 나뉜다. 전체 맥락을 파악하는 프리필(Prefill) 단계는 방대한 데이터를 병렬 처리해야 하므로 HBM 기반의 HBM-CIM이 적합하고, 이후 개별 서비스를 순차적으로 처리하는 디코드(Decode) 단계는 SRAM만으로도 충분하여 SRAM-CIM이 효율적이다. 이처럼 추론 단계에 따라 최적화된 메모리-연산 아키텍처를 적용하는 것이 에너지 효율의 새로운 표준이 되어가고 있다.
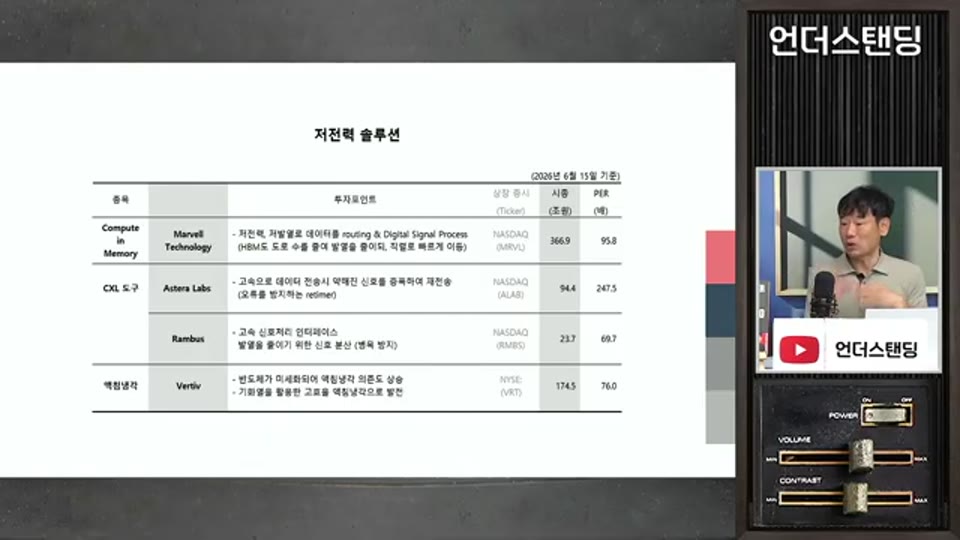
한 가지 중요한 오해를 교수는 짚어준다. CIM이라고 해서 데이터 이동이 완전히 사라지지는 않는다는 것이다. 메모리 내부에서도 데이터를 꺼내어 라우팅(Routing)하고 디지털 신호 처리(DSP)를 수행해야 한다. 바로 이 좁은 칩 공간 안에서의 고속 신호 처리와 인터커넥트(Interconnect) 기술에서 독보적 강점을 가진 기업이 Marvell Technology다. Marvell이 2021년에 인수한 Inphi가 이 분야의 최강자이며, Google, Microsoft, Amazon 같은 빅테크들이 ASIC을 설계할 때 통신 부분에서는 Inphi 기술을 쓸 수밖에 없어 사실상 “갑질”이 가능한 수준의 협상력을 가지고 있다고 업계에서 이야기가 나올 정도라고 교수는 전한다.
CXL: 분산 메모리 공유의 미래
CXL(Compute Express Link)은 HBM보다 물리적으로 더 먼 거리에 있는 메모리 풀을 여러 서버가 공유하는 기술이다. 얼핏 거리가 멀어 전력 소모가 더 클 것처럼 보이지만, CXL의 진정한 가치는 시스템 전체의 메모리 가동률 최적화에 있다. 평소에는 메모리 모듈 6개면 충분하지만, 피크 타임(Peak Time)에 10개가 필요한 서비스가 있다고 가정하자. 기존에는 항상 10개를 켜두어야 했다. CXL을 활용하면 피크 타임에만 다른 서버에서 모듈을 빌려쓰고, 나머지 시간에는 유휴 메모리를 끌 수 있다. 쓰지 않는 메모리를 유지하는 데 드는 전력 자체가 없어지는 것이다. 서버 간, 나아가 데이터 센터 간 메모리를 연결하고 공유하는 이 기술이 본격화되면, 반도체 구매량 자체도 줄일 수 있어 빅테크 입장에서는 비용 절감 효과도 기대된다.
CXL 아키텍처에서 빅테크가 담당하는 역할은 오케스트레이션(Orchestration)—데이터를 실시간으로 어디에 둘지 결정하는 것—이다. 그러나 거리가 멀수록 고속 전송 중 신호가 끊기거나 약해지는 문제가 생긴다. 이 신호를 재전송하거나 약해진 신호를 증폭해 에러를 없애는 역할을 담당하는 기업이 Astera Labs다. 또한 신호가 특정 경로에 쏠리지 않도록 분산시켜 병목을 줄이는 인터페이스 솔루션은 Rambus[랩버스: STT 오류 가능성 있음, 원본 영상 확인 권장]가 제공한다.
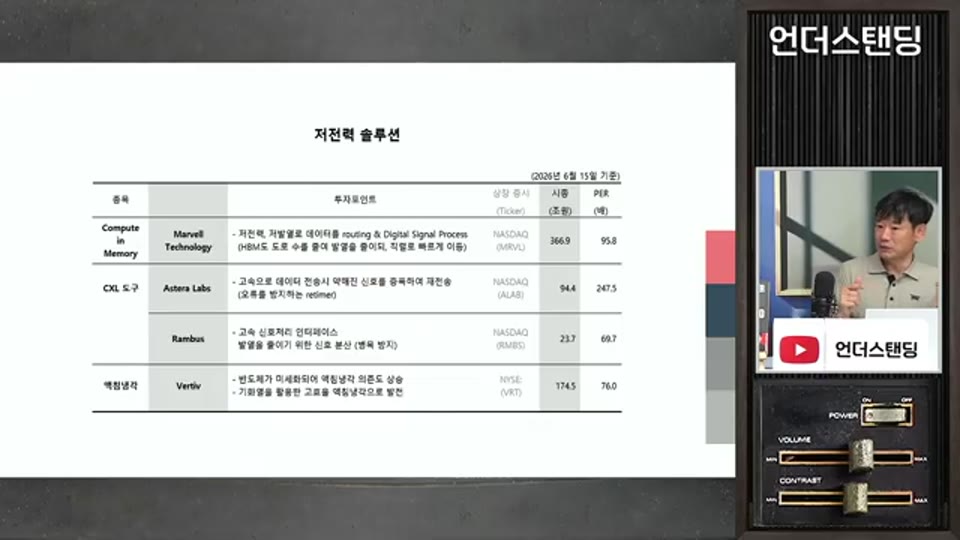
49:18 - CXL 아키텍처: Astera Labs(신호 증폭), Rambus(신호 분산) 역할 구분
교수는 3월 출연에서 이 두 기업을 언급한 이후 주가가 두 배가 됐다고 밝히면서도, CXL이 본격화되는 시기가 2028년임을 감안하면 아직 여정의 초입이라는 입장을 유지한다. 현재 이 기업들이 소형주라는 점은 리스크이자 동시에 기회다.
기타 저전력 최적화 기법과 반도체 수요 감소의 역설
MoE(Mixture of Experts, 혼합 전문가 모델)는 전체 모델을 구동하는 대신 해당 입력과 관련된 전문가 모듈만 선택적으로 활성화해 불필요한 계산을 줄이는 아키텍처다. TPU(Tensor Processing Unit), NPU(Neural Processing Unit) 같은 AI 특화 칩의 부상도 같은 방향이다. 범용 GPU는 다양한 연산을 처리하지만 발열과 전력 소모가 크다. 특화된 연산만 수행하는 칩을 쓰면 전력 효율이 크게 개선된다. 양자화(Quantization) 기법으로 데이터 정밀도를 낮추고 모델 크기를 줄이는 것도 메모리 전송 부담을 줄이는 방법이다.
교수는 여기서 중요한 역설적 관계를 짚는다. AI의 에너지 효율을 높이는 방향이 곧 반도체를 덜 쓰는 방향과 일치한다는 것이다. 전력을 아끼려면 데이터 이동을 줄여야 하고, 데이터 이동을 줄이려면 메모리 용량을 최적화해야 하며, 결국 반도체 소비량이 줄어든다. AI가 진화할수록 반도체 수요가 폭발적으로 늘어날 것이라는 단순한 기대와 달리, 이 흐름은 한국의 메모리 반도체 업체(삼성전자, SK하이닉스)에 장기적으로 구조적 위협이 될 수 있다는 점을 교수는 명확히 경고한다.
핵심 주목 기업 분석
Marvell Technology: AI 인터커넥트 패권의 집중
Marvell Technology는 이 강연에서 교수가 가장 강조하는 핵심 투자 대상이다. 2021년 Inphi 인수가 그 근거의 핵심이다. Inphi는 HBM 스택 내부에서 구멍(TSV: Through-Silicon Via)을 적게 뚫고도 직렬 배열로 고속 전송량을 확보하는 독자적 설계 방식을 보유하고 있다. 구멍이 많을수록 도로가 넓어져 데이터를 많이 보낼 수 있지만 발열이 심해지는 반면, Inphi의 방식은 통로는 적더라도 빠른 속도로 보내 열을 최소화한다.
43:14 - Marvell/Inphi의 HBM 내부 직렬 배열 통신 설계: TSV 최소화로 발열 억제
이 기술은 빅테크들이 맞춤형 ASIC을 설계할 때 통신 부분에서 반드시 채택할 수밖에 없는 수준이어서, Google, Microsoft, Amazon 등을 고객으로 두고 있다. 로보틱스 등 Physical AI로 발전할수록 AI 칩이 주변 환경과 빠르게 교신하는 능력이 점점 더 중요해지는데, 이 분야에서 Marvell이 Broadcom의 점유율을 빼앗아갈 것이라는 것이 교수의 전망이다.
레이저 광통신 측면에서도 Marvell/Inphi의 위상은 독보적이다. 초당 수십 테라바이트 전송이 일상화될 미래에 구리선이 한계에 도달하면, 레이저 광통신으로의 전환은 선택이 아닌 필수다. Coherent, Corning 같은 관련 업체들도 있지만, 그 중에서 부가가치가 가장 높은 솔루션 공급자로 교수는 Marvell Technology를 꼽는다. 아직 시장이 이 통신·신호 처리 기술의 중요성을 충분히 반영하지 못하고 있다는 점이, 2021년 Nvidia 투자 때와 유사한 상황이라는 것이 그의 판단이다.
Astera Labs와 Rambus: CXL 인프라의 숨은 수혜자
Astera Labs는 CXL 고속 데이터 링크에서 발생하는 신호 열화 문제를 해결하는 신호 증폭 및 재전송 전문 기업이다. 2028년 CXL 본격화라는 명확한 타임라인이 있고, 현재 소형주 단계에서 교수가 3월에 언급한 이후 두 배 이상 상승했다. 그러나 교수는 CXL이 서버 간, 데이터 센터 간 메모리 연결로 확장될 경우 그 시장 규모가 현재 주가에 충분히 반영되지 않았다고 본다. Rambus(랩버스) 역시 CXL 인터페이스에서 신호 분산 및 병목 해소 솔루션을 제공하며 같은 맥락의 수혜를 받고 있다.
투자 관점에서 교수는 “퍼스트인 클래스(First-in-Class)“와 “베스트인 클래스(Best-in-Class)“의 개념을 구분한다. VC들이 초기 기업에 투자할 때 가장 먼저 묻는 질문이 “네가 이 사업을 제일 먼저 시작했느냐, 아니면 이 분야에서 제일 잘하느냐”인데, 직접 창업 경험에 비춰보면 퍼스트인 클래스가 훨씬 유리하다고 한다. 처음 시장을 개척하면서 자연스럽게 베스트인 클래스가 될 가능성이 높고, 노하우와 핵심 인재를 먼저 확보할 수 있기 때문이다. 설령 사업이 더 이상 성장하지 못하더라도 그 역량 자체가 M&A의 대상이 되어 높은 가격에 팔릴 수 있다. Astera Labs와 Rambus가 이 기준을 충족하는지가 장기 투자 판단의 핵심이다.
개인창업 인프라 기업들: 저평가된 장기 테마
Shopify, Figma, GitHub(Microsoft 산하)는 AI 기반 개인창업 시대를 뒷받침하는 인프라 기업들이다. Shopify는 쇼핑몰 구축부터 고객 관리, 물류, 결제까지 패키지로 제공하며, Figma는 아이디어를 시각화해 투자 유치를 가능하게 하는 디자인 플랫폼이다. GitHub는 창업 초기 기업이 저렴하게 개발자를 찾고 협업할 수 있는 소스코드 저장소로 기능한다. 이 기업들은 민간 주도 창업 경제가 아직 본격화되지 않아 주가가 눌려 있는 상태다. 그러나 AI가 개인 창업 문턱을 낮추는 흐름이 가속화되면 이들의 플랫폼 수요가 급증할 가능성이 있다. 교수는 주가가 충분히 낮아진 지금 이 기업들을 밑에서 조금씩 매수해두면, 당장은 오르지 않더라도 나중에 빛을 발할 시기가 올 것이라는 관점을 밝혔다.
냉각 솔루션: 공냉에서 2상 액침 냉각으로
AI 칩이 초고집적화되면서 열 밀도(Thermal Density)가 급증하고 있다. 현재 데이터 센터 냉각의 약 60%는 여전히 공냉식(Air Cooling)이다. 비용이 저렴하기 때문이다. 그러나 AI 클러스터처럼 고밀도로 집적된 환경에서는 공냉으로 열을 충분히 빼낼 수 없다. 결국 서버를 통째로 액체에 담그는 액침 냉각(Immersion Cooling)으로의 전환이 불가피해지고 있다.
현재의 단상(Single-Phase) 액침 방식은 액체를 순환시켜 25~50도로 온도를 유지하는 구조다. 다음 단계는 2상(Two-Phase) 액침 냉각이다. 냉각 유체가 약 50도에서 기화(Vaporize)하면서 주변 열을 빼앗아 가는 기화열(Heat of Vaporization) 원리를 활용한다. 기화할 때 주위 열을 흡수하므로 냉각 효율이 크게 향상되고, 기체를 다시 액화하는 것이 액체를 직접 냉각하는 것보다 에너지 효율도 높다.
54:45 - 2상 액침 냉각 원리: 기화 온도 설계 및 열 회수 메커니즘
이 기술의 핵심은 기화 온도를 50도보다 더 낮추는 것인데, 이를 위해 분자 결합을 느슨하게 해주는 특수 유전체 유체(Dielectric Fluid)를 개발하는 기업으로 교수는 VOLTF[기업명: STT 오류 가능성 있음, 원본 영상 확인 권장]를 언급했다.
소형모듈원자로(SMR): 지속 가능하지만 소외된 에너지
이용 가능성 vs 지속 가능성의 이분법
AI 전력 수요를 충족시키기 위한 에너지 공급에는 두 가지 접근이 존재한다. 빅테크들은 현재 ‘이용 가능한(Available)’ 에너지라면 경제성을 따지지 않고 쓴다. 바다나 사막의 태양광·풍력 전기를 데이터 센터로 보내거나, 데이터 센터 내부에 소형 천연가스 터빈을 직접 설치해 상업성이 없어도 감수하고 사용한다. 심지어 통신망이 없는 외딴 지역의 전기로 계산을 수행하고 결과를 위성으로 보내는 방식까지 검토되고 있다. 승자독식 게임에서 밀리면 끝이라는 절박함이 경제성 논리를 압도하고 있는 셈이다.
반면 SMR(Small Modular Reactor, 소형 모듈 원자로)은 장기적으로 가장 ‘지속 가능한(Sustainable)’ 에너지원이지만, 당장의 이용 가능성이 부족해 시장에서 소외되고 있다. 핵심 문제는 4세대 SMR에 필요한 고농축 우라늄(우라늄-235 비중 20% 이상)의 공급 부족이다. 현재 이 농축 우라늄 생산의 상당 부분을 러시아의 Rosatom이 독점하고 있는데, 전쟁으로 인해 공급이 불안정하다. 미국이 Centrus Energy에 보조금을 지원하며 국내 생산을 독려하고 있지만, 양산 가능 시기는 빨라야 2028~2029년이다. 또한 처음 짓는 SMR인 만큼 공사 기간 연장과 시행착오로 인한 초기 손실이 천문학적 규모에 달해, 개별 민간 기업이 장기 계획을 확약하기 어렵다. 이는 결국 정부가 나서야 해결되는 구조인데, 트럼프 행정부가 천연가스 쪽에 더 힘을 실어주고 있어 SMR 가속화가 더디다는 것이 교수의 평가다.
SMR 생태계와 장기 투자 관점
미국에는 Bill Gates가 지원하는 TerraPower, Amazon이 후원하는 X-energy, NuScale Power 등이 SMR 사업을 추진 중이다. 기술 면에서는 BWX Technologies가 핵잠수함용 고농축 우라늄(90% 이상) 생산 노하우를 보유하고 있어 민간 SMR 확대의 기술적 기반이 될 수 있다. 장기적으로는 SMR의 열(약 300도)을 이용해 천연가스를 탄소와 수소로 분리하는 청록 수소(Turquoise Hydrogen) 개념이 SMR의 부가가치를 더욱 높일 수 있다. 탄소는 분리 즉시 탄소 나노튜브와 같은 고부가 소재로 활용하고, 수소는 전기 생산에 쓰는 구조다. Plug Power는 이 수소 경제의 중간 고리로서, 신재생 에너지의 잉여 전력으로 수소를 생산·운반하는 역할을 담당하며 주목받고 있다.
교수는 SMR 관련 주식들이 현재 주가가 헤매고 있지만, 구조적으로 지속 가능성이 높기 때문에 하락할 때마다 분할 매집하겠다는 전략을 밝혔다. 한국에 대해서도 긍정적인 언급이 있었다. 한국은 원전 기자재 분야에서 세계적 경쟁력을 갖추고 있어 SMR 건설 속도를 앞당길 수 있는 잠재력이 있으며, 빅테크들이 한국에 데이터 센터를 세우려는 움직임도 이러한 에너지 인프라 역량과 무관하지 않다는 시각이다.
마무리: 결론 및 핵심 메시지
김학주 교수는 AI 버블의 가능성 자체를 부정하지 않는다. 역사적 패턴에 비추어 일시적 붕괴는 충분히 가능한 시나리오다. 그러나 AI가 과거의 거품들과 결정적으로 다른 것은 소비자에게 실질적 구매력을 전달할 역량을 내장하고 있다는 점이다. 빅테크의 승자독식 게임을 통한 깊은 AI 개발, AI 교육 혁명을 통한 대중의 경제 참여 확대, 그리고 이를 통한 부가가치 창출의 선순환이 실현되면, AI 버블이 꺼지더라도 회복력은 어느 역사적 거품보다 강하게 나타날 것이다.
투자 전략적 결론도 명확하다. 돈이 몰릴 곳을 한 테마로 압축한다면 “AI 병목 해소”다. 전력 절감 솔루션(SRAM, CIM/PIM, CXL), 반도체 공유 인프라(CXL), 그리고 레이저 광통신을 통한 데이터 전송 속도 혁신이 그 세 축이다. 이 모든 흐름에서 교차하는 핵심 기업이 Marvell Technology이며, Inphi 인수를 통해 구축한 독보적 기술 포트폴리오가 AI 인프라의 다음 장을 이끌 것이라는 것이 교수의 확신이다. 에너지 측면에서는 당장은 소외되고 있지만 지속 가능성이 명확한 SMR 관련 기업들을 하락 시마다 매집하는 전략이 장기적으로 유효하다고 본다. 버블이 오면 무너지겠지만, 무너질 때마다 살 수 있는 현금을 30% 쥐고 기다리는 것이 이 시대를 대하는 교수의 방식이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | AI 버블 꺼져도 돈은 결국 여기로 몰린다 |
| 채널 | 언더스탠딩 : 세상의 모든 지식 |
| 출연자 | 김학주 교수 (한동대학교) |
| 리포트 작성 | 2026-06-19 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.