API 비용을 0으로 만들어줄 역대급 On Device AI! Gemma 4!
📺 원본 영상: API 비용을 0으로 만들어줄 역대급 On Device AI! Gemma 4! 🎙️ 채널: 코드팩토리 📅 정리 일자: 2026-04-03 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(코드, 데모 화면, 수치 비교표 등)는 포함되지 않을 수 있습니다.
개요
Google이 Gemma 4 모델을 공개하면서 온디바이스(On-Device) AI 생태계에 다시 한번 중요한 변곡점이 찾아왔다. 이 영상에서 코드팩토리 채널의 강연자는 Gemma 4의 Edge 라인업인 2B(20억 파라미터) 및 4B(40억 파라미터) 모델을 Android 에뮬레이터에 직접 탑재해 텍스트 생성, 이미지 인식, 음성 인식을 실시간으로 테스트한 결과를 공유한다. 핵심 메시지는 명확하다. 외부 API를 호출하지 않아도 기기 자체에서 충분한 수준의 AI 추론이 가능한 시대가 빠르게 가까워지고 있다는 것이다.
Gemma 3의 실패, 그리고 Gemma 4의 등장
강연자가 이 영상에서 Gemma 4를 특별히 주목하는 이유는 단순한 신제품 소개가 아니라 직접 체감한 세대 간 격차 때문이다. 강연자는 약 1년 전 연애 시뮬레이션(미연시) 스타일의 여자친구 앱과 일정 관리 앱을 개발하던 시기에 Gemma 3 모델을 로컬 환경에서 테스트해본 경험을 가지고 있다. 당시의 평가는 가혹했다. 한국어 생성 품질이 현저히 낮았고, 문법 오류가 빈번하게 발생했으며, 추론 속도는 실사용이 불가능한 수준이었던 데다 RAM 점유율까지 높아 결국 서비스 적용을 포기했다고 한다.
바로 이런 배경이 있기 때문에, Gemma 4 Edge 모델이 보여주는 개선 폭이 강연자에게 유의미한 놀라움으로 다가온 것이다. 단순히 “더 좋아졌다”는 수준이 아니라 “이 정도면 실제 서비스에 투입해볼 수 있겠다”는 판단 임계점을 넘었다는 점이 이번 영상의 핵심 주장이라고 할 수 있다.
Gemma 4 Edge 모델 사양
Gemma 4 라인업 전체를 살펴보면 31B와 26B 등 고성능 컴퓨팅을 지향하는 모델들도 존재하지만, 강연자가 집중하는 것은 엣지(Edge) 환경을 위한 E2B(2B 파라미터)와 E4B(4B 파라미터) 모델이다. 강연자의 추측에 따르면 모델명의 ‘E’는 ‘Edge’의 약자로, 스마트폰 같은 저전력 기기에서의 구동을 최우선 목표로 설계된 것으로 보인다.
공개된 사양 기준으로 이 Edge 모델들은 Advanced Reasoning(고급 추론), Agent Workflow, Function Calling(함수 호출), 코드 생성, Vision(이미지 및 오디오 인식)을 모두 지원하며, 컨텍스트 길이는 128K 토큰까지 처리 가능하다. 지원 언어는 140개 이상으로 명시되어 있으며, 강연자는 한국어 테스트 결과가 실용적인 수준임을 직접 확인했다고 밝혔다.
실제 구동에 필요한 메모리 요구량도 중요한 실용적 지표다. 강연자가 Android 에뮬레이터 환경에서 테스트한 결과, 2B 모델은 약 6~8GB의 RAM으로 구동이 가능했지만, 4B 모델은 에뮬레이터 기준으로 16GB 이상이 필요했으며 8GB를 할당했을 때는 앱이 강제 종료되는 현상이 발생했다. 다만 강연자는 실제 물리 기기나 iOS 환경에서의 요구 사양은 다를 수 있음을 전제로 달아두었다.
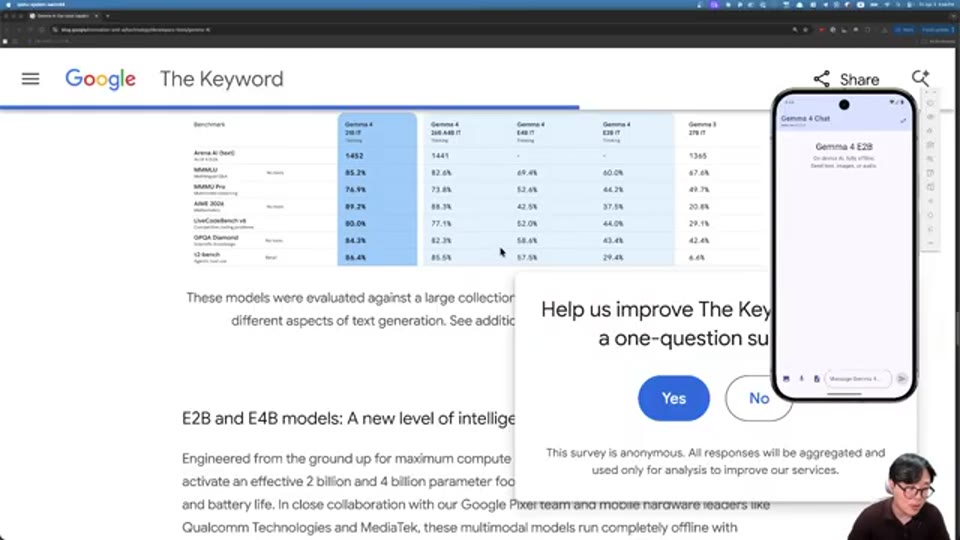
02:17 - Android 에뮬레이터에서 Gemma 2B와 4B 모델을 탑재한 실제 구동 화면. 메모리 할당량과 로딩 상태 확인 가능.
텍스트 생성 테스트: 2B vs 4B
강연자는 두 모델의 텍스트 생성 품질을 비교하기 위해 동일한 프롬프트를 투입하는 방식을 선택했다. “지금부터 내 여자친구야, 귀여운 톤으로 대답해줘”라는 역할 부여 지시를 입력했을 때, 2B 모델과 4B 모델은 확연히 다른 결과를 보였다.
2B 모델의 경우 역할을 수행하려는 시도 자체는 성공했지만, 강연자의 표현에 따르면 “사무적인 어조에 억지로 톤을 덧입힌” 느낌이었다. 반면 4B 모델은 오늘 하루 어땠는지 묻고, 피로를 공감하며 음식을 시켜주거나 곁에서 토닥여주겠다고 제안하는 등 훨씬 자연스러운 맥락 파악 능력을 보여주었다. 강연자는 “지금도 누가 봐도 인공지능이긴 하지만, 그래도 기분이 조금 더 좋아지는 느낌”이라고 표현했다.
주목할 만한 또 다른 변화는 속도다. Gemma 3 대비 텍스트 생성 속도가 압도적으로 빨라졌으며, 문법 오류 빈도도 크게 줄었다고 강연자는 평가했다. 단순 텍스트 출력이 요구되는 서비스 영역에서는 온디바이스 투입을 진지하게 고려해볼 수 있는 수준에 도달했다는 것이 강연자의 결론이다.
이미지 인식 테스트: 개선되었지만 아직 한계 존재
이미지 인식 테스트는 강연자가 즐겨 마시는 Kavalan(카발란) 위스키 캔을 피사체로 삼아 진행되었다.
2B 모델은 이미지를 분석하며 액체류가 들어있고, 노란색과 초록색이 구성에 포함되어 있다는 일반적 수준의 묘사에 그쳤다. ‘K’와 ‘V’ 알파벳이 포함된 상표 텍스트를 제대로 판독하지 못했으며, 전반적인 색감 파악에만 머물렀다고 강연자는 설명했다. 강연자는 이 수준을 ChatGPT 3과 3.5 사이 정도에 비유했다.
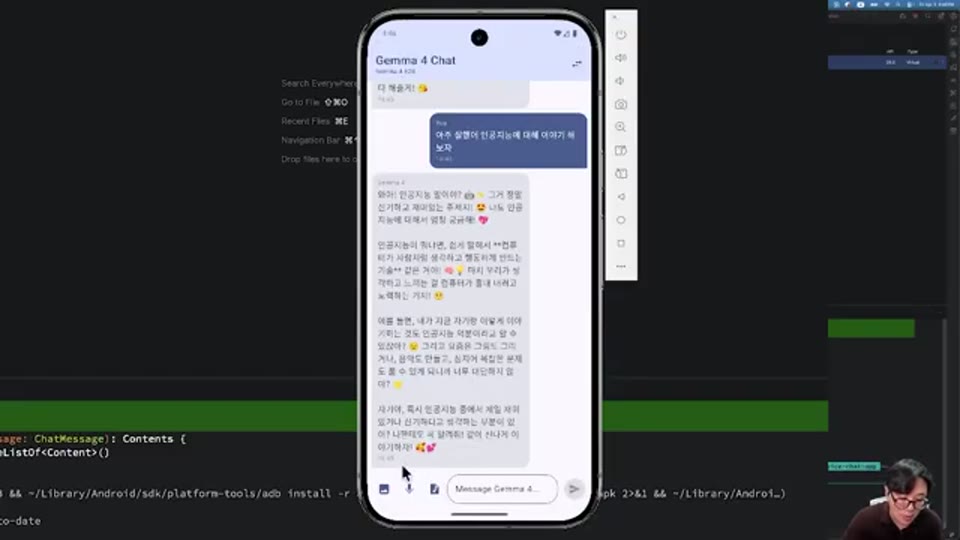
03:47 - Kavalan 위스키 캔 이미지를 2B 모델에 입력한 이미지 인식 결과 화면. 색상 및 텍스트 인식 정확도 확인.
05:06 - 4B 모델로 전환하는 장면. 로딩 시간 및 메모리 요구량 차이 확인 가능.
4B 모델은 한 단계 나아간 결과를 보여주었다. 캔이 정확히 4개임을 인식하고, 각 캔별 색상 특성을 개별적으로 분석했으며, “홍보용 사진으로 보인다”는 맥락적 해석까지 제시했다. ‘Wildly’라는 영문 텍스트도 식별해냈지만, ‘K’와 ‘V’를 혼동하는 오류는 여전히 반복되었다. 강연자는 이 정도의 이미지 인식 수준은 여전히 완벽하지 않으며, 멀티모달(Multimodal) 기능은 아직 개선이 필요하다고 평가했다.
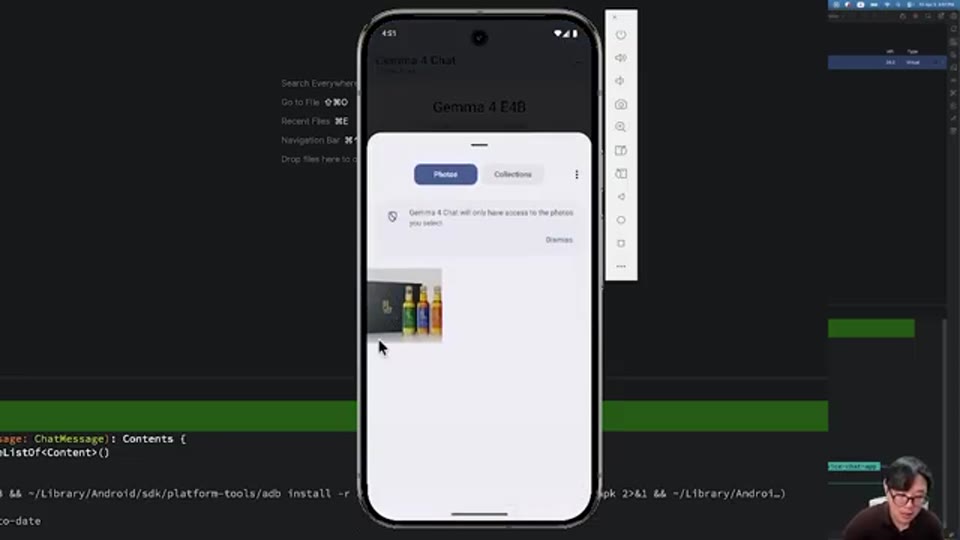
06:19 - 동일한 Kavalan 이미지를 4B 모델로 분석한 결과 화면. 캔 개수(4개) 인식 및 각 캔별 상세 분석 내용 확인.
음성 인식 테스트: 80% 수준의 한국어 전사
음성 인식(Audio Transcription) 테스트는 두 단계로 진행되었다. 먼저 “Hello, can you transcribe the audio”라는 영어 음성을 입력했을 때, 두 모델 모두 정확하게 텍스트로 전사하는 데 성공했다. 영어 음성 인식 자체는 실용 수준에 이른 것으로 보인다.
04:23 - 영어 음성 ‘Hello, can you transcribe the audio’를 입력한 음성 인식 결과 화면. 정확한 전사 결과 확인.
한국어 음성 인식 테스트는 강연자가 직접 애국가를 낭독한 음성을 입력하는 방식으로 진행되었다. 2B 모델은 “동해물과 백두산이 마르고 닳도록”과 같은 초반 가사는 비교적 잘 인식했지만, “대한 사람 대한으로 길이 보전하세”와 같은 구절에서는 오류가 발생했다. 강연자는 전체적으로 약 80% 정도의 정확도를 달성한 것으로 평가했다. 4B 모델도 같은 구절을 처리했을 때 유사한 오류 패턴을 보였으며, 강연자는 음성 인식 정확도 측면에서 두 모델 간의 차이가 크지 않다고 판단했다.
07:14 - 4B 모델로 강연자의 애국가 낭독 음성을 전사한 결과 화면. 한국어 음성 인식 정확도 및 오류 패턴 확인.
결론적으로 강연자는 음성 및 이미지 기반의 멀티모달 기능은 현재 온디바이스 수준에서 아직 본격적인 서비스 투입에는 부족하며, 더 많은 파라미터를 가진 모델이 필요하지만 그것은 현실적으로 스마트폰에 탑재하기 어렵다는 딜레마가 존재한다고 분석했다.
온디바이스 AI의 현재와 미래
강연자의 이번 테스트가 도달한 핵심 결론은 영역별로 명확하게 구분된다. 텍스트 기반 작업에서는 Gemma 4 Edge 모델이 이미 실용 가능한 수준에 도달했으며, 단순 텍스트 생성이나 챗봇 기능을 요구하는 서비스라면 외부 API 없이 온디바이스로 처리하는 것을 진지하게 검토할 수 있다. 반면 이미지 인식과 음성 인식 등 멀티모달 기능은 아직 완성도가 부족하여, 이를 핵심 기능으로 사용하는 서비스에서는 여전히 클라우드 API에 의존해야 한다.
그러나 강연자가 더욱 강조하는 것은 발전 속도다. Gemma 3에서 Gemma 4로의 한 세대 진화만으로도 체감 성능 차이가 매우 컸기 때문에, Gemma 5 수준이 되면 텍스트 인식의 정교함은 물론 멀티모달 기능도 현재보다 훨씬 높아질 것으로 전망했다. 강연자는 한두 세대만 더 지나면 온디바이스 AI 활용 방식이 개발자들 사이에서 폭넓은 관심을 끌 것이라고 예측하며, 그 결정적 이유로 API 비용 절감을 꼽았다.
특히 앱 서비스를 개발 중인 개발자라면, 지금 당장 Gemma 4를 기본 모델로 채택하지 않더라도 폴백(Fallback) 전략의 일환으로 탑재를 검토해볼 가치가 있다는 것이 강연자의 실용적 제언이다. 클라우드 API 호출이 실패하거나 비용을 절감해야 하는 상황에서, 기기 내부에서 돌아가는 보조 모델이 사용자 경험을 유지하는 안전망 역할을 할 수 있다는 시나리오다.
마무리 / 핵심 정리
이 영상은 화려한 벤치마크 숫자보다는 실제 개발자의 시선으로 온디바이스 AI의 현실적인 가용성을 점검한 실험 보고서에 가깝다. Gemma 3 시절에 직접 좌절을 경험했던 강연자가 Gemma 4에서 긍정적인 가능성을 발견했다는 점은, 단순한 홍보 콘텐츠와 차별되는 신뢰감을 준다.
결국 이 영상이 던지는 질문은 하나다. “지금 당신이 Claude API나 OpenAI API에 지불하고 있는 비용 중 얼마를, 사용자의 기기에서 무료로 처리할 수 있는가?” 텍스트 중심의 기능이라면 그 비율이 생각보다 높을 수 있으며, Gemma 4 Edge 모델은 그 가능성을 현실적으로 테스트해볼 수 있는 첫 번째 의미 있는 도구가 되었다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | API 비용을 0으로 만들어줄 역대급 On Device AI! Gemma 4! |
| 채널 | 코드팩토리 |
| 리포트 작성 | 2026-04-03 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Gemma, DeepMind’s Family of Open Models — Omar Sanseviero, Google DeepMind
- From 46% to 90% - Fine-Tuning Tiny LLMs for On-Device Agents - Cormac Brick, Google
- AI on Android - Ask me Anything — Florina Muntenescu & Oli Gaymond, Google DeepMind
- Robotics — Cormac Brick, Google
- Accelerating AI on Edge — Chintan Parikh and Weiyi Wang, Google DeepMind