Accelerating AI on Edge — Google DeepMind의 엣지 AI 가속 전략
📺 원본 영상: Accelerating AI on Edge — Chintan Parikh and Weiyi Wang, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-06 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Google AI Edge 소속 LightRT 프로덕트 매니저 Chintan Parikh은 AI Engineer 컨퍼런스에서 온디바이스(On-Device) AI 배포의 현재와 미래를 다루는 강연을 진행했다. 강연은 Google DeepMind가 최근 출시한 Gemma 4 엣지 모델의 새로운 에이전트 기능 소개와, 이를 실제 기기에 배포하기 위한 LightRT 프레임워크 스택 전반을 포괄한다. 클라우드 의존도를 낮추고 싶은 개발자, 실시간 추론이 필요한 애플리케이션 개발자, 그리고 IoT까지 포함한 광범위한 플랫폼 커버리지를 필요로 하는 팀 모두에게 실질적인 정보를 제공하는 세션이다.
왜 지금 엣지 AI인가 — 클라우드만으로는 부족한 이유
AI를 클라우드에서만 돌리는 시대는 조용히 저물고 있다. Chintan Parikh는 엣지 배포의 핵심 동인으로 지연 시간(Latency), 프라이버시(Privacy), 오프라인 사용, 그리고 비용 효율을 꼽았다. 이 네 가지는 독립된 장점이 아니라 서로 맞물린 구조적 이유다.
먼저 지연 시간의 문제다. 카메라 필터, 배경 교체, 화상 통화 실시간 처리와 같이 밀리초 단위의 응답이 요구되는 유스케이스에서는 클라우드 왕복 비용이 치명적이다. 강연자는 “이런 실시간 카메라 유스케이스에서는 낮은 지연 시간이 전부(latency is king)“라고 강조하며, 온디바이스가 이 문제의 구조적 해법임을 명확히 했다. 프라이버시 측면에서도 민감한 문서 요약이나 개인 건강 데이터를 다루는 경우 데이터가 기기 밖으로 나가지 않는다는 보장은 규제 대응과 사용자 신뢰 모두에서 큰 강점이 된다.
비용 논의는 특히 흥미롭다. 강연자는 이번 AI Engineer 컨퍼런스에서 토큰 비용 문제를 하소연하는 발표를 수도 없이 들었다고 언급했다. 온디바이스는 이 문제에 대한 “하이브리드 접근”을 제공한다. 모든 연산을 엣지에서 처리할 필요는 없지만, 단순하거나 반복적인 추론을 온디바이스로 오프로드함으로써 클라우드 API 호출 빈도와 비용을 유의미하게 낮출 수 있다는 논리다. 이는 단순한 기술 선택이 아니라 아키텍처 설계의 문제이기도 하다.
Gemma 4 Edge 모델 — 2B와 4B의 포지셔닝
Google DeepMind가 최근 공개한 Gemma 4는 전체 모델 패밀리 중에서도 엣지 배포에 특화된 두 가지 모델, 즉 E2B(20억 파라미터급)와 E4B(40억 파라미터급)를 중심으로 이번 강연이 구성되었다. 참고로 Gemma 3 패밀리에는 2억 7천만(270M) 파라미터까지 내려가는 초소형 모델도 존재하는데, 이는 파인튜닝이 목적일 때 선택지가 된다.
E2B 모델은 양자화(Quantization) 이후 약 1~2GB의 RAM을 사용하는 수준으로, 음성 인터페이스, 요약, 저지연 로컬 처리에 적합하다. 반면 E4B는 더 높은 RAM 요구량을 갖는 만큼 노트북이나 IoT 디바이스처럼 상대적으로 성능이 확보된 플랫폼에서 더욱 진가를 발휘한다. 두 모델 모두 Apache 2.0 라이선스로 공개되어 있어 Hugging Face에서 즉시 다운로드 후 상업적으로도 활용 가능하다.
Gemma 4의 세대적 도약이 단순한 모델 크기 조정에 그치지 않는다는 점도 중요하다. 강연자에 따르면 Gemma 4의 설계 방향은 기존 챗봇 수준의 대화 기능에서, 추론(Reasoning) 능력을 갖춘 자율 에이전트(Autonomous Agent)로의 전환을 목표로 한다. 이 방향성은 아래에서 설명할 새로운 기능들과 직결된다.
01:57 - Gemma 4의 챗봇에서 자율 에이전트로의 진화 방향 설명 슬라이드
Gemma 4의 새로운 에이전트 기능들
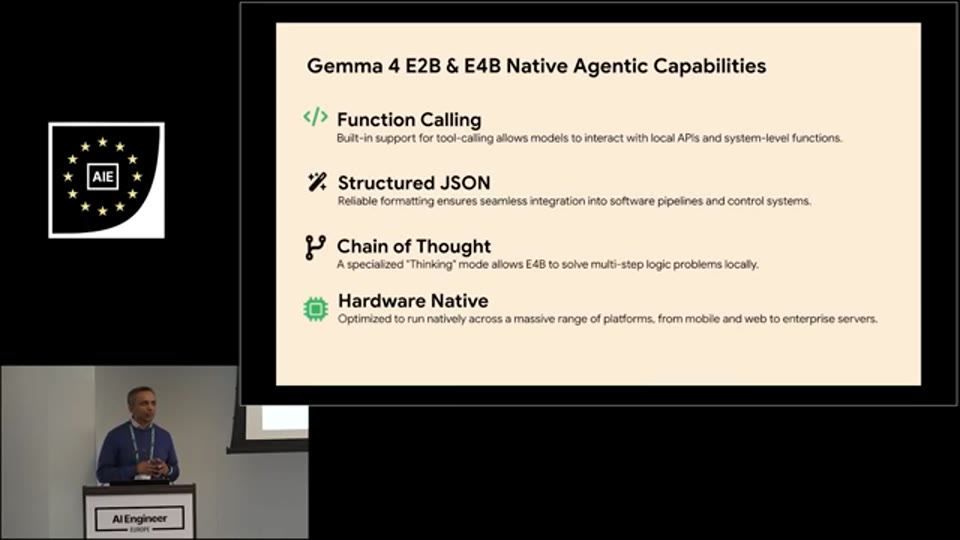
03:51 - Gemma 4 E2B·E4B 모델의 새로운 에이전트 기능(함수 호출, 구조화 JSON, 사고 모드) 설명 슬라이드
함수 호출(Function Calling)과 로컬 API 연동
Gemma 4 E2B·E4B 모델에는 툴 호출(Tool Calling)을 위한 빌트인 지원이 포함되어 있다. 이것이 의미하는 바는 단순히 모델이 텍스트를 생성하는 데서 그치지 않고, 외부 API나 로컬 서비스를 직접 호출하는 오케스트레이션 역할을 맡을 수 있다는 것이다. 강연자가 제시한 설계 철학은 명확하다: 핵심 추론은 엣지에서 수행하되, 필요한 경우 외부 API를 통해 그 능력을 확장한다. 이는 순수 온디바이스와 클라우드 의존의 이분법을 넘어서, 엣지를 오케스트레이션 허브로 재정의하는 관점이다.
구조화된 JSON 출력(Structured JSON Output)
모델이 구조화된 JSON 형식으로 출력을 생성하는 기능은 프롬프트 엔지니어링으로 억지로 구현하는 것이 아니라, 모델 아키텍처 수준에서 네이티브로 지원된다. 이는 파싱 로직의 불안정성과 예외 처리 부담을 줄여주며, 에이전트가 다른 시스템과 신뢰성 있게 인터페이스할 수 있는 기반이 된다. 구조화 출력은 멀티에이전트 파이프라인이나 앱 내 자동화 워크플로우를 구성할 때 특히 중요하다.
사고 모드(Chain of Thought / Thinking Mode)
Gemma 4에서 새롭게 도입된 Thinking Mode는 모델이 응답을 생성하기 전에 내부적으로 추론 과정을 거치는 것을 가시화하는 기능이다. 강연자는 갤러리 앱(Gallery App)에서 이 기능을 데모로 보여줄 예정임을 언급했으며, 개발자가 모델의 사고 흐름을 추적하고 디버깅하는 데 유용하다. 이는 단순 응답 품질의 향상을 넘어, 에이전트의 행동을 설명 가능하게(Explainable) 만드는 인프라 역할을 한다.
Gallery 앱 — 엣지 AI 가능성의 플레이그라운드
Google이 제공하는 갤러리 앱은 위에서 설명한 기능들을 직접 체험할 수 있는 오픈소스 샘플 애플리케이션이다. 단순한 데모 도구가 아니라, 실제 앱 개발의 시작점으로 설계된 것이 특징이다. 앱 내에서는 Ask Image(이미지 질의), Audio Scribe(음성 전사), 에이전트 스킬 등이 지원되며, 모든 처리는 온디바이스에서 이루어진다.
특히 주목할 부분은 스킬(Skill) 시스템이다. 강연 데모에서는 Wikipedia를 쿼리하는 스킬, 수면 시간을 추적하고 트렌드를 시각화하는 무드 트래킹 에이전트, 사진을 인식하고 음악을 생성하는 멀티모달 스킬 등이 시연되었다.
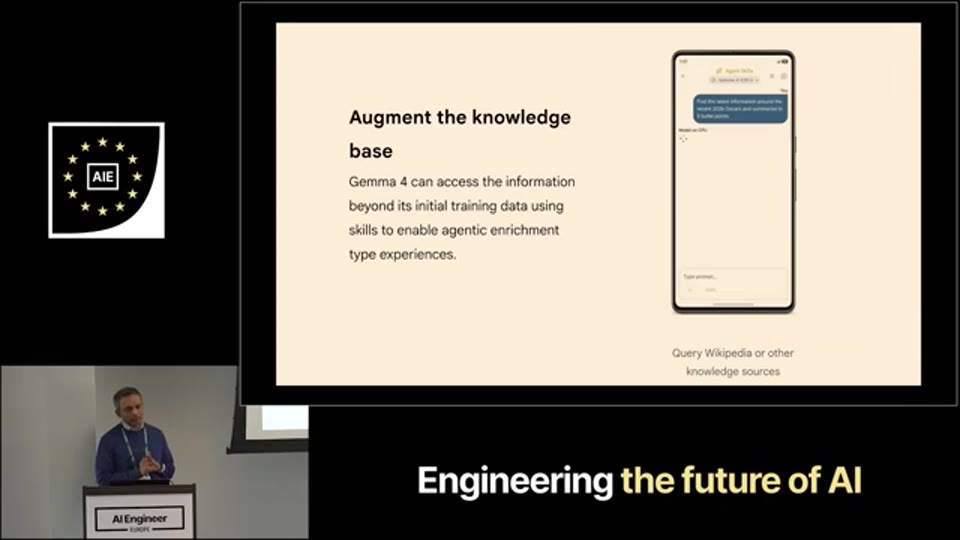
07:09 - 갤러리 앱 위키피디아 쿼리 스킬 데모 화면
이 스킬들은 앱 안에서 직접 작성하고 로드할 수 있으며, 외부 개발 환경을 별도로 구성할 필요가 없다. 더 나아가 커뮤니티가 만든 스킬들이 GitHub 저장소에 공유되고 있어, 개발자 생태계가 형성되고 있다는 점도 인상적이다.
강연자가 직접 언급한 아키텍처 유연성도 눈에 띈다. 사용자는 추론 시 CPU, GPU, 혹은 NPU(Neural Processing Unit) 중 어떤 가속기를 사용할지 선택할 수 있으며, NPU 지원 확대가 가까운 계획으로 언급되었다.
LightRT 프레임워크 — 신뢰할 수 있는 온디바이스 인프라
프레임워크의 뿌리와 규모
갤러리 앱을 포함한 모든 온디바이스 경험의 기반이 되는 것은 Google의 LightRT 프레임워크다. LightRT는 TensorFlow Lite를 토대로 구축되었으며, 10만 개 이상의 앱에 채택되어 있고 수십억 명의 활성 사용자를 보유하고 있다. 일일 추론 호출 횟수도 막대한 수준이라고 강연자는 강조했다. 이는 단순한 마케팅 수치가 아니라, 해당 프레임워크가 이미 프로덕션 환경에서 충분히 검증된 신뢰 기반임을 의미한다.
이름이 TensorFlow Lite에서 LightRT로 변경된 배경도 중요하다. 리브랜딩의 주된 동기는 TensorFlow 모델뿐 아니라 PyTorch와 JAX 모델도 수용한다는 멀티프레임워크 지원을 명확히 하기 위해서였다. 즉, PyTorch로 학습한 모델을 TFLite 파일 포맷으로 변환하면 동일한 배포 파이프라인을 타게 된다. 모델 포터빌리티와 프레임워크 독립성이라는 두 가지 목표를 동시에 추구하는 설계다.
배포 스택 구조
강연자가 제시한 배포 흐름은 다음과 같이 단계적으로 구성된다.
모델 변환 단계에서는 LightRT Torch가 기존 PyTorch 또는 JAX 모델을 TFLite 파일 포맷으로 변환하는 역할을 담당한다. 변환 이후에는 필요에 따라 양자화(Quantization)를 적용할 수 있으며, 대형 언어 모델(LLM)의 경우 LightRT LM 경로를 통해 처리된다. 그 외 모델들은 일반 LightRT 경로로 배포된다.
그래프 분석 도구인 Model Explorer는 변환된 모델의 그래프 구조를 시각적으로 탐색하고, 어느 레이어에 어떤 수준의 양자화(혼합 정밀도 포함)를 적용할지 결정하는 데 활용된다. 이는 단순한 전체 양자화에서 나아가 정확도와 성능 간의 균형을 세밀하게 제어할 수 있는 도구다.
벤치마킹 측면에서는 AI Edge Portal이 클라우드 기반 서비스로 제공된다. 이 도구는 특정 모델이 다양한 Android 기기에서 실제로 잘 동작할 것인지 사전에 검증하는 목적으로 설계되었다. 사전 컴파일(Ahead-of-Time Compilation)과 즉시 컴파일(Just-in-Time Compilation) 중 어떤 전략이 해당 모델과 기기 조합에 더 적합한지 파악하는 데도 유용하다.
11:06 - LightRT 프레임워크 전체 배포 스택 아키텍처 다이어그램
가속기 지원 — CPU, GPU, NPU
CPU와 GPU 가속은 현재 범용적으로 지원되며, 이미 다양한 플랫폼에서 안정적으로 작동하고 있다. NPU 가속은 현재 Qualcomm과 MediaTek과의 통합이 완료되었으며, 추가 파트너와의 통합 작업이 진행 중이라고 강연자가 밝혔다.
NPU 가속의 효과는 단순한 성능 수치를 넘어선다. 강연자는 ASR(Automatic Speech Recognition), TTS(Text-to-Speech), AR/VR 실시간 카메라 피드 처리 등 실시간 응답이 필수적인 애플리케이션에서 NPU 사용 시 3~10배의 성능 향상을 기대할 수 있다고 언급했다. 성능 향상뿐만 아니라 에너지 효율 개선 효과도 크다는 점에서, NPU는 배터리로 구동되는 모바일·IoT 디바이스에서 특히 큰 의미를 갖는다.
크로스 플랫폼 지원과 실제 성능 수치
지원 플랫폼의 범위
LightRT와 Gemma 4 엣지 모델의 가장 강력한 강점 중 하나는 단일 모델 파일 포맷으로 광범위한 플랫폼을 커버한다는 점이다. 강연자가 직접 테스트 완료를 확인한 플랫폼은 Android, iOS, Linux, macOS, Windows, 웹, 그리고 Raspberry Pi를 포함한 IoT 디바이스까지 포함된다. 동일한 TFLite 파일로 이 모든 플랫폼에서 추론을 실행할 수 있다는 것은 멀티플랫폼 제품을 개발하는 팀에게 유지보수 비용을 크게 낮춰준다.
성능 수치 (Hugging Face 공개 데이터 기준)
💡 [영상 참조] 강연자는 이 시점에서 플랫폼별 성능 벤치마크 표를 화면에 표시하며 설명합니다. 상세 수치는 원본 영상 및 Google의 Hugging Face 페이지를 확인하세요.
음성으로 언급된 수치를 정리하면 아래와 같다.
| 플랫폼 / 비교 대상 | 측정값 |
|---|---|
| NPU 가속 시 최대 성능 향상 | 최대 13x |
| iOS 추론 속도 (예시 수치) | 약 56 토큰/초 |
| 모바일에서 Llama 대비 LightRT 성능 | 최대 35x 빠름 |
| 데스크톱에서 Llama 대비 | 동등 수준(at par) |
| IoT에서 Llama 대비 | 약 3x |
강연자는 이 수치들이 Hugging Face 모델 페이지에 플랫폼별로 공개되어 있다고 밝혔으며, 모델 다운로드 시 함께 확인할 수 있다.
16:30 - 플랫폼별 성능 벤치마크 수치 표 (NPU 가속, iOS, 데스크톱, IoT)
Raspberry Pi 로봇 데모
강연 당일 아침에 직접 제작한 로봇 데모도 소개되었다. Raspberry Pi 위에서 LightRT LM을 CPU로 구동해 카메라로 입력된 “안테나를 움직여라”는 신호를 인식하고 실제 물리적 동작을 수행하는 것을 시연했다. 강연자 본인도 “아침에 막 만든 것이라 성능은 아직 부족하다”고 웃으며 인정했지만, 이 데모는 Gemma 모델이 저전력 IoT 디바이스에서 실제로 실행 가능하다는 사실을 구체적으로 보여주는 사례다.
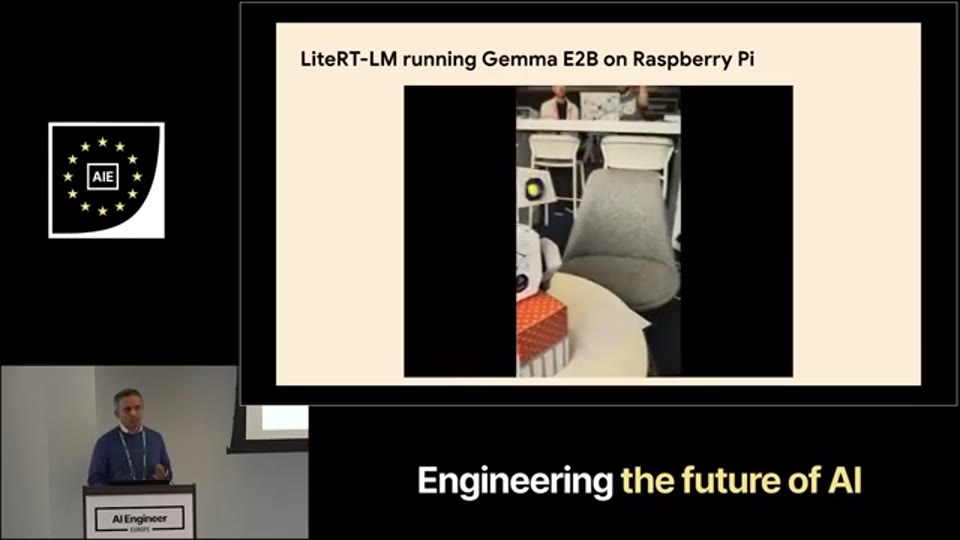
17:12 - Raspberry Pi 로봇 온디바이스 추론 데모 영상
개발자 진입점 — 어떻게 시작할 것인가
진입 경로는 크게 세 가지로 정리된다. 첫째, Hugging Face에서 Apache 2.0 라이선스로 공개된 Gemma 4 E2B·E4B 모델을 즉시 다운로드하여 사용할 수 있다. Gemma 3 계열의 초소형 모델들도 같은 페이지에서 찾을 수 있다. 둘째, Gallery 앱을 그대로 포크(Fork)하거나 커뮤니티 스킬을 활용해 빠르게 프로토타입을 구성할 수 있다. 셋째, CLI 도구와 Python 바인딩을 통해 커맨드라인 환경에서 직접 변환·배포 파이프라인을 구성할 수 있으며, 관련 문서는 Google의 공식 웹사이트에 공개되어 있다고 강연자가 안내했다.
Q&A 하이라이트
강연 후 Q&A에서는 몇 가지 실용적인 주제가 오갔다. 얼굴 인식을 로컬 카메라에서 상시 구동하는 방법을 묻는 질문에 강연자는, 스마트폰의 얼굴 잠금 해제가 이미 동일한 프레임워크로 온디바이스 실행되고 있다는 점을 설명했다. 홈 카메라처럼 연속 스트리밍이 필요한 경우에는 별도의 진위 확인 알고리즘 설계가 필요하며, Raspberry Pi 같은 로컬 디바이스로도 충분히 구현 가능하다고 답했다.
또한 여러 작은 모델이 각자 트리거를 감지하고 상위 영역의 더 큰 모델에 연결하는 멀티에이전트 아키텍처에 대한 질문이 나왔다. 강연자는 실제로 그런 형태의 분산 에이전트 구조를 연구하는 팀이 존재한다고 확인하면서도, 공유 가능한 구체적인 사례는 현재 없다고 솔직하게 밝혔다. 오케스트레이션 레이어에서 무엇을 로컬에서 처리하고 무엇을 원격으로 처리할지 결정하는 구조가 핵심이라는 점도 덧붙였다.
마무리 / 핵심 정리
이번 강연의 메시지는 명확하다. 온디바이스 AI는 더 이상 모바일 앱의 보조 기능이 아니라, 에이전트 추론, 함수 호출, 구조화 출력, 멀티모달 처리를 아우르는 완전한 AI 실행 환경으로 진화하고 있다. Gemma 4 E2B·E4B 모델과 LightRT 프레임워크의 조합은 이 방향성을 구체적인 기술 스택으로 구현한 결과물이다.
개발자 관점에서 가장 중요한 시사점은 세 가지다. 하나는 단일 TFLite 파일로 Android부터 Raspberry Pi까지 커버하는 포터빌리티다. 두 번째는 PyTorch, JAX 등 기존 프레임워크 자산을 그대로 활용할 수 있는 멀티프레임워크 지원이다. 세 번째는 NPU 가속을 통해 3~13배의 성능 향상과 에너지 효율 개선을 동시에 달성할 수 있다는 점이다. 클라우드 토큰 비용에 고민하는 팀이라면, 온디바이스 하이브리드 아키텍처를 진지하게 검토할 시점이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Accelerating AI on Edge — Chintan Parikh and Weiyi Wang, Google DeepMind |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-05-06 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.