Agentic Search for Context Engineering
📺 원본 영상: Agentic Search for Context Engineering — Leonie Monigatti, Elastic 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-09 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(코드 슬라이드, 다이어그램, 실행 결과 화면 등)는 일부 포함되지 않을 수 있습니다.
개요
이 강연은 Elasticsearch를 만든 회사 Elastic의 엔지니어 Leonie Monigatti가 에이전틱 검색(Agentic Search)과 컨텍스트 엔지니어링(Context Engineering)의 관계를 탐구하는 실용적인 워크숍이다. 단순한 고정 파이프라인 RAG(Retrieval-Augmented Generation)에서 출발해, 에이전트가 스스로 검색 도구를 선택·호출하는 에이전틱 RAG로의 진화를 역사적 맥락과 함께 설명하고, 의미 검색 도구, 범용 쿼리 실행 도구, 셸 도구, JinaGrep에 이르기까지 다양한 검색 전략을 직접 코드로 시연한다. 강연의 최종 목적은 “어떤 검색 도구가 내 에이전트에 맞는가”라는 실무 질문에 답하는 것이다.
컨텍스트 엔지니어링의 80%는 검색이다
컨텍스트 엔지니어링이란, 수많은 컨텍스트 소스 중에서 무엇을 LLM의 컨텍스트 윈도우에 넣을지를 결정하는 기술이자 공학적 기법의 총체다. 이 개념을 다이어그램으로 표현하면 “컨텍스트 소스 → 컨텍스트 윈도우”를 잇는 작은 화살표 하나가 등장하는데, 강연자 Leonie는 바로 이 화살표가 충분한 주목을 받지 못하고 있다고 지적한다. 그 화살표를 실제로 구동하는 것이 바로 검색 도구(Search Tool)이기 때문이다.
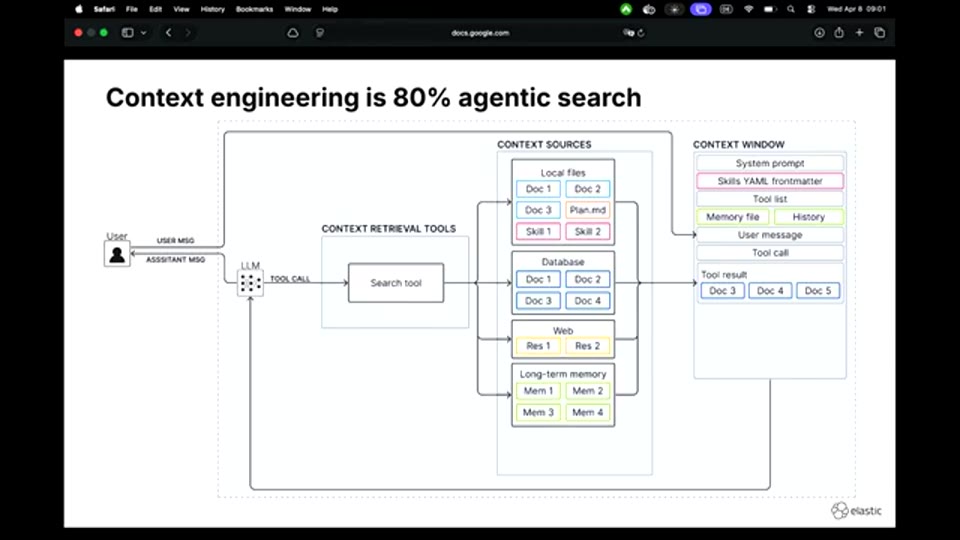
02:00 - 컨텍스트 소스에서 컨텍스트 윈도우로 이어지는 화살표와 검색 도구의 역할을 설명하는 다이어그램
강연자의 핵심 주장은 명확하다. “컨텍스트 엔지니어링은 약 80%가 에이전틱 검색이다.” 우리가 컨텍스트 큐레이션을 논할 때 시스템 전반의 구조나 프롬프트 설계에 집중하는 경향이 있지만, 실제로 무엇을 가져올지를 결정하는 건 결국 검색 메커니즘이라는 것이다. 이 관점에서 보면 검색 도구의 설계는 에이전트 품질을 결정짓는 핵심 변수가 된다.
RAG의 진화 - 고정 파이프라인에서 에이전틱 RAG로
강연자는 “역사라고 해봤자 최근 3년”이라고 운을 띄우며 RAG의 발전 과정을 간결하게 정리한다. 초기 RAG의 아이디어는 고정된 검색 파이프라인(Fixed Retrieval Pipeline)이었다. 사용자의 메시지가 거의 그대로 검색 쿼리로 활용되어, 보통 벡터 검색을 통해 데이터베이스에서 청크를 불러오고, 검색된 컨텍스트와 함께 LLM에 전달되는 구조였다.
이 구조에는 분명한 한계가 있었다. 첫째, 파이프라인이 고정되어 있기 때문에 컨텍스트가 실제로 필요하지 않더라도 무조건 검색이 수행된다. 이때 불필요하게 가져온 정보는 오히려 LLM을 혼란스럽게 만들 수 있다. 둘째, 단 한 번의 검색으로는 멀티-홉(multi-hop) 질문에 대응하기 어렵다. 복잡한 질문에 답하려면 첫 번째 검색 결과에서 새로운 검색 키워드를 발견하고 두 번째 검색을 수행해야 하는 경우가 많기 때문이다.
이러한 문제를 해결하기 위해 등장한 것이 에이전틱 RAG(Agentic RAG)다. 고정 파이프라인 대신 검색 도구(Search Tool)를 에이전트에게 제공하고, 에이전트 스스로 검색 도구를 호출할지 여부를 판단하게 한다. 이로써 “지금 컨텍스트가 정말 필요한가?”, “검색 결과가 충분히 관련성이 있는가?”, “쿼리를 재작성해야 하는가?” 같은 결정을 에이전트가 자율적으로 내릴 수 있게 된다.
컨텍스트 소스와 검색 도구의 다양성
에이전틱 RAG로 넘어오면 컨텍스트가 훨씬 다양한 곳에 분산되어 있다는 현실과 마주하게 된다. 강연자는 주요 컨텍스트 소스를 다섯 가지로 분류한다. 로컬 파일 시스템에는 코딩 에이전트의 프로젝트 파일이나 plan.md 같은 작업 메모가 저장되어 있고, 에이전트 스킬 역시 로컬 폴더에 위치한다. 데이터베이스는 기업이 보유한 구조화 데이터의 전통적인 저장소이며, 웹은 실시간 정보를 제공한다. 마지막으로 **장기 메모리(Long-term Memory)**는 현재 활발히 논의 중인 영역으로, 로컬 파일 시스템에 둘지 데이터베이스에 둘지 아직 정해진 정답이 없는 상태다.
각 컨텍스트 소스마다 고유한 검색 도구가 대응된다. 로컬 파일에는 파일 검색 도구, 스킬에는 스킬 로딩 도구, 데이터베이스에는 의미 검색 도구나 SQL 같은 쿼리 실행 도구, 웹에는 웹 검색 도구가 각각 쓰인다. 여기에 더해 **셸 도구(Shell Tool)**가 등장하면서 상황이 한층 복잡해진다. LangChain에서는 Shell Tool, Anthropic(Claude)에서는 Bash Tool, 그리고 Claude Code에서는 exec tool이라고 부르는 이 도구는 에이전트가 터미널 명령을 직접 실행할 수 있게 해준다. ls로 디렉터리를 탐색하고, grep으로 파일을 검색하며, cURL로 HTTP 요청을 보낼 수 있어 단일 도구임에도 매우 범용적이다.
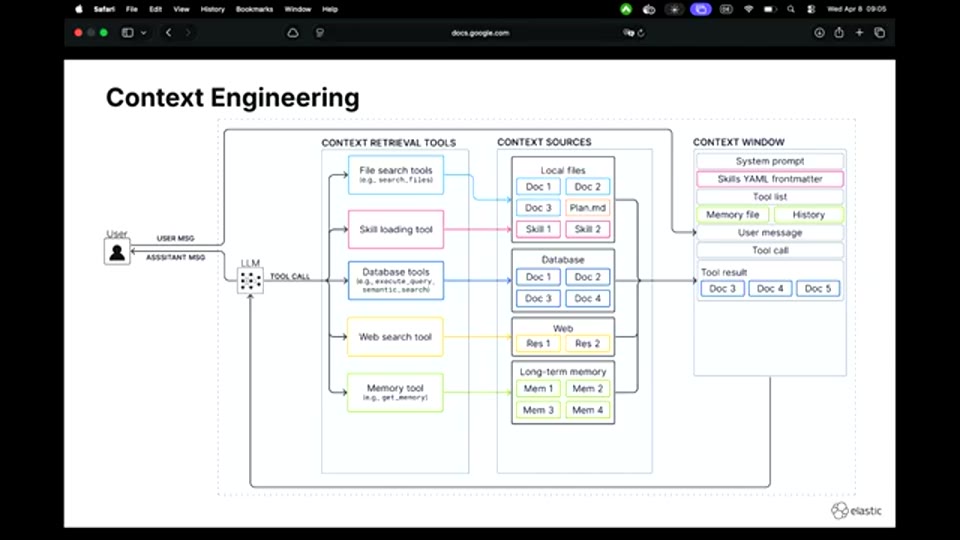
05:45 - 로컬 파일, 데이터베이스, 웹, 장기 메모리 등 다양한 컨텍스트 소스와 각 소스에 대응하는 검색 도구 목록을 보여주는 슬라이드
좋은 검색 도구를 만들기 위한 세 가지 핵심 원칙
강연자는 에이전틱 검색이 표면적으로는 단순해 보인다고 말한다. “사용자 요청 → 에이전트가 올바른 도구를 올바른 파라미터로 호출 → 검색 결과 반환 → 정확한 답변.” 그러나 Elastic이 내외부 팀들과 함께 에이전트를 구축하는 경험을 쌓으면서, 이 흐름이 다양한 방식으로 깨질 수 있다는 것을 발견했다. 강연자가 오늘 소개하는 주요 실패 모드는 세 가지다.
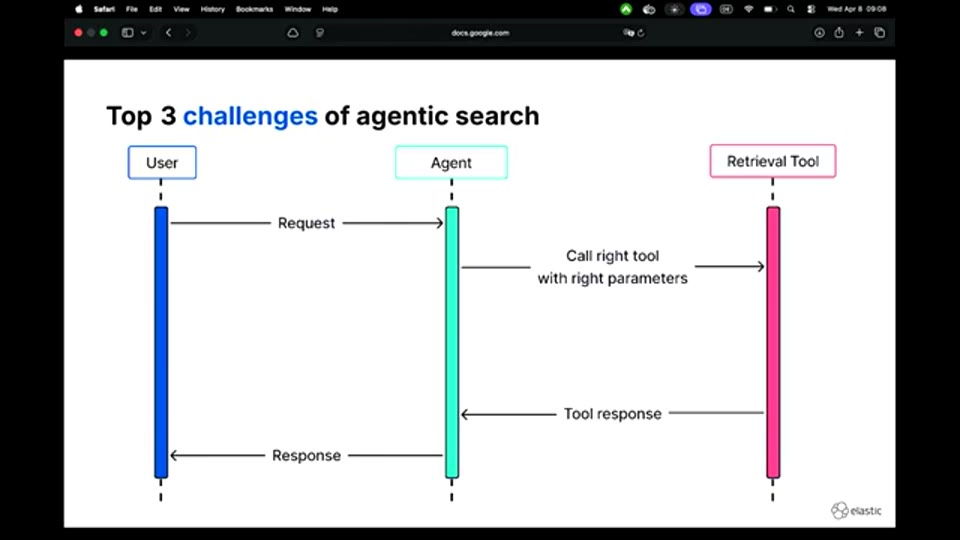
09:02 - 에이전틱 검색의 이상적인 흐름(사용자 요청 → 도구 호출 → 결과 반환 → 응답)과 주요 실패 모드 3가지를 설명하는 슬라이드
첫 번째는 에이전트가 아무 도구도 호출하지 않는 경우다. 에이전트가 자신의 파라메트릭 지식만으로도 답할 수 있다고 판단해 검색 도구를 사용하지 않는 상황이다. 두 번째는 에이전트가 잘못된 도구를 호출하는 경우다. 강연자의 동료가 경험한 사례처럼, 데이터베이스 검색 도구 대신 웹 검색 도구를 호출하도록 에이전트를 막는 것 자체가 프로젝트에서 가장 어려운 과제였다는 이야기도 나온다. 세 번째는 에이전트가 잘못된 검색 파라미터를 생성하는 경우로, 도구는 올바르게 선택했지만 쿼리 파라미터가 부적절한 케이스다.
이 세 가지 실패 모드에 대응하는 핵심 처방은 도구 설명(Tool Description)의 품질이다. 강연자는 자신이 싫어하는 슬라이드라고 소개하면서도, 현장에서 대부분의 개발자가 도구 설명에 한 문장 정도의 최소한의 노력만 기울이는 현실을 꼬집는다. 좋은 도구 설명은 핵심 목적(Core Purpose)에서 시작하되, 에이전트가 도구 선택에 어려움을 겪기 시작하면 트리거 조건(When to use / When NOT to use)을 추가하고, 여러 도구를 운용할 때는 도구 간 관계(Relationships)—예를 들어 “이 도구를 호출하기 전에 먼저 스킬 A를 로드하라”—를 명시해야 한다. 그리고 도구 설명이 완벽해도 에이전트가 여전히 잘못된 도구를 선택한다면, 에이전트 시스템 프롬프트에서 동일한 내용을 재강조하는 것이 대부분의 경우에 효과적이라고 덧붙인다.
파라미터 복잡도(Parameter Complexity)도 중요한 변수다. ID로 고객을 조회하거나 단순한 문자열 쿼리를 전달하는 수준은 에이전트에게 어렵지 않다. 그러나 필터 조건, top-K 설정 등 파라미터 목록이 늘어날수록, 또 ES|QL(Elasticsearch Query Language)이나 SQL처럼 에이전트가 전체 쿼리를 처음부터 작성해야 하는 상황에서는 오류 가능성이 크게 높아진다.
코드 데모 1 - 의미 검색 도구와 그 한계
강연자는 이번 AI Engineer 컨퍼런스의 세션 데이터를 활용해 실습 데모를 진행한다. 에이전트 프레임워크로는 LangChain을 사용하며, 그 이유는 셸 도구가 내장되어 있고 에이전트 스킬 샘플 코드도 기본 제공되어 고수준 개념에 집중할 수 있기 때문이라고 설명한다.
💡 [영상 참조] 이 구간부터 강연자는 Jupyter Notebook 형태의 실제 코드를 화면에 표시하며 단계별로 설명합니다. 상세 코드는 원본 영상과 강연 시작 시 안내된 QR 코드의 GitHub 저장소를 참조하세요.
기본 에이전트 구성은 다음과 같다. LLM으로는 OpenAI의 경량 모델(GPT-4.1 nano)을 사용하고, 시스템 프롬프트에는 “당신은 검색 에이전트입니다. 답변 전에 추가 컨텍스트가 필요한지 판단하세요”라는 내용과 함께 Elasticsearch 인덱스의 필드 구조—텍스트 필드(타이틀 + 설명이 임베딩됨)와 메타데이터 필드(날짜, 시간, 강연실, 발표자 이름)—를 설명한다.
의미 검색 도구는 Jina Embeddings v5 모델을 임베딩 모델로 사용해 쿼리를 벡터로 변환한 뒤, Elasticsearch 벡터 스토어에서 유사도 검색을 수행하는 방식으로 구현된다. LangChain의 @tool 데코레이터를 활용하면 파이썬 함수를 그대로 에이전트 도구로 전환할 수 있으며, 함수 이름은 도구 이름으로, 독스트링(Docstring)은 도구 설명으로 자동 변환된다.
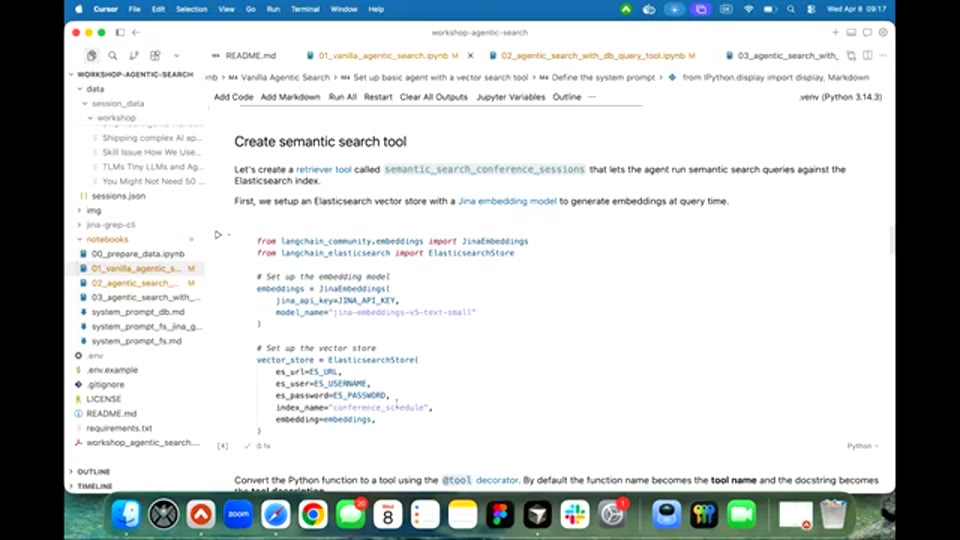
17:43 - LangChain @tool 데코레이터를 사용한 의미 검색 도구 구현 코드와 Jina Embeddings v5 설정
이 도구로 “AI 시스템에서 규제 제약을 다루는 세션”을 검색하면 에이전트는 적절한 결과를 반환한다. 그러나 도구의 한계는 금세 드러난다. 강연자가 **JEPA(Joint Embedding Predictive Architecture)**에 관한 세션을 찾아달라고 요청하자, 에이전트는 의미 검색으로 “JEPA”와 토크나이저 관점에서 유사하다고 판단한 DeepMind의 GEMMA 모델 강연과 Harness Engineering 강연 등 전혀 무관한 결과를 반환한다. 이는 의미 검색이 정확한 키워드 매칭이나 필터링에 취약하다는 사실을 단적으로 보여준다. top-K를 3으로 고정했다는 구현상의 제약도 상황을 악화시킨다.
코드 데모 2 - 범용 쿼리 실행 도구와 에이전트 스킬
의미 검색 도구의 한계를 넘어서기 위해 강연자는 에이전트가 전체 검색 쿼리를 직접 작성하도록 하는 범용 쿼리 실행 도구를 도입한다. Elasticsearch의 파이프 기반 쿼리 언어인 **ES|QL(Elasticsearch Query Language)**을 사용하며, SQL과 유사하지만 다른 문법 체계를 가진다. 이 도구의 난이도가 높은 만큼 LLM도 더 강력한 모델(GPT-4.1 mini)로 교체한다.
주목할 만한 구현 세부 사항이 있다. 강연자는 이 도구에 반드시 try-except 블록을 추가해 오류 응답을 에이전트에게 반환하도록 설계했다. 이렇게 하면 에이전트가 잘못된 쿼리를 생성했을 때 시스템 전체가 크래시하는 대신, 에러 메시지를 피드백으로 받아 쿼리를 수정하고 재시도할 수 있다. 자기 교정(Self-correction) 루프를 설계에 내재화한 셈이다.
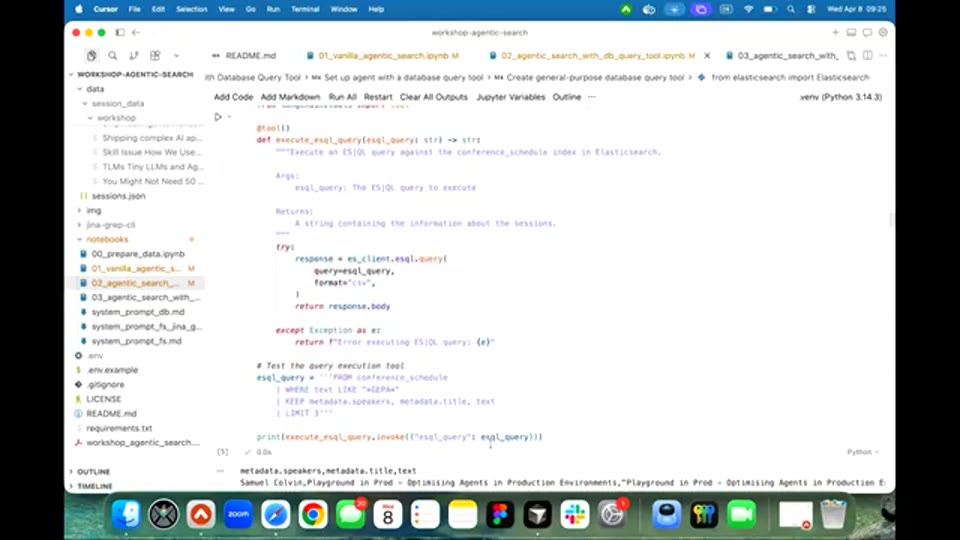
25:28 - ES|QL 쿼리 실행 도구 코드와 try-except 오류 처리 블록, 에이전트에게 오류 응답을 반환하는 구조
그러나 예상대로 에이전트는 ES|QL의 문법을 완벽히 알지 못해 첫 시도에서 SQL의 와일드카드 문자인 % 기호를 ES|QL에서도 사용한다. ES|QL에서 와일드카드는 %가 아닌 *이므로 검색 결과가 0건으로 반환된다. 이 문제를 해결하기 위해 강연자는 **에이전트 스킬(Agent Skill)**을 도입한다.
에이전트 스킬은 “점진적 공개(Progressive Disclosure)“라는 개념에 기반한다. 전체 스킬 문서를 항상 시스템 프롬프트에 포함하는 대신, 스킬의 이름과 간략한 설명만 시스템 프롬프트에 두고, 에이전트가 필요하다고 판단할 때 스킬의 전체 내용을 컨텍스트 윈도우에 로드하는 방식이다. 강연자가 작성한 커스텀 ES|QL 스킬에는 기본 쿼리 구조, 문자열 리터럴에 쌍따옴표를 사용해야 한다는 문법 규칙, 그리고 와일드카드로 *를 사용해야 한다는 내용이 담겨 있다.
스킬을 도입하면서 도구 설명에도 관계(Relationship)를 명시했다. “이 도구를 사용하기 전에 반드시 Elasticsearch SQL 스킬을 먼저 로드하라”는 지시를 도구 설명과 시스템 프롬프트 양쪽에 추가한 것이다. 결과적으로 에이전트는 먼저 스킬을 로드하고, 올바른 * 와일드카드를 사용한 ES|QL 쿼리를 생성해 JEPA 세션을 정확히 찾아낸다.
이 범용 쿼리 도구의 또 다른 장점은 **집계(Aggregation)**가 가능하다는 것이다. “4월 8일에 세션이 몇 개 있나요?”라는 질문에 에이전트는 날짜 필터와 COUNT 집계를 결합한 쿼리를 작성해 27개라는 답을 반환한다. 만약 의미 검색 도구만 있었다면 27개 세션 목록을 모두 가져온 뒤 LLM이 직접 세어야 했을 것이다. LLM이 숫자 세기에 악명 높이 약하다는 점, 그리고 27개 세션 정보가 컨텍스트 윈도우를 가득 채운다는 점을 감안하면, 계산을 검색 도구에 위임하는 것이 훨씬 효율적이다.
코드 데모 3 - 셸 도구와 로컬 파일 시스템 탐색
강연자는 화제를 전환해 “에이전트에게는 셸 도구와 파일 시스템만 있으면 된다”는 논쟁적인 주장을 직접 시험해 본다. 이번에는 동일한 컨퍼런스 세션 데이터를 Elasticsearch 대신 로컬 파일 시스템에 저장한다. session_data 폴더 아래 세션 유형별(keynotes, workshops 등) 하위 폴더가 있고, 각 세션은 타이틀, 메타데이터, 설명이 담긴 별도 파일로 저장된다.
셸 도구는 LangChain에 내장되어 있어 import 후 즉시 사용할 수 있다. 다만 강연자는 중요한 경고를 전달한다. 셸 도구는 에이전트에게 터미널 전체 접근 권한을 부여하기 때문에 파일 삭제나 의도치 않은 명령 실행이 발생할 수 있다. LangChain의 셸 도구에는 기본 안전장치가 없으므로 반드시 샌드박스 환경에서만 사용해야 한다고 강조한다.
셸 도구를 사용한 에이전트에게 동일하게 JEPA 관련 세션을 질의하면, 에이전트는 먼저 ls로 폴더 구조를 파악하고, 이어서 grep 명령으로 session_data 디렉터리 전체를 검색해 관련 파일을 찾아낸다. 해당 파일 내용을 읽은 뒤 정확한 답변을 반환한다.
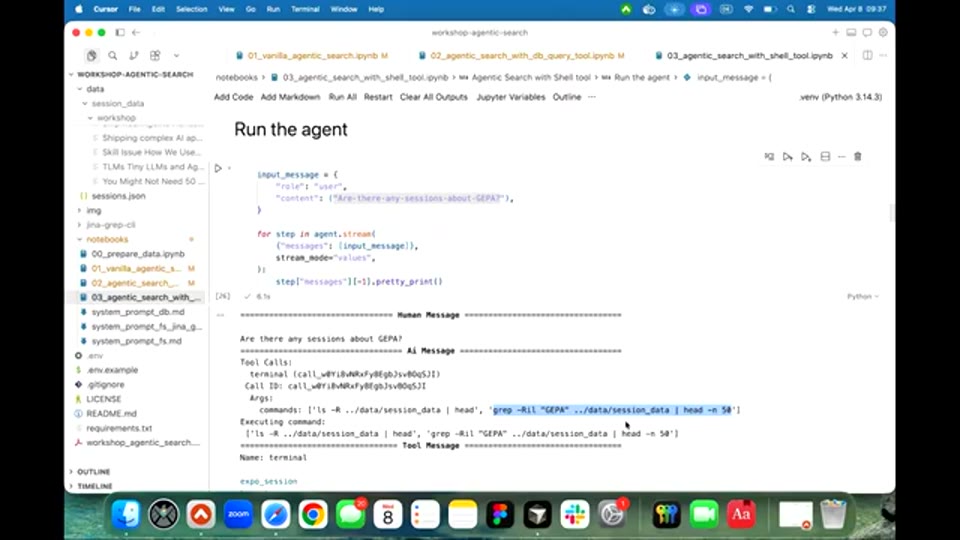
38:04 - 셸 도구를 사용한 에이전트가 grep으로 JEPA 관련 세션을 검색하는 터미널 실행 결과
특히 흥미로운 장면은 “규제 제약을 다루는 세션”처럼 키워드가 명확하지 않은 의미적 질문을 처리하는 부분이다. 에이전트는 regulat(regulation, regulatory 등을 포괄)를 시작으로, compliance, constraints, GDPR, governance 같은 동의어들을 줄줄이 grep으로 검색해 나간다. 강연자는 이 모습을 두고 “에이전트가 의미 검색을 동의어 열거로 흉내 낸다”고 표현한다. 결과적으로는 올바른 세션을 찾아내지만, 강연자는 단호하게 덧붙인다. “동물 슈퍼히어로가 등장하는 영화를 찾고 싶을 때, 에이전트가 모든 동물 이름을 하나씩 grep으로 검색하길 원하는 사람은 없다. 작동하는 방식이냐, 최선의 방식이냐는 별개의 문제다.”
코드 데모 4 - JinaGrep으로 파일 시스템의 의미 검색 확장
현재 grep의 대안으로 파일 시스템에서 의미 검색을 수행하는 CLI 도구들이 등장하고 있다. 강연자가 소개하는 주요 도구들은 다음과 같다.
| 도구 | 제공사 | 특징 |
|---|---|---|
| sem grep (SemGrep) | LlamaIndex | 의미 기반 파일 검색 CLI |
| ColGrep | LightOn | 멀티벡터 임베딩 기반 검색 |
| JinaGrep | Jina AI | 다양한 모드 지원 (분류, 리랭킹, 의미 검색) |
강연자는 이 중 JinaGrep을 데모에 활용한다. 설치 방법은 CLI를 통해 JinaGrep을 설치하는 것이며, 에이전트에게는 시스템 프롬프트를 통해 JinaGrep의 존재와 사용법을 알려준다. 핵심은 도구 선택 기준도 프롬프트에 명시한다는 점이다. “정확한 키워드 매칭에는 grep을, 의미적이거나 퍼지(fuzzy) 검색에는 JinaGrep을 사용하라”는 지침이 포함된다.
동일한 의미 검색 쿼리(“규제 제약을 다루는 세션”)로 테스트하면, 에이전트는 폴더 구조를 확인한 뒤 JinaGrep을 한 번의 호출로 올바르게 사용해 단 첫 시도에서 목표 세션을 찾아낸다. 이전의 동의어 열거 방식과는 달리, 단일 의미 쿼리로 상위 10개 결과를 반환하며 관련성 높은 세션이 우선순위에 오른다.
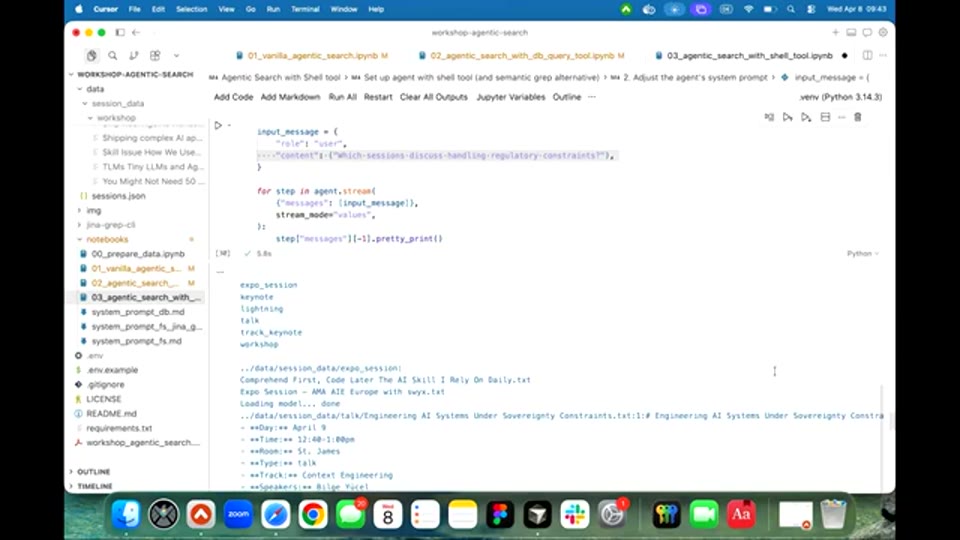
43:38 - JinaGrep CLI를 사용한 의미 검색 결과 - 단 한 번의 호출로 규제 제약 관련 세션을 정확히 찾아내는 화면
실용적 권고사항 - 낮은 진입 장벽과 높은 확장 한계의 균형
강연자는 “단 하나의 만능 검색 도구를 찾는 것은 옳지 않다”고 단언한다. 좋은 검색은 본질적으로 어렵고, 그렇기 때문에 벡터 검색, 키워드 검색, 덴스 임베딩, 스파스 임베딩, 멀티벡터 임베딩, 다양한 인덱싱 기법 등 수많은 기술이 공존한다. 에이전트를 위한 검색 도구 스택 역시 에이전트의 검색 행동과 레이턴시 요구사항에 맞게 직접 설계해야 한다.
강연자의 실용적 프레임워크는 **낮은 진입 장벽(Low Floor)과 높은 확장 한계(High Ceiling)**의 조합이다.
-
낮은 진입 장벽 도구(Low Floor): 에이전트가 별도 학습 없이 즉시 사용할 수 있는 특화 도구다. 파라미터가 단순하고, 강력한 LLM 없이도 올바르게 작동하며, 반복 호출 없이 한 번에 원하는 결과를 가져온다. 고객 ID 조회나 단순 의미 검색 도구가 대표적이다. 에이전트가 자주 수행하는 패턴화된 검색에 최적화된다.
-
높은 확장 한계 도구(High Ceiling): 예상치 못한 복잡한 쿼리에도 에이전트가 대응할 수 있게 해주는 범용 도구다. 셸 도구나 ES|QL 실행 도구가 여기에 해당한다. 단, 범용성이 높을수록 에이전트가 올바른 파라미터를 생성하는 데 더 많은 시행착오가 필요하다는 트레이드오프가 존재한다.
에이전트의 쿼리 행동을 아직 파악하지 못한 초기 단계에서는 범용 도구로 시작해 에이전트 행동을 로깅할 것을 권장한다. 만약 에이전트가 단일 질문에 4~5번의 도구 호출을 반복한다면, 그것은 해당 도구가 에이전트에게 너무 어렵다는 신호다. 반복적으로 나타나는 특정 쿼리 패턴을 발견했다면, 그 패턴을 위한 특화 도구를 별도로 구축하라는 조언도 덧붙인다. 강연자 본인도 Claude Code의 exec tool 사용 로그를 3일간 분석한 뒤, 데이터베이스 상호작용에 특화된 검색 도구를 추가로 구현했다고 공유한다.
Q&A 주요 내용
Q: 더 강력한 모델을 사용하면 셸 도구만으로도 충분한가?
강연자에 따르면, 내부 테스트 결과 강력한 모델일수록 파라미터 오류율이 크게 감소했다. 그러나 강력한 모델을 사용한다고 해서 오류가 완전히 사라지지는 않으므로, 모델에 의존해 범용 도구만 사용하는 것은 위험하다.
Q: 에이전틱 RAG의 높은 레이턴시 문제 - 단순 RAG와 병렬 운용이 가능한가?
강연자는 명확한 답을 내놓지 못했다. 단순 RAG는 여전히 많은 유스케이스에서 효과적이며, 에이전틱 RAG가 항상 더 낫다고 볼 수 없다는 점을 인정했다. 둘 사이를 전환하는 로직 자체가 또 다른 에이전틱 판단을 필요로 하기 때문에, 해결책이 단순하지 않다고 솔직히 답변했다.
Q: DB 도구와 셸 도구를 함께 써서 결과를 교차 검증하는 것이 실용적인가?
강연자는 이를 강하게 지지했다. Barc(정확한 회사명은 영상 참조) 블로그의 “Is Bash All You Need?” 포스트를 인용하며, 셸 도구만 사용한 에이전트, 파일 검색 도구만 사용한 에이전트, 데이터베이스 도구만 사용한 에이전트, 그리고 셸 도구와 데이터베이스 도구를 함께 사용한 에이전트를 비교한 실험을 소개했다. 결과적으로 하이브리드 에이전트—데이터베이스 도구로 검색한 후 셸 도구로 결과를 검증하는 방식—가 가장 높은 정확도를 달성했다.
Q: 에이전트 스킬이 쌓이면 컨텍스트 윈도우가 너무 커지지 않는가?
청중석의 Elastic 동료 Joe가 답변했다. Elastic 내부에서는 스킬 정의(이름, 설명, 파일 위치)만 시스템 프롬프트에 유지하고, 실제 스킬 내용은 파일 스토어에서 on-demand로 로드한 뒤 해당 스킬이 더 이상 필요 없을 때 컨텍스트에서 제거하는 방식으로 컨텍스트를 컴팩션(Compaction)한다고 설명했다. 이전 도구 결과도 마찬가지로 파일 스토어에 저장하고 필요할 때 grep으로 검색해 가져오는 패턴을 권장했다.
마무리
이 강연의 핵심 메시지를 한 문장으로 정리하면, “좋은 검색은 어렵고, 그렇기 때문에 에이전트를 위한 검색 도구 스택은 단일 만능 도구가 아닌, 낮은 진입 장벽의 특화 도구와 높은 확장 한계의 범용 도구의 균형 잡힌 조합이어야 한다”이다.
표면적으로는 에이전트에게 도구만 쥐어주면 알아서 잘 검색할 것 같지만, 현실에서는 도구 설명의 품질, 파라미터 복잡도, 오류 응답 설계, 에이전트 스킬을 통한 점진적 공개 등 섬세한 설계 결정들이 에이전트의 검색 성능을 좌우한다. 강연자는 코드 데모를 통해 의미 검색의 한계, 범용 쿼리 도구의 가능성과 도전, 셸 도구의 범용성과 비효율성을 균형 있게 보여주었고, 그 어떤 단일 도구도 완전한 해답이 아님을 강조했다.
컨텍스트 엔지니어링이 결국 에이전트가 무엇을 컨텍스트 윈도우에 담을지를 결정하는 기술이라면, 그 결정을 실행하는 검색 도구의 설계야말로 에이전트 시스템 품질의 진정한 결정자라는 것이 강연 전체를 관통하는 통찰이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Agentic Search for Context Engineering — Leonie Monigatti, Elastic |
| 채널 | AI Engineer |
| 발표자 | Leonie Monigatti (Elastic) |
| 리포트 작성 | 2026-05-09 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Benchmarking semantic code retrieval on Claude Code — Kuba Rogut, Turbopuffer
- Skills are the New SDKs - Elvin Aghammadzada, DataRobot
- How we taught agents to use good retrieval - Hanna Lichtenberg, Mixedbread AI
- RAG is dead, right?? — Kuba Rogut, Turbopuffer
- Mergeable by default - Building the context engine to save time and tokens - Peter Werry, Unblocked