Skills are the New SDKs - Elvin Aghammadzada, DataRobot
📺 원본 영상: Skills are the New SDKs - Elvin Aghammadzada, DataRobot
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-20
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
이 강연은 AI 에이전트 애플리케이션에서 Skills가 왜 새로운 SDK처럼 작동할 수 있는지를 설명한다. Elvin Aghammadzada는 긴 컨텍스트 윈도우, RAG, MCP, 문서화된 도구 설명만으로는 안정적인 에이전트 경험을 만들기 어렵다고 보고, Skills를 통해 필요한 지식을 런타임에 점진적으로 불러오는 방식이 더 현실적인 해법이라고 주장한다.
핵심 논지는 단순하다. 컨텍스트는 무한한 저장소가 아니라 제한된 예산이며, 좋은 에이전트 시스템은 더 많은 정보를 넣는 시스템이 아니라 적절한 순간에 필요한 정보만 노출하는 시스템이라는 것이다. 이 관점에서 Skills는 도구 호출의 목록을 늘리는 방식이 아니라, 에이전트가 특정 도메인과 작업 방식을 학습하고 재사용하게 만드는 실행 가능한 지식 패키지에 가깝다.
에이전트 앱의 세 가지 층위와 보이지 않는 버그
강연자는 모든 AI 또는 에이전틱 애플리케이션이 대체로 세 가지 층위로 구성된다고 설명한다. 사용자가 직접 보는 층위는 UI(User Interface)이고, 모델이 보는 층위는 시스템 프롬프트와 도구 설명이며, 데이터가 접하는 층위는 스키마와 툴 호출의 입력 및 출력 구조다. 흥미로운 점은 실제 문제가 사용자가 보는 UI보다, 모델과 데이터가 만나는 두 번째와 세 번째 층위에서 더 자주 발생한다는 것이다. 사용자는 표면적으로는 “에이전트가 이상하게 답했다”고 느끼지만, 내부적으로는 잘못 설계된 컨텍스트, 과도한 도구 설명, 불명확한 스키마가 모델의 판단을 흔드는 경우가 많다.
이 문제는 최근의 프런티어 모델이 “거의 무한한 컨텍스트 윈도우”를 제공한다는 인식과 맞물려 더 커진다. 강연자는 100만 토큰, 500만 토큰, 심지어 무한에 가까운 컨텍스트를 약속하는 모델이 등장하면서 개발자들이 RAG(Retrieval-Augmented Generation)와 MCP(Model Context Protocol)를 잘못 상상하게 되었다고 지적한다. 컨텍스트가 충분히 크다면 모든 문서와 모든 도구 설명을 그대로 넣으면 된다고 생각하기 쉽지만, 실제로는 입력이 많아질수록 모델이 잘못된 단서에 끌려가거나 불필요한 정보에 의해 오염될 가능성이 커진다.
강연에서 언급된 Context Rot 논문은 이 문제를 잘 보여주는 근거로 제시된다. 강연자에 따르면, 컨텍스트 윈도우의 약 25%를 사용한 뒤부터 성능 저하가 시작될 수 있으며, 100만 토큰 모델이라면 약 25만 6천 토큰을 사용한 시점부터 응답 품질이 낮아질 수 있다. 이 수치가 모든 모델과 모든 작업에 동일하게 적용된다고 단정할 수는 없지만, 강연의 메시지는 분명하다. 컨텍스트가 길어진다고 해서 모델이 더 똑똑해지는 것이 아니라, 오히려 오래된 대화, 실패한 도구 호출, 관련 없는 문서가 누적되면서 모델의 추론력이 흐려질 수 있다는 것이다.
문서는 사람을 위해 쓰였지만, 에이전트는 다른 형식을 요구한다
두 번째 문제는 문서화 방식이다. 강연자는 문서 웹사이트로 유입되는 트래픽 중 코딩 에이전트에서 발생하는 비중이 지난해 10% 수준에서 올해 50% 수준까지 늘었다고 언급한다. 정확한 집계 방식은 영상의 음성만으로는 확인하기 어렵지만, 개발 문서의 주요 소비자가 사람에서 에이전트로 빠르게 이동하고 있다는 방향성은 강연의 중요한 배경이다.
기존 문서는 기본적으로 사람을 위해 쓰였다. 사람은 문서를 읽다가 빠진 전제를 추론하거나, 모르는 용어를 검색하거나, 예제를 실행해보며 이해를 보완할 수 있다. 반면 모델은 그런 인간적 보완 과정을 자동으로 수행하지 못하며, 이를 가능하게 하려면 별도의 컨텍스트 엔지니어링이 필요하다. 따라서 에이전트 시대의 문서는 단순한 설명서가 아니라, 모델이 언제 어떤 정보를 읽어야 하고 어떤 순서로 행동해야 하는지를 안내하는 실행 지식으로 바뀌어야 한다.
이 지점에서 Skills의 의미가 드러난다. Skills는 사람이 읽는 문서와 모델이 실행하는 도구 사이의 중간층처럼 작동한다. 단순히 API 사용법을 설명하는 것이 아니라, 특정 작업을 수행하는 데 필요한 운영 지식, 판단 기준, 스크립트, 예제, 외부 도구 접근 방식을 하나의 패키지로 묶는다. 그래서 Skills는 “문서”이면서 동시에 “작업 방식”이고, 경우에 따라서는 “경량 실행 환경”이 된다.
방어적 Moat에서 공격적 Fluency Moat로
강연의 전략적 메시지는 엔터프라이즈 AI에서 경쟁우위의 성격이 바뀌고 있다는 주장으로 이어진다. 과거 소프트웨어 기업의 Moat는 전환 비용(Switching Cost)에 기반했다. 하드웨어, 데이터, 통합, SaaS 생태계에 깊이 묶일수록 고객은 다른 플랫폼으로 이동하기 어려웠고, 기업은 그 마찰을 방어적 우위로 활용할 수 있었다.
그러나 강연자는 AI 코딩 에이전트의 발전이 이 전환 비용 자체를 낮추고 있다고 본다. Claude Code 같은 도구가 대규모 코드베이스를 Python에서 Rust로 변환하거나, 더 나은 API와 언어로 이전하는 작업을 며칠 안에 수행할 수 있다면, 기존의 락인 전략은 약해질 수밖에 없다. 소프트웨어를 바꾸는 일이 점점 쉬워지면, 고객을 붙잡는 힘은 “떠나기 어렵게 만드는 마찰”이 아니라 “계속 쓰고 싶게 만드는 숙련된 경험”에서 나온다.
강연자는 이를 Fluency Moat라고 표현한다. Friction Moat가 고객을 묶어두는 방어적 전략이라면, Fluency Moat는 플랫폼 사용 경험을 매끄럽고 신뢰 가능하게 만들어 자연스럽게 계속 쓰게 하는 공격적 전략이다. 사용자가 의도한 결과에 도달하는 시간이 짧고, 에이전트가 플랫폼의 작업 방식을 잘 이해하며, 반복 사용을 통해 더 나은 결과를 낸다면 그 경험 자체가 경쟁우위가 된다. Skills는 바로 이 경험 계층을 에이전트에게 이식하는 수단으로 제시된다.
Teachability가 엔터프라이즈 AI 평가 기준이 된다
기업이 AI 플랫폼을 평가할 때 보는 체크리스트는 이미 익숙하다. 보안, 컴플라이언스, 데이터 거버넌스, 데이터 저장 위치, SLA(Service Level Agreement), 로그, 트레이싱, 인증 시스템 연동, 온프레미스 시스템 접근 등이 대표적이다. 강연자는 여기에 Teachability, 즉 에이전트가 새로운 플랫폼의 운영 지식을 얼마나 빠르게 배울 수 있는지가 새로운 평가 항목으로 들어와야 한다고 말한다.
Teachability의 핵심은 사람만 온보딩하는 것이 아니라 에이전트도 온보딩해야 한다는 점이다. 어떤 기업의 에이전트 하네스가 새로운 플랫폼을 처음 사용할 때, 그 플랫폼에 축적된 절차와 업무 방식을 몇 초 안에 이해하고 적용할 수 있어야 한다. 이것이 가능하려면 운영 지식이 사람의 머릿속이나 산발적인 문서에만 존재해서는 안 되며, 에이전트가 필요할 때 읽고 실행할 수 있는 형태로 인코딩되어야 한다.
이 관점에서 Skills는 엔터프라이즈 AI의 배포 단위가 될 가능성이 있다. 기업은 더 이상 모든 고객과 도메인을 위해 별도의 에이전트를 처음부터 만들 필요가 없고, 강력한 범용 에이전트 위에 산업별, 업무별 Skills를 얹는 방식으로 솔루션을 확장할 수 있다. 제조, 공급망, 의료, 금융처럼 도메인 지식이 중요한 분야에서도 에이전트의 엔진은 공통으로 유지하되, 실제 차별화는 Skills 계층에서 만들어질 수 있다는 뜻이다.
Context Engineering은 컨텍스트를 줄이는 기술이다
강연자는 현재 LLM과 에이전트 생태계가 아직 React와 같은 표준적 개발 철학을 갖지 못했다고 말한다. React가 UI 개발에서 반응성(Reactivity)과 모듈성(Modularity)의 공통 언어를 제공했던 것처럼, 장기 실행 에이전트 시스템에도 일관된 구성 원칙이 필요하다. Context Engineering은 그 공백을 메우려는 시도 중 하나로 소개된다.
강연자가 정의하는 Context Engineering의 목적은 정보를 많이 넣는 것이 아니라, 필요한 순간에 필요한 정보만 모델로 흘려보내는 것이다. 일반적인 에이전트에는 시스템 지시문, CLAUDE.md 같은 프로젝트 지침, 내장 도구, MCP 연결, 사용자 프롬프트, 업로드된 PDF, RAG 데이터, 실행 기록, 세션 상태, 장기 메모리, 출력 스키마가 함께 존재한다. 이 모든 것이 한 번에 모델의 컨텍스트로 들어가면, 모델은 작업을 시작하기도 전에 추론 여유를 잃을 수 있다.
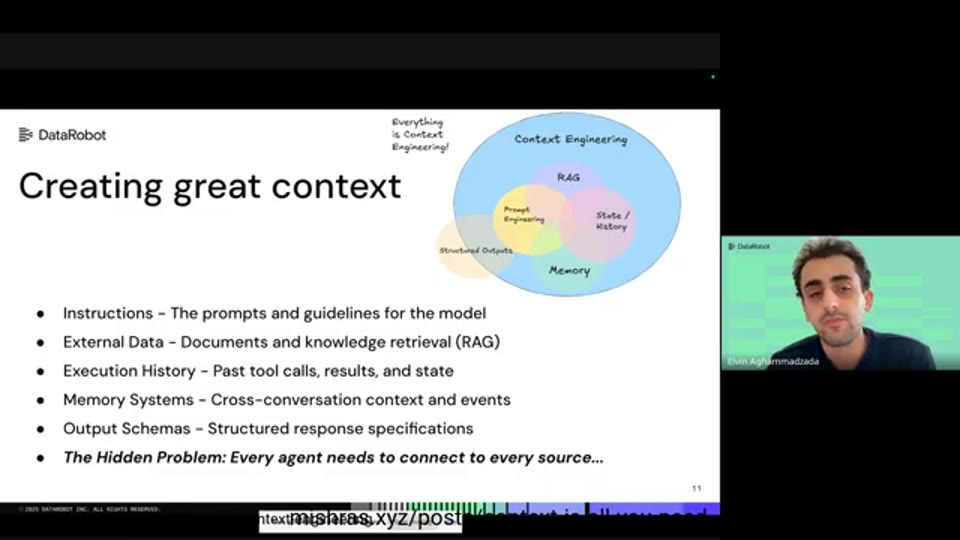
11:31 - 에이전트 컨텍스트를 구성하는 시스템 지시문, 외부 데이터, 실행 기록, 메모리, 출력 스키마를 설명하는 구간
강연자는 전체 컨텍스트 중 약 40% 이하를 모델이 비교적 잘 작동하는 “Smart Zone”으로 설명하고, 그 이상을 넘어서면 응답 품질이 떨어지는 “Dumb Zone”으로 표현한다. 이 비유의 기술적 엄밀성은 모델과 작업에 따라 달라질 수 있지만, 개발 실무에서의 경고는 분명하다. 에이전트가 대화를 시작하기도 전에 과도한 MCP 도구 설명, 문서, 지침, 검색 결과로 컨텍스트를 채워버리면, 첫 번째 사용자 요청부터 이미 나쁜 상태에서 출발할 수 있다.
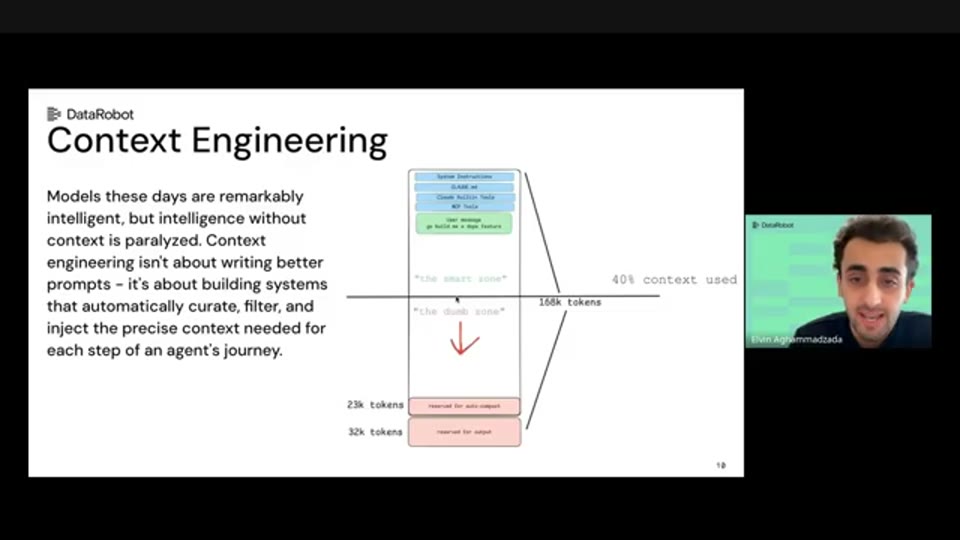
10:23 - 컨텍스트 사용량이 늘어날 때 Smart Zone과 Dumb Zone으로 나뉘는 개념을 설명하는 구간
Skills의 핵심은 Progressive Disclosure다
Skills가 해결하려는 문제는 풍부한 컨텍스트 접근성과 제한된 컨텍스트 예산 사이의 충돌이다. 전통적인 접근에서는 필요한지 여부와 무관하게 모든 지식과 도구 설명을 컨텍스트에 밀어 넣는다. 그 결과 에이전트는 많은 것을 “알고 있는 것처럼” 보이지만, 실제로는 관련 없는 정보까지 함께 처리하느라 판단 품질이 낮아진다.
Skills는 이 흐름을 바꾼다. 에이전트는 처음부터 Skill의 전체 내용을 읽는 것이 아니라, 먼저 매우 작은 메타데이터만 본다. 이 메타데이터는 데이터베이스의 인덱스처럼 작동하여, 어떤 Skill이 어떤 상황에 유용한지 빠르게 판단하게 한다. 이후 실제로 Skill이 필요하다고 판단되는 순간에만 본문, 스크립트, 예제, 추가 문맥이 로드된다.
강연자는 MCP 서버 15개만 연결해도 도구 정의만으로 세션당 10만 토큰 이상을 소비할 수 있다고 언급한다. 반면 Skills는 Progressive Disclosure 덕분에 같은 운영 부담을 훨씬 작게 만들 수 있으며, 강연자는 최소 10배 이상 작아질 가능성을 제시한다. 이 숫자는 구체적인 구현과 Skill 구조에 따라 달라질 수 있지만, 중요한 것은 비용 절감 자체보다 설계 원리다. Skills는 “언제나 모든 것을 설명하는 방식”에서 “필요할 때만 자세히 설명하는 방식”으로 에이전트 구조를 바꾼다.
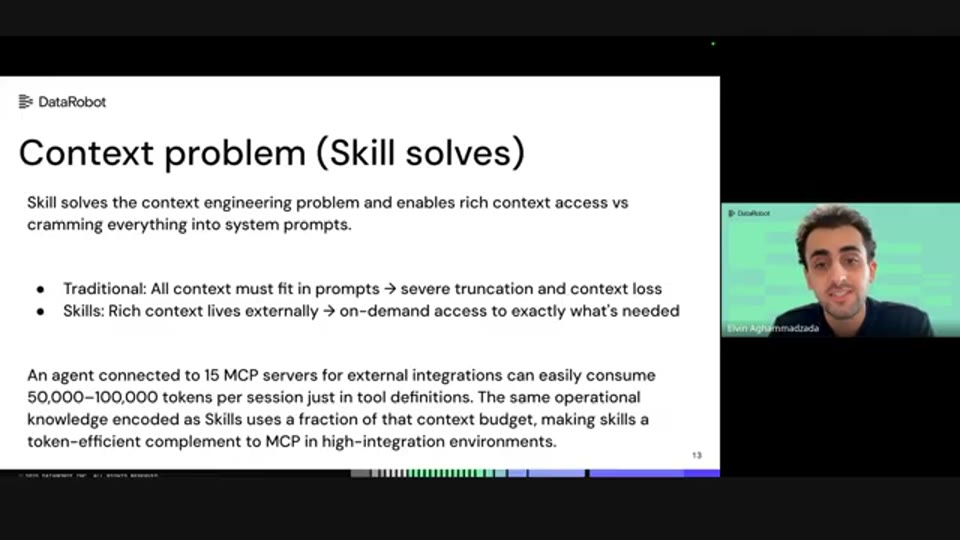
13:49 - MCP 서버 도구 정의가 많은 토큰을 소비하고 Skills의 Progressive Disclosure가 이를 줄일 수 있음을 설명하는 구간
Skills와 MCP는 경쟁 관계가 아니라 역할이 다르다
강연의 두 번째 파트는 Skills와 MCP의 차이를 설명한다. 두 기술 모두 Anthropic 생태계에서 나온 것으로 언급되며, 서로 같은 문제를 두고 경쟁하는 것이 아니라 다른 층위를 담당한다고 정리된다. MCP는 에이전트가 어떤 외부 액션을 수행할 수 있는지 정의하는 프로토콜에 가깝고, Skills는 에이전트가 문제를 어떻게 이해하고 어떤 방식으로 접근해야 하는지를 바꾸는 지식 패키지에 가깝다.
MCP는 인증, 접근 제어, 원격 실행, 격리된 프로세스, 고성능 리소스가 필요한 작업에 강하다. 예를 들어 개인 노트북에서 처리할 수 없는 400TB 규모의 문서 검색, 75개 GPU가 필요한 계산, 의료 기록처럼 제한된 환경 안에 있는 데이터 접근은 호스팅된 MCP 서버가 더 적합하다. 반대로 Skills는 에이전트가 특정 작업을 추론하는 방식, 템플릿화된 코드 실행, 반복 가능한 절차, 플랫폼별 운영 지식을 습득하는 데 강하다.
강연 중간에 다른 발화자는 Skill이 MCP 서버를 노출할 수도 있고, MCP 서버 안에 있던 도구를 Skill 내부로 가져와 실행할 수도 있다고 덧붙인다. 이 설명은 두 방식이 서로 배타적이지 않다는 점을 보여준다. 좋은 설계에서는 Skills가 MCP의 사용법을 점진적으로 노출하고, MCP는 로컬 에이전트가 직접 수행하기 어려운 원격 작업과 격리된 실행을 담당한다. 따라서 “Skills냐 MCP냐”가 아니라, 어떤 지식은 Skill로 두고 어떤 실행은 MCP로 둘지 결정하는 아키텍처 판단이 중요해진다.
Skill은 세 층으로 읽힌다
강연자는 Skill 구조를 세 단계로 설명한다. 첫 번째는 Skill 상단의 Frontmatter 또는 메타데이터이며, 런타임에서 에이전트가 먼저 읽는 작은 인덱스 역할을 한다. 이 부분은 보통 100토큰 미만의 작은 설명으로 구성되며, 에이전트가 해당 Skill을 활성화할지 판단하는 데 사용된다.
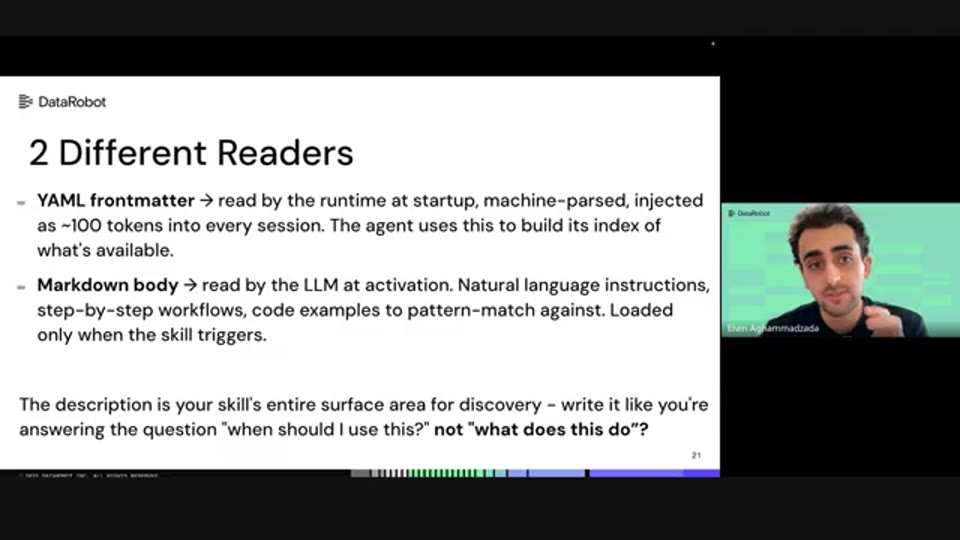
20:48 - Skill 상단 Frontmatter가 런타임 인덱스처럼 작동하는 구조를 설명하는 구간
두 번째는 Markdown 본문이다. 이 본문은 에이전트가 Skill이 필요하다고 판단했을 때 로드되며, 보통 5천 토큰 미만의 구체적 지침, 절차, 예제, 판단 기준을 담는다. 중요한 점은 본문이 항상 시스템 프롬프트에 올라가는 것이 아니라, 활성화된 경우에만 모델의 컨텍스트로 들어간다는 것이다. 이 구조 덕분에 Skill은 많은 지식을 담을 수 있으면서도 평소에는 컨텍스트를 거의 쓰지 않는다.
세 번째는 스크립트와 추가 리소스다. Claude Code 같은 환경에서는 Skill 내부의 Python 스크립트를 실제로 실행하고, 전체 코드가 아니라 실행 결과만 컨텍스트로 되돌릴 수 있다. 다른 플랫폼에서는 스크립트가 실행 가능한 코드라기보다 예제 코드나 참고 자료로 쓰일 수도 있다. 이 세 층 구조는 Skills가 단순한 문서가 아니라, 메타데이터, 절차 지식, 실행 자산을 함께 담는 소프트웨어 패키지임을 보여준다.
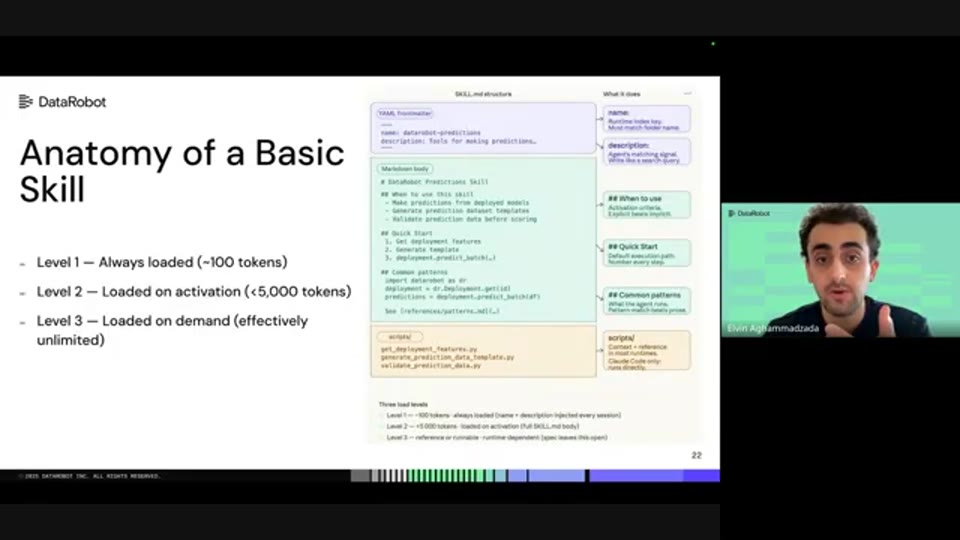
21:48 - Skill의 세 계층인 메타데이터, Markdown 본문, 스크립트 또는 추가 컨텍스트를 설명하는 구간
생태계 확산과 OpenCode 사례가 보여주는 가능성
강연자는 현재 26개 이상의 플랫폼이 Skills를 지원하고 있으며, Claude Code, Codex, Copilot, Gemini CLI 등이 이 흐름에 포함된다고 말한다. 또한 이미 수십만 개 수준의 Skills가 존재하고, Skills를 사고파는 마켓플레이스도 등장하고 있다고 언급한다. 이는 Skills가 단순한 특정 제품의 기능이 아니라, 에이전트 생태계 전반에서 공통 인터페이스로 자리 잡을 가능성을 보여준다.
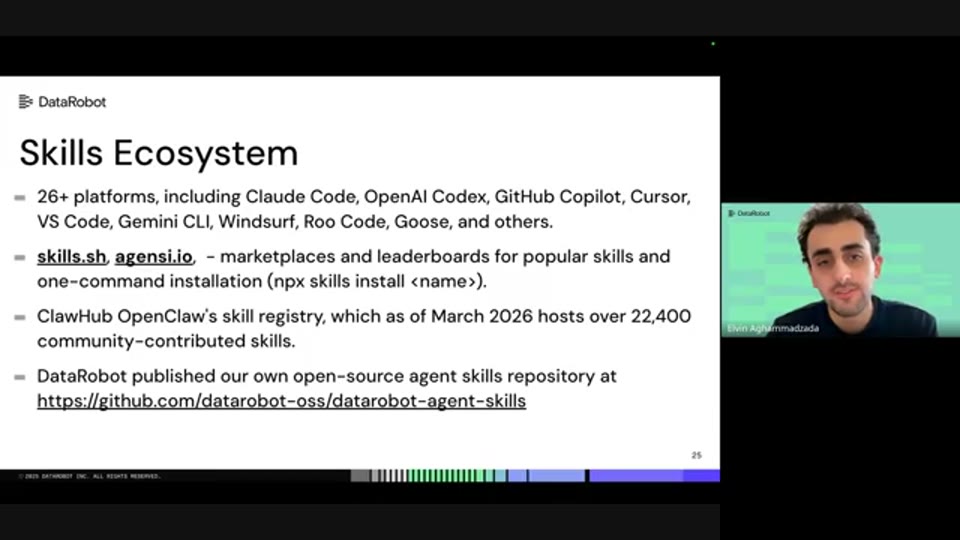
22:53 - Skills를 지원하는 플랫폼과 마켓플레이스 등 생태계 확산을 설명하는 구간
OpenCode 사례는 이 가능성을 더 선명하게 보여주는 예로 제시된다. 강연자는 OpenCode가 많은 스타를 받은 저장소가 되었고, 그 안에서 컨텍스트 엔지니어링, Sub-agent, 자기 진화형 Skills(Self-evolving Skills)가 인상적으로 작동한다고 설명한다. 특히 에이전트가 자신의 경험을 바탕으로 Skill을 수정하거나 새 Skill을 작성해 능력을 확장할 수 있다는 점은 강력하면서도 위험한 특징이다.
이 사례가 기업 솔루션에 주는 함의는 크다. 강연자에 따르면, 약 10개의 기본 도구만 가진 코딩 에이전트도 Skills가 충분히 잘 설계되어 있다면 매우 다양한 작업을 수행할 수 있다. 이는 산업별 에이전트를 따로 만드는 방식보다, 하나의 좋은 범용 에이전트 위에 도메인별 Skills를 구축하는 방식이 더 확장 가능할 수 있음을 시사한다. 다시 말해 앞으로의 경쟁력은 “에이전트를 몇 개 만들었는가”보다 “좋은 Skills를 얼마나 체계적으로 만들고 검증했는가”에서 나올 수 있다.
LLM이 직접 만든 Skills의 위험
강연자는 에이전트가 스스로 Skills를 작성하는 방향에 대해 조심스러운 입장을 보인다. 최근 연구에 따르면 LLM이 생성한 Skills가 오히려 성능을 떨어뜨릴 수 있으며, 더 많은 토큰을 쓰고 더 긴 추론 시간을 요구하면서 본래 의도와 반대로 작동할 수 있다고 언급한다. 이는 Skill이 단순한 메모가 아니라 소프트웨어에 가까운 산출물이기 때문에, 품질이 낮으면 에이전트의 작업 흐름 전체를 오염시킬 수 있음을 의미한다.
보안 위험도 크다. 누구나 Skills를 만들고 배포할 수 있는 상황에서는 Prompt Injection, 악성 명령, 불투명한 스크립트 실행 문제가 발생할 수 있다. MCP는 별도 서버와 프로세스 격리를 통해 일정 수준의 경계를 만들 수 있지만, Skills는 대체로 에이전트가 실행되는 로컬 환경 안에서 작동하기 때문에 격리 수준이 낮을 수 있다. 강연자는 현재 Skills 마켓플레이스가 검증과 통제 체계를 충분히 갖추지 못했다는 점을 NPM 생태계 초기의 불안정성과 비교한다.
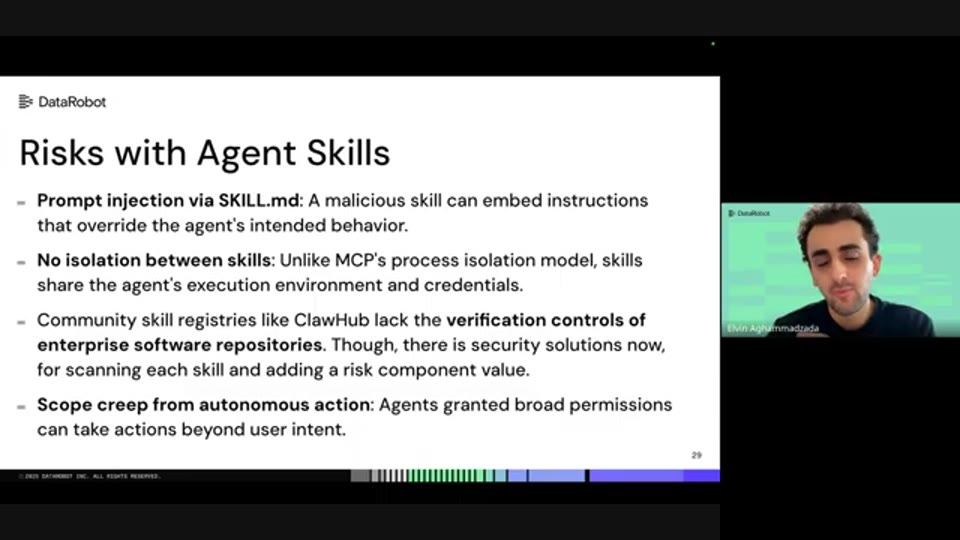
25:42 - Skills 마켓플레이스의 검증 부족과 NPM 초기 생태계에 비유한 보안 위험을 설명하는 구간
따라서 Skills는 생산성을 높이는 도구인 동시에, 소프트웨어 공급망 리스크의 새로운 표면이 된다. 좋은 Skill을 작성하려면 도메인 지식, 작업 절차, 보안 고려, 테스트 가능성, 버전 관리가 모두 필요하다. 강연자가 “Skill은 그것을 작성한 인간만큼 좋다”고 말하는 이유도 여기에 있다. 에이전트가 Skill을 만들 수 있다고 해서 검증되지 않은 Skill을 곧바로 신뢰할 수 있는 것은 아니다.
마무리 / 핵심 정리
강연의 결론은 “컨텍스트는 예산이다”라는 문장으로 압축된다. 긴 컨텍스트 윈도우는 유용하지만, 그것이 모든 정보를 무차별적으로 넣어도 된다는 뜻은 아니다. 관련 없는 파일, 불필요한 웹 검색 결과, 실패한 오류 메시지, 과도한 도구 정의는 모두 에이전트의 주의를 분산시키고 추론 능력을 떨어뜨린다.
Skills는 이 문제에 대한 실용적인 해법으로 제시된다. MCP가 원격 실행, 인증, 리소스 접근, 프로세스 격리에 강하다면, Skills는 에이전트가 문제를 이해하고 도메인 지식을 적용하며 필요한 문맥을 점진적으로 불러오는 데 강하다. 두 방식은 경쟁하기보다 보완적으로 설계될 때 가장 큰 효과를 낸다.
결국 Skills는 새로운 SDK처럼 작동한다. 과거 SDK가 개발자가 플랫폼 기능을 호출하는 인터페이스였다면, Skills는 에이전트가 플랫폼의 작업 방식과 운영 지식을 배우는 인터페이스가 된다. 엔터프라이즈 AI에서 중요한 것은 단순히 더 많은 도구를 연결하는 것이 아니라, 신뢰 가능한 경험을 재현할 수 있는 Skills를 버전 관리하고, 평가하고, 테스트하는 것이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Skills are the New SDKs - Elvin Aghammadzada, DataRobot |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-20 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.