Build & Deploy AI-Powered Apps — Paige Bailey, Google DeepMind
📺 원본 영상: Build & deploy AI-powered apps — Paige Bailey, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-30 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다. 일부 모델 명칭은 STT 오류로 인해 원문 발음과 실제 명칭이 다를 수 있으며, 해당 부분에 추정 내용을 표기하였습니다.
개요
이 강연은 Google DeepMind의 Developer Relations 엔지니어링 리드인 Paige Bailey가 AI Engineer 컨퍼런스에서 진행한 데모 중심의 세션이다. 슬라이드보다 실제 동작하는 데모를 통해 Google의 최신 AI 모델들과 AI Studio 플랫폼의 기능을 직접 보여주는 것이 특징이며, 개발자들이 AI 기반 애플리케이션을 얼마나 빠르고 쉽게 구축·배포할 수 있는지를 다각도로 소개한다. 강연은 최근 한 달 반 사이 Google이 쏟아낸 신규 모델들의 현황 소개로 시작해, AI Studio의 핵심 기능 데모를 거쳐 Genie 3, Lyria 3, Veo 3.1 등 생성형 미디어 모델 생태계 전반을 훑는 여정을 담고 있다.
연사 소개 및 Google AI의 현재
Paige Bailey는 2009년부터 머신러닝 분야에 몸담아 온 베테랑 엔지니어다. NumPy, SciPy, Scikit-learn 등 초기 오픈소스 과학 컴퓨팅 라이브러리 개발에 기여했고, 이후 프로덕트 매니지먼트를 거쳐 다시 엔지니어링 트랙으로 돌아왔다. 현재 Google DeepMind의 Developer Relations 엔지니어링 리드를 맡고 있으며, 무엇이 제품이고 무엇이 엔지니어링이며 무엇이 DevRel인지 경계가 모호해지는 현재 AI 산업의 흐름을 직접 체감하고 있다고 강연에서 솔직히 밝혔다.
강연 시점에서 Google은 약 한 달 반 사이에 매우 빠른 속도로 모델들을 출시해 왔으며, Bailey는 이를 “whiplash(채찍 충격)“라는 표현으로 묘사했다. 출시된 모델들을 정리하면 다음과 같다.
| 모델 | 카테고리 | 주요 특징 |
|---|---|---|
| Gemini 3.1 Flash Live | 실시간 멀티모달 | 화면·음성·영상 실시간 대화 |
| Gemini 3.1 Pro | 대형 언어 모델 | 최대 성능, 고비용 |
| Gemini 3 Flash | 언어 모델 | 프로덕션 워크호스 |
| Gemini 3.1 Flash Light | 언어 모델 | 소형·저비용·고속 |
| Imagen 3 [원문: nano banana 2, STT 오류 추정] | 이미지 생성·편집 | 고품질 이미지 생성 및 편집 |
| Embeddings 모델 | 멀티모달 임베딩 | 영상·이미지·오디오·텍스트·코드 통합 임베딩 공간 |
| Lyria 3 [원문: Liria free, STT 오류 추정] | 음악 생성 | 멜로디·가사 포함 음악 생성 |
| Genie 3 | 월드 모델 | 동적 인터랙티브 세계 픽셀 생성 |
| Gemma 4 | 오픈 모델 | Apache 2 라이선스, 모바일·로컬 실행 가능 |
| Veo 3.1 Light | 영상 생성 | 오디오 포함 스톡 영상 생성 |
이 중 특히 주목할 만한 사례는 Augment Code가 전체 에이전트 시스템을 Gemini 3.1 Pro로 재구축(replatformed)한 것이다. 성능과 비용 두 측면에서의 경쟁력이 검증된 사례로, 개발자 입장에서 의미 있는 신호다. Embeddings 모델의 경우 고양이와 관련된 모든 콘텐츠를 검색하면 고양이 영상뿐 아니라 고양이 울음소리 오디오, 고양이에 관한 책까지 단일 임베딩 공간에서 함께 검색된다는 점이 강조되었는데, 이는 모달리티 경계를 초월한 검색과 추천의 가능성을 잘 보여주는 예시다.
AI Studio: 개발자를 위한 올인원 플레이그라운드
낮은 진입 장벽, 즉각적인 실험 환경
AI Studio는 ai.dev, ai.studio, 또는 aistudio.google.com으로 접근할 수 있으며, 개인 Gmail 계정만 있으면 무료로 시작할 수 있다. 우측 패널에서 Gemini 및 Veo 모델을 선택하고, 구조화 출력(Structured Outputs), 코드 실행(Code Execution), 함수 호출(Function Calling), Google 검색 기반 그라운딩(Grounding with Google Search), Google Maps 그라운딩, URL 컨텍스트(URL Context) 등을 개별 토글로 켜고 끌 수 있다. 또한 Gemini 3.1 시리즈에는 Thinking 레벨(minimal · low · medium · high)이 지원되어, 더 많은 토큰을 추론에 소비할수록 정교한 결과를 얻을 수 있다.
Bailey가 강연 내내 반복적으로 강조한 기능은 “Get Code” 버튼이다. AI Studio UI에서 진행한 실험 전체를 Python, TypeScript, Java 등 다양한 언어의 코드로 즉시 내보낼 수 있어, 프로토타입에서 실제 구현으로의 전환 비용이 거의 없다. 모델 설정, 미디어 해상도, 압축 설정, 프롬프트 구조까지 모두 코드에 반영된다.
YouTube URL 기반 영상 분석
Gemini 모델의 가장 실용적인 기능 중 하나는 YouTube URL을 직접 붙여넣기만 해도 해당 영상을 추론에 활용할 수 있다는 점이다. 영상을 다운로드하거나 별도의 전처리 없이, URL 하나로 영상 전체를 토큰화해 모델에 공급한다. 기본 설정은 초당 1프레임이며 시작·종료 시간을 지정해 특정 구간만 처리할 수도 있다. 5분 분량의 영상은 약 27,600개의 토큰을 소비한다고 강연에서 언급되었다. 데모에서는 공룡 캐릭터가 등장하는 아동용 애니메이션 영상을 분석해 공룡 종류별 타임스탬프 표를 생성하는 작업을 시연했는데, Google Search 그라운딩 도구가 함께 활성화되어 각 공룡에 대한 사실(fun fact)을 실시간 검색으로 보완했다. 모델이 익룡(Pteranodon)이 공룡(Dinosaur)이 아닌 익룡류(Pterosaur)임을 정확히 지적한 것도 인상적인 장면이었다.
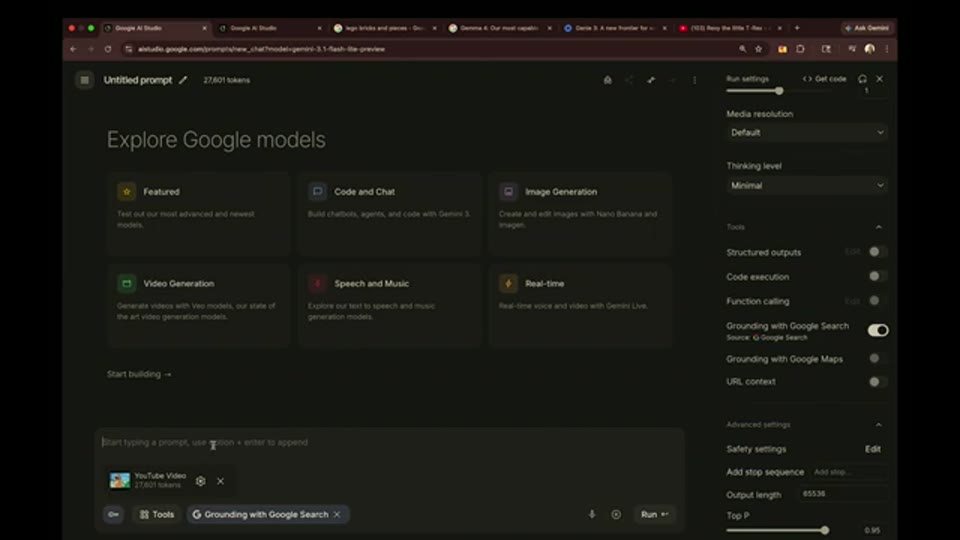
09:43 - YouTube 공룡 영상 분석 결과 화면 - 공룡 종류별 타임스탬프 표와 Google 검색 그라운딩 인용 출처가 함께 표시됨
코드 실행(Code Execution) 도구와 비교 모드
코드 실행 도구는 Gemini에게 Python과 다수의 데이터 과학 라이브러리가 사전 설치된 샌드박스 환경을 도구(tool)로 제공한다. 이 환경은 완전히 격리되어 있어 로컬 환경에 영향을 주지 않으며, 모델은 이 샌드박스를 서브 도구로 호출해 임의의 데이터 분석 또는 이미지 처리 작업을 수행할 수 있다. 나아가 비교 모드(Compare Mode)는 두 개의 모델을 나란히 놓고 동일한 태스크에 대한 성능·비용·속도를 직접 비교할 수 있는 기능이다.
데모에서는 Lego 브릭 이미지를 입력으로 “초록색 Lego 브릭 주변에 바운딩 박스를 Python으로 그려 이미지를 표시하라”는 프롬프트를 Gemini 3.1 Flash Light와 Gemini 3 Flash에 동시에 던졌다. Flash Light가 훨씬 빠르게 정확한 결과를 내놓았고, 비용은 두 모델 모두 1센트에 크게 못 미치는 수준이었다. Bailey는 소형 모델들이 코드 실행 같은 도구를 함께 사용할 때 얼마나 강력해지는지를 보여주는 사례라고 강조하며, 항상 대형 모델을 기본값으로 선택하기보다 소형 모델에서 시작해 도구를 붙여가며 한계를 테스트하는 접근을 권장했다.
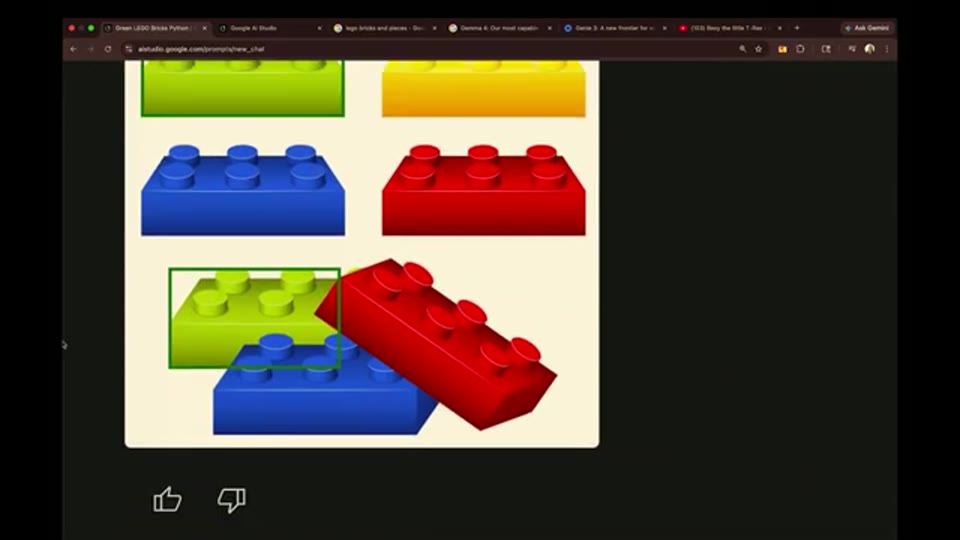
15:04 - 비교 모드(Compare Mode) 결과 화면 - Gemini 3.1 Flash Light(좌)와 Gemini 3 Flash(우)가 Lego 이미지에서 초록 브릭 바운딩 박스를 생성한 결과 및 비용 비교
URL 컨텍스트: 간이 RAG(검색 증강 생성)
URL 컨텍스트(URL Context) 기능은 외부 URL 목록을 모델의 컨텍스트에 직접 주입하는 방식이다. Bailey는 이를 “poor man’s retrieval(빈자의 검색)“이라고 표현했다. 벡터 데이터베이스를 따로 구축하지 않고도 특정 URL의 내용을 모델의 추론 근거로 활용할 수 있으며, 모델의 학습 데이터 컷오프 이후 발표된 최신 정보도 이 방식으로 모델에게 제공할 수 있다. 데모에서는 Genie 3와 Gemma 4의 공식 블로그 포스트 URL 두 개를 입력해 두 모델의 공통점과 차이점을 비교·분석하는 작업을 시연했는데, 모델이 각 주장 옆에 인용 출처를 인라인으로 명시하는 것을 확인했다. Vertex AI에서는 내부 전용 문서에 대한 커스텀 검색 기능도 별도로 제공된다고 덧붙였다.
Gemini Live: 실시간 멀티모달 대화의 새로운 지평
Gemini Live는 화면 공유, 카메라 영상, 오디오를 모델과 실시간으로 주고받으며 자연스러운 대화를 나눌 수 있는 기능이다. 단순히 정보를 입력하고 결과를 받는 기존 방식과 달리, 실시간으로 보이는 화면이나 카메라 피드를 모델이 즉각 인식하고 응답한다. 커스텀 함수 호출과 자동 함수 응답도 지원하며 Google Search 그라운딩 도구와 함께 사용할 수 있다.
강연 데모에서는 세 가지 시나리오가 특히 인상적이었다. 첫째, 화면에 표시된 Lego 이미지 검색 결과를 이탈리아어로 설명하고 런던 날씨까지 이탈리아어로 답하는 다국어 대응 능력을 시연했다. 청중 중 이탈리아어 원어민이 이를 즉석에서 검증했고 정확성을 확인했다. 둘째, Texan 억양으로 화면에 보이는 Lego 이미지를 묘사하는 시를 즉흥적으로 읊는 시나리오를 통해, 언어·방언·스타일의 유연한 실시간 전환 능력을 보여주었다. 셋째, 카메라를 통해 강연자가 손가락으로 숫자를 표현하자 “두 손가락을 펴고 있다”, “엄지 손가락을 올렸다”고 실시간으로 정확히 인식했다.
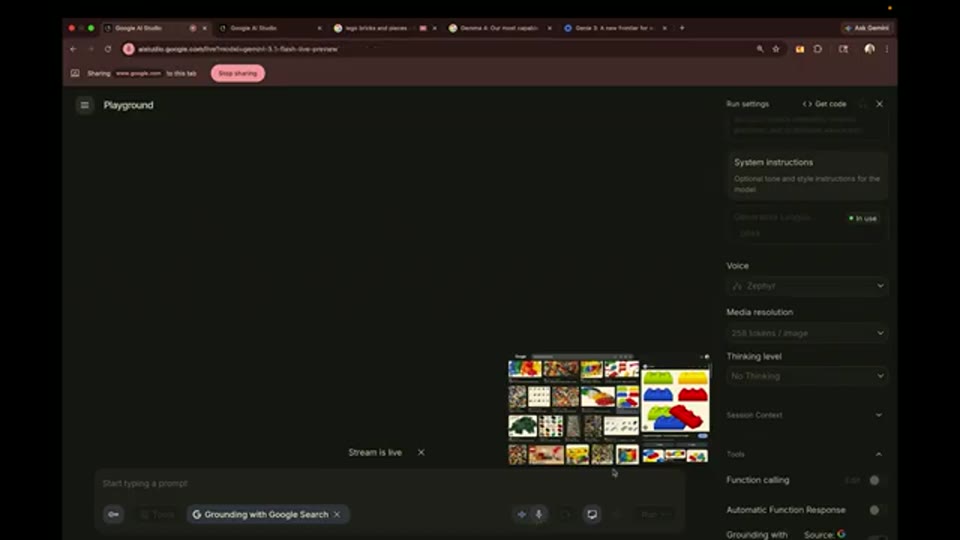
20:25 - Gemini Live 화면 공유 데모 - 화면에 표시된 Lego 검색 결과를 이탈리아어로 설명하고 런던 날씨까지 이탈리아어로 안내하는 실시간 대화
실용적 관점에서 Bailey는 은행 입구처럼 다양한 고객이 방문하는 접점에서 방문객이 자신에게 편한 언어로 자유롭게 질문하면 모델이 동적으로 해당 언어로 응답하는 유스케이스를 예시로 들었다. 또한 시스템 인스트럭션(System Instructions)에서 특정 언어·방언·어조·스타일을 고정해두면 항상 그 포맷으로만 응답하도록 강제할 수 있다고 설명했다. 기존 방식이 STT(Speech-to-Text) → LLM → TTS(Text-to-Speech) 파이프라인을 직접 구성해야 했다면, Gemini Live는 이 모든 과정과 영상 입출력까지 통합한 단일 솔루션으로, 비용과 구현 복잡도 양면에서 상당한 이점이 있다고 강조했다.
AI Studio Build: 풀스택 앱을 프롬프트 하나로
AI Studio의 Build 기능은 v0.dev나 Lovable과 유사한 개념으로, 프롬프트 입력만으로 풀스택 웹 애플리케이션을 생성·배포하고 공유할 수 있는 기능이다. 최근 Firestore 데이터베이스 통합, Firebase Authentication 기반의 Google 로그인, 커스텀 API 키 관리 기능이 추가되어 실제 프로덕션 수준의 앱 구축이 가능해졌다. 생성된 앱은 Cloud Run에 원클릭으로 배포하는 옵션도 제공된다.
데모에서 Bailey는 음성 입력을 통해 다음 요구사항을 담은 앱 생성을 요청했다. 책장 사진을 업로드하면 책 제목·저자·설명·카테고리를 자동으로 인식하고, Google Search 그라운딩으로 추가 정보를 보완하며, Google 로그인으로 인증한 뒤 분석 결과를 Firestore 데이터베이스에 영속 저장하는 것이 핵심 요구사항이었다. Gemini 3.1 Pro가 앱 생성을 담당해 TypeScript, CSS 등 전체 코드와 Firebase 데이터베이스 블루프린트, 보안 규칙까지 자동으로 작성했다. 완성된 앱에 실제 책장 이미지를 업로드하자 책 제목과 저자를 인식했고, 로그아웃 후 재로그인해도 목록이 그대로 유지되었다. Bailey는 이런 기능이 3~4년 전만 해도 스타트업 아이디어가 될 수 있었을 것이라고 언급하며, 생성형 AI가 소프트웨어 개발의 시작 비용을 근본적으로 낮추고 있다는 점을 시사했다.
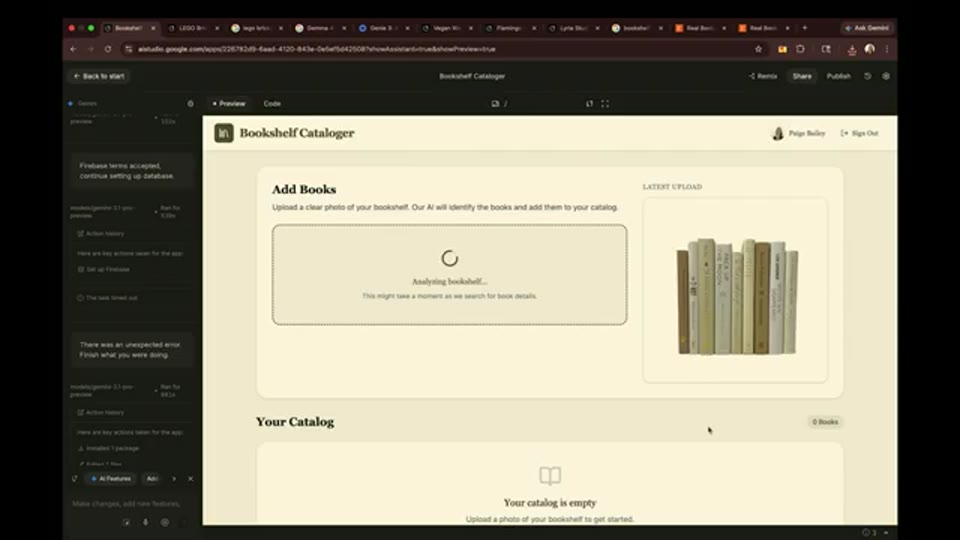
57:42 - AI Studio Build로 완성된 북쉘프 카탈로거 앱 - 책장 이미지 업로드 시 책 정보가 자동 인식되어 Firestore에 저장된 결과 화면
Genie 3: 픽셀로 빚는 동적 세계
Genie 3는 DeepMind의 월드 모델(World Model)로, 물리 엔진이나 Unity·Unreal 같은 게임 엔진 없이 모든 프레임을 픽셀 단위로 동적으로 생성한다. 사용자가 장면과 캐릭터를 텍스트로 묘사하면 실시간으로 인터랙티브 세계가 생성되며, WASD 키로 캐릭터를 이동시키고 화살표 키로 시점을 변경할 수 있다. 강연자는 화산 지형, 제트스키를 타는 수상 환경, 허리케인 내부, 해저 해파리 군집 등 다양한 환경 예시를 소개했다.
기술적으로 Genie 3는 단일 모델이 아닌 여러 모델의 합성(Composition of Models)이다. Imagen 계열 이미지 생성 모델[원문: nano banana], Veo 영상 생성 모델, 그리고 프롬프팅을 담당하는 Gemini가 분산 시스템 및 컴퓨팅 최적화 기법과 결합되어 하나의 동적 세계를 만들어낸다. 각 모델이 자신의 전문 영역을 담당하며, 학습 데이터에서 습득한 물리적 특성이 반영되어 충돌 등의 상황에서 물리 엔진처럼 반응하는 모습도 관찰된다.
데모에서 Bailey는 “Lego 브릭으로 만들어진 암석 지형, 네 겹의 무지개가 있는 여름 하늘, 분홍색 로켓 추진기와 고글을 착용한 타조 캐릭터, 텍사스 Big Bend 국립공원”을 묘사하는 프롬프트를 입력해 세계를 생성했다. 생성된 타조 캐릭터는 근육이 과장된 형태로 등장해 청중의 웃음을 자아냈으며, Lego 브릭 형태의 암석 지형을 실제로 탐험하는 모습을 시연했다.
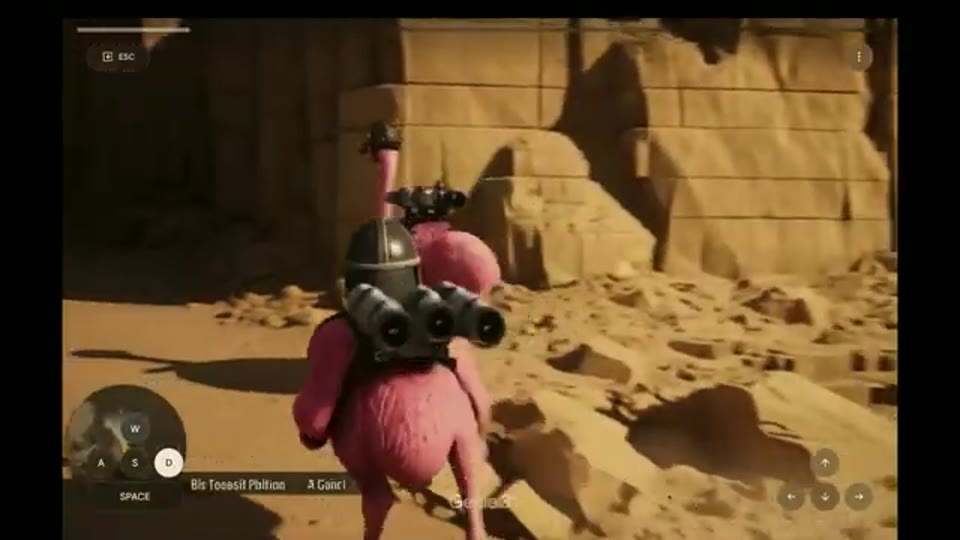
34:27 - Genie 3 월드 생성 결과 - Lego 브릭 지형의 텍사스 Big Bend 국립공원과 분홍색 로켓 추진기를 단 타조 캐릭터가 등장한 생성 세계
한 청중이 3D 게임 에셋으로의 활용 가능성을 묻자, Bailey는 “생성되는 것은 오직 픽셀이며 3D 메시나 게임 에셋을 직접 생성하지는 않는다”고 명확히 선을 그었다. 다만 Imagen 계열 모델로 생성한 이미지를 추가 기법으로 3D 에셋으로 변환하는 시도들이 이미 일부 커뮤니티에서 이루어지고 있다는 사례도 언급했다. 장기적으로는 영상 입력 → 3D 월드 코드 출력과 같은 방향으로 모달리티 수렴이 이루어질 가능성도 시사했다. 현재 Genie 3는 API로 제공되지 않으며 Google Ultra 구독을 통해 접근 가능하다.
생성형 미디어 모델 생태계
Imagen 3 [원문: nano banana 2]: 이미지 생성과 편집
Imagen 3[STT 오류 추정, 원문 발음 불명확]는 이미지 생성 및 편집 모델로, AI Studio에서 이미지 검색 그라운딩(Image Search Grounding) 기능과 함께 사용할 수 있다. 이 기능은 리버스 이미지 검색을 통해 요청과 밀접하게 연관된 레퍼런스를 자동으로 가져와 생성 품질을 향상시킨다. 데모에서는 강아지 사진, 자연 풍경 사진, 이미지 검색 그라운딩을 함께 활용해 “자연 공원 한가운데서 Celsius 에너지 드링크 캔을 들고 있는 강아지” 이미지를 생성했다. 비용 측면에서 Imagen 3는 이전 세대나 상위 티어 모델 대비 훨씬 경제적이라고 언급되었다.
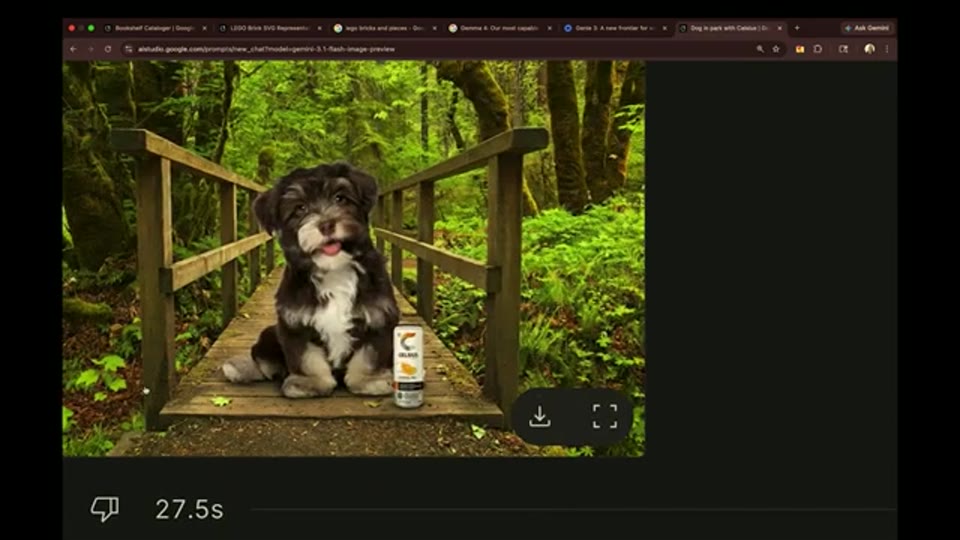
43:12 - Imagen 3 이미지 생성 결과 - 자연 공원에서 Celsius 캔을 들고 있는 강아지 이미지가 이미지 검색 그라운딩을 통해 생성된 화면
Veo 3.1 Light: 오디오를 품은 영상 생성
Veo 3.1 Light는 720p 해상도를 지원하며 16:9 또는 9:16 비율, 4~8초 구간을 선택할 수 있는 동영상 생성 모델이다. 기존 영상 생성 모델들과 가장 뚜렷하게 구별되는 특징은 생성 영상에 오디오가 포함된다는 점이다. API 키를 연결해야 하는 유료 모델이지만, AI Studio 내 설정에서 API 키를 무료로 생성할 수 있다. 데모에서는 먼저 Gemini에게 “골든 스테이트 워리어스(Golden State Warriors) 테마의 비건 농구 푸드트럭 영상을 위한 프롬프트를 만들어달라”는 요청을 보냈다. Gemini가 생성한 프롬프트를 Veo 3.1 Light에 입력하자, Chef Curry를 연상시키는 요리사 캐릭터, 두부 바르바코아(Tofu Barbacoa), 케일, 아보카도, 에다마메가 담긴 푸드트럭 영상이 합성되었다. Bailey는 지인이 실제로 비건 농구 푸드트럭을 꿈꾸고 있다며 이 영상을 보내겠다고 말해 웃음을 유발했다.
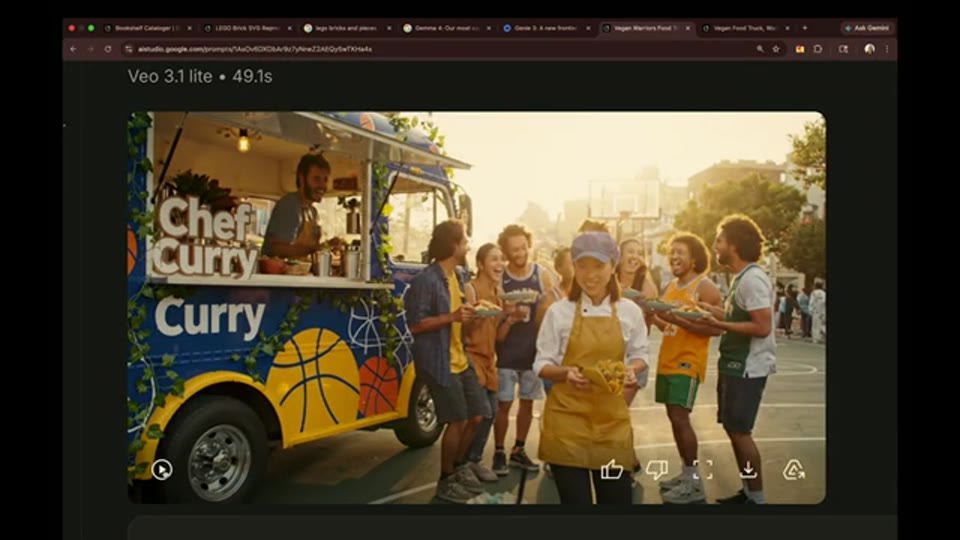
49:43 - Veo 3.1 Light 영상 생성 결과 - 골든 스테이트 워리어스 테마의 비건 농구 푸드트럭 영상이 오디오와 함께 생성된 화면
Lyria 3: 가사까지 생성하는 AI 작곡가
Lyria 3는 Google DeepMind의 음악 생성 모델로, 분위기·장르 설정과 함께 가사도 생성할 수 있다. AI Studio 오디오 섹션에서 Lyria 3 Pro Preview와 Lyria 3 Clip Preview 형태로 접근 가능하다. 강연에서는 Guillaume이 개발한 Lyria Studio 앱을 통해 “Electronic(전자음악), Danceable(댄서블), 비건 농구 푸드트럭, Lego, 스페인어 가사” 설정으로 클립을 생성했고, 실제로 “lego de todos los colores construyendo un mundo de sabores(모든 색의 레고로 맛의 세계를 쌓아가며)“로 시작하는 스페인어 가사가 포함된 전자음악이 합성되었다. 청중에게 뜻을 확인하자 “맞다”는 반응이 나왔으며, 이미 생성한 푸드트럭 영상과 테마송까지 갖춰졌다는 사실에 강연장에서 웃음이 터졌다.
Gemma 4: 오픈 모델 패밀리의 진화
Gemma 4는 Apache 2.0 라이선스 기반의 오픈 모델로, 파라미터 크기 대비 훨씬 높은 성능을 발휘한다고 Bailey가 강조했다. 멀티모달 이해를 지원해 이미지·오디오·영상 분석이 가능하며, AI Studio에서 무료로 API 호출이 가능해 “먼저 써보고 결정하는(try before you buy)” 경험을 제공한다. 가장 작은 버전은 모바일 기기에서도 로컬로 실행이 가능하며, Pixel 10 시리즈에는 Gemma 모델이 기본 탑재될 예정이라고 밝혔다. Chrome 브라우저도 Gemma 모델을 통합하는 방향으로 진행 중이다. GPU 없이도 AI Studio를 통해 무료로 API를 사용할 수 있어 진입 장벽이 낮다는 점이 오픈 모델 생태계를 탐색하는 개발자에게 실질적인 이점이 된다. 강연장에는 Gemma 팀 멤버인 Ian도 참석해 별도의 세션에서 더 자세한 내용을 다루기로 예고되었다.
로보틱스와 AR: Gemini Live의 현실 적용 가능성
Bailey는 Gemini Live의 현실 적용 사례로 “Pupper”라는 오픈소스 로봇을 소개했다. 모든 부품을 3D 프린팅 가능하고 Raspberry Pi로 구동되며 소프트웨어도 오픈소스인 이 로봇은 Gemini 모델을 객체 감지와 환경 반응에 활용한다. Gemini Live를 통해 자연어로 로봇에게 행동 지시를 내릴 수 있는데, 여기서 중요한 아키텍처 원칙이 소개되었다. Gemini Live가 직접 모터를 제어하는 것이 아니라, Gemini가 고수준의 행동 계획(Plan)을 수립하고 로봇에 내장된 로컬 모델들이 실제 세부 동작(특정 물체 집기 등)을 실행하는 방식이다. LLM의 강점인 계획·추론과 로컬 모델의 강점인 실시간 제어·저지연을 결합하는 이 패턴은 실용적인 AI 로보틱스 아키텍처의 현실적인 출발점이 된다. 증강 현실(AR) 영역에서도 Gemini Live는 네비게이션 안내, 화이트보드 수식 설명, 실시간 다국어 자막 변환(예: 중국어 발화 → 영어 자막) 등의 유스케이스에 자연스럽게 적용될 수 있다고 덧붙였다.
마무리 및 핵심 정리
이번 강연의 핵심 메시지는 “빠르게 진화하는 Google의 AI 모델 생태계를 AI Studio라는 단일 플랫폼에서 무료 혹은 낮은 비용으로 탐색하고, Get Code 버튼 하나로 프로토타입을 즉시 프로덕션 코드로 전환할 수 있다”는 것이다. Bailey는 슬라이드 나열 대신 라이브 데모를 통해 각 모델의 실용성을 직접 검증하는 방식을 일관되게 유지했다. Gemini 3.1 Flash Light와 같은 소형 모델이 코드 실행, 그라운딩 등의 도구와 결합했을 때 얼마나 강력한 결과를 낼 수 있는지를 반복적으로 강조한 것도 이 강연의 뚜렷한 특징이었다.
개발자에게 가장 실용적인 출발점으로 강연에서 제시된 방향은 다음과 같다. 먼저 AI Studio에서 직접 실험하며 API 키를 생성하는 것, 다음으로 “Get Code” 버튼을 통해 UI에서 한 작업을 즉시 코드로 전환하는 습관을 들이는 것, 그리고 대형 모델을 기본값으로 쓰기보다 소형 모델(Flash Light, Gemma 4)에서 시작해 도구를 붙여가며 한계를 테스트하는 것이다. 강연 말미에는 동료가 Telegram과 Gemini API를 결합해 Workspace 작업을 자동화하는 사례도 소개되었으며, Open CLI 도구와 Gemini API를 함께 사용하는 패턴도 추천되었다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Build & deploy AI-powered apps — Paige Bailey, Google DeepMind |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-04-30 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. STT 변환 특성상 일부 모델명이 원문과 다를 수 있으며, 특히 “nano banana 2”로 반복 표기된 이미지 생성 모델은 Imagen 계열 모델의 STT 오류 가능성이 높습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- From Transcription to Live Music - Gemini’s Audio Stack — Thor Schaeff, Google DeepMind
- Gemma, DeepMind’s Family of Open Models — Omar Sanseviero, Google DeepMind
- Any-to-Any: Building Native Multimodal Agents - Patrick Löber, Google DeepMind
- 아바타 광고부터 미래 서울까지 | Gemini Playground 체험기
- Sovereign Escape Velocity - Ownership with Open Models - Gus Martins and Ian Ballantyne, Google DeepMind