Building Conversational Agents — Google DeepMind 핸즈온 워크숍
📺 원본 영상: Building Conversational Agents — Thor Schaeff and Philipp Schmid, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-01 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(코드, 터미널 출력, 슬라이드 등)는 음성으로 설명된 범위 내에서만 재구성되었습니다.
개요
이 강연은 AI Engineer 컨퍼런스에서 진행된 핸즈온 워크숍으로, Google DeepMind의 개발자 경험(Developer Experience) 팀 소속인 Thor Schaeff와 Philipp Schmid가 공동으로 진행했다. 두 사람은 각각 Gemini API의 새로운 Interactions API를 활용한 코딩 에이전트 구축(Philipp 담당)과, 실시간 음성 대화를 가능하게 하는 Gemini Live API 활용(Thor 담당)으로 세션을 나누어 진행했다. 워크숍의 핵심 메시지는 하나다. 더 이상 에이전트를 처음부터 수동으로 구현할 필요가 없으며, 잘 설계된 API와 코딩 에이전트 스킬(Skill)을 결합하면 실용적인 AI 에이전트를 빠르게 구축할 수 있다는 것이다.
Gemini Interactions API — generateContent의 다음 세대
새로운 통합 API가 필요했던 이유
Philipp은 세션 초반, 기존의 generateContent API가 가진 한계를 솔직하게 인정했다. 기존 API는 Google 내부의 프로토콜 버퍼(protobuf)와 gRPC 방식에 기반해 설계되었기 때문에, OpenAI의 Chat Completions API나 Anthropic의 Messages API에 익숙한 개발자들에게는 낯선 인터페이스였다. 이를 해결하기 위해 Google DeepMind는 2024년 12월, Interactions API를 베타로 출시했다. 이 API는 일반 LLM 모델 호출과 Deep Research 같은 에이전트 모두를 동일한 인터페이스로 처리하는 것을 목표로 한다.
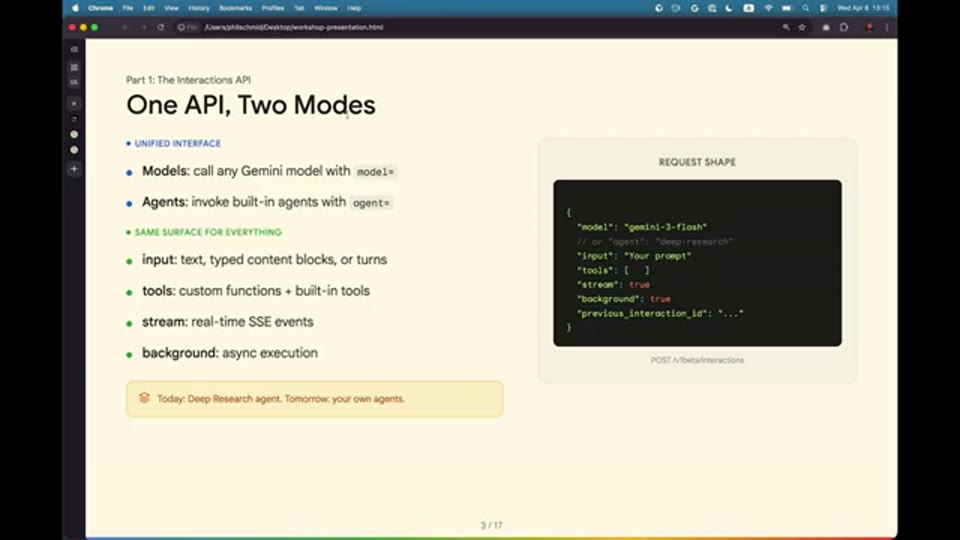
10:11 - Interactions API 개요 슬라이드: generateContent와의 비교, 서버 사이드 상태관리, Deep Research 에이전트, 비동기 실행 등 주요 기능 목록
Philipp에 따르면, Interactions API의 설계는 의도적으로 기존 업계 표준에 가깝게 맞추어졌다. 입력과 출력 모두 동일한 콘텐츠 블록(Content Block) 타입으로 표현되며, 이 타입 필드는 함수 호출(function call), 텍스트(text), 오디오(audio), 이미지(image), 동영상(video) 등을 포괄한다. 강연자는 이 구조가 멀티모달 파이프라인 구성을 크게 단순화한다고 강조했다. 예를 들어, 이미지 생성 모델[Imagen 또는 유사 이미지 생성 모델로 추정, 영상 참조 필요]에 이미지 생성을 요청하고, 그 결과를 Gemini Flash 모델로 넘겨 텍스트 처리를 하고, 다시 Lyria에 보내 오디오를 생성하는 체이닝이 동일한 API 표면 위에서 이루어진다. 동영상 생성 모델 Veo(영상에서는 “Vio”로 발음됨) 지원도 곧 추가될 예정이라고 언급했다.
서버 사이드 상태 관리 — 컨텍스트 관리의 혁신
Interactions API의 가장 실질적인 변화 중 하나는 **서버 사이드 상태 관리(Server-side State Management)**다. 기존 방식에서는 개발자가 매 요청마다 전체 대화 히스토리를 클라이언트에서 관리하며 다시 전송해야 했다. 이는 멀티턴 에이전트 루프에서 상당한 코드 복잡도를 유발했다. Interactions API는 이를 해결하기 위해 previous_interaction_id 파라미터를 도입했다. 이 ID를 이전 요청의 응답 ID로 설정하면, 서버가 자동으로 이전 대화 히스토리에 새 입력을 이어붙여 처리한다. 개발자는 새 사용자 입력만 보내면 된다.
Philipp은 이 구조가 단순한 편의성 이상의 의미를 가진다고 설명했다. 상태를 클라이언트가 직접 관리하면, 사소한 실수 — 예를 들어 공백 하나를 제거하거나 줄 바꿈을 수정하는 것 — 만으로도 **암묵적 캐싱(Implicit Caching)**이 깨진다. 캐시된 입력 토큰은 처리 비용이 약 90% 절감되는데, 히스토리 관리를 서버에 위임하면 이 캐시 적중률이 안정적으로 높아진다. 실제로 Interactions API를 조기 채택한 스타트업들에서는 캐시 적중률이 2~3배 향상되었다고 강연자는 밝혔다. 무료 티어에서는 인터랙션 히스토리가 1일간 보존되고, 유료 API 키에서는 55일간 보존된다.
서버 사이드 상태는 분기(branching)도 지원한다. 모든 인터랙션 ID는 스택처럼 쌓이기 때문에, 클라이언트가 특정 시점의 ID를 보관하고 있다면 나중에 그 시점으로 되돌아가 새로운 대화 흐름을 분기할 수 있다. 또한 interactions.get() 메서드로 과거 특정 인터랙션의 전체 컨텍스트를 조회할 수도 있다.
Deep Research와 비동기 실행
Interactions API는 단순 모델 호출을 넘어 Deep Research 에이전트도 동일한 인터페이스로 지원한다. Deep Research는 수백 개의 웹 사이트를 탐색하며 10~15분에 걸쳐 심층 리서치를 수행하는 에이전트다. 이처럼 오래 실행되는 작업에는 HTTP 연결을 수분 이상 열어두는 것이 적절하지 않기 때문에, Interactions API는 **백그라운드 실행(Background Execution)**을 지원한다. 요청을 시작한 뒤 폴링(polling)하거나 웹훅(webhook)으로 완료 알림을 받을 수 있다.
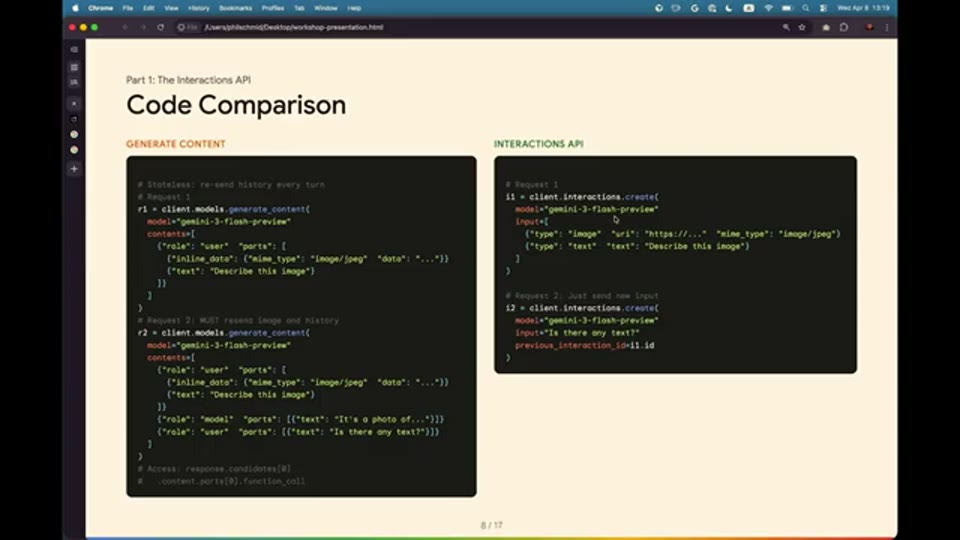
14:11 - 기존 generateContent의 proto 스타일 입력과 Interactions API의 단순화된 코드 형태 나란히 비교
💡 [영상 참조] Philipp은 이 시점에서 코드 예시 슬라이드를 화면에 띄워
generateContentAPI와 Interactions API의 코드 형태를 나란히 비교했다. 상세 내용은 원본 영상을 확인하세요.
코딩 에이전트 실습 구축 — Gemini Interactions API 핸즈온
코딩 에이전트 스킬(Skill)을 활용한 워크플로우
Philipp은 이번 워크숍에서 코드를 직접 수동으로 작성하는 대신, 개발자용 IDE 에이전트(Cursor, Windsurf 계열의 “Antigravity”, Gemini CLI 등)에 코딩 에이전트 스킬을 설치하여 활용하는 방식을 택했다. 스킬이란 에이전트에게 특정 도메인 지식을 제공하는 일종의 컨텍스트 파일로, Gemini API 문서 페이지에서 npx 명령어로 설치할 수 있다. 설치 결과는 워크스페이스의 .agents/skills/ 디렉터리에 위치한다.
이 접근법의 핵심 아이디어는 스킬 파일 안에 모든 API 문서를 직접 포함하는 대신, 문서 URL에 대한 참조를 넣어두는 것이다. 에이전트는 웹 페치(Web Fetch) 기능으로 필요할 때마다 최신 문서를 직접 조회한다. 덕분에 새로운 기능이 API에 추가되더라도 스킬 파일 자체를 업데이트할 필요가 없다. Philipp은 “Gemini Flash 모델이 Interactions API를 처음부터 알고 있을 수 없다. 이 API는 모델의 학습 데이터 컷오프 이후에 출시되었기 때문이다. 스킬과 코딩 인프라가 없었다면 오늘의 실습은 불가능했을 것이다”라고 강조했다.
스킬에는 현재 사용 가능한 Gemini 모델 목록이 명시되어 있다. 스킬이 없으면 에이전트가 gemini-1.5-pro처럼 구식 모델을 기본값으로 사용하는 경우가 많지만, 스킬 덕분에 gemini-2.5-flash(영상에서는 “Gemini free flash”로 발음됨) 같은 최신 모델을 올바르게 선택할 수 있었다.
에이전트 클래스 구축 — 기초 단계
첫 번째 실습 과제는 에이전트 클래스를 구축하는 것이었다. 강연자가 에이전트(Antigravity 또는 유사 도구)에게 전달한 지시는 다음과 같은 구조였다. 생성자(constructor)에서 google.genai 클라이언트를 초기화하고, 모델 ID와 previous_interaction_id를 전역 상태로 정의한다. 그리고 run() 메서드에서 interactions.create() 호출을 통해 실제 API 요청을 보내고, 응답으로 받은 새 인터랙션 ID를 상태로 업데이트한 뒤 텍스트를 반환한다. 마지막으로 멀티턴 동작을 검증하는 main() 예제도 포함한다.
에이전트가 스킬을 제대로 읽어들인 결과, 모델 ID 기본값이 최신 모델로 올바르게 설정되었다. 멀티턴 대화 검증을 위해 “My name is Phil”을 첫 번째 턴으로 보내고 “What is my name?”을 두 번째 턴으로 보냈더니, 서버 사이드 상태 덕분에 모델이 이전 컨텍스트를 유지하며 “Your name is Philip”이라고 정확히 응답했다.
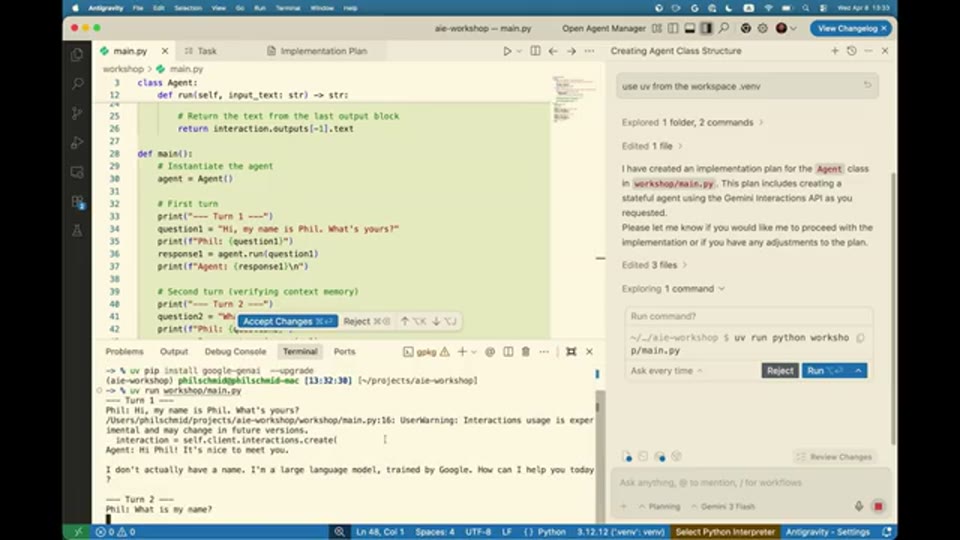
28:10 - 기본 에이전트 클래스 실행 결과: 멀티턴 대화 검증, ‘Your name is Philip’ 응답 확인
파일 읽기/쓰기 도구 추가 — 도구 호출 루프 구현
두 번째 단계는 코딩 에이전트의 핵심인 파일 읽기(read_file)와 파일 쓰기(write_file) 도구를 추가하는 것이었다. Interactions API에서 도구 호출은 JSON 스키마 정의와 실제 Python 구현 함수, 이 두 가지가 필요하다. 스키마는 모델에게 “어떤 파라미터로 어떤 함수를 호출해야 하는가”를 알려주고, Python 함수는 클라이언트 측에서 실제 파일 시스템 작업을 수행한다.
도구 호출 루프의 동작 방식은 다음과 같다. API 응답의 status가 requires_action이면 클라이언트가 뭔가를 해야 한다는 신호다. 응답에 포함된 출력 타입들을 순회하며 함수 호출(function call) 타입을 찾고, 해당 함수를 실행한 뒤 그 결과를 function_result 타입으로 다음 인터랙션에 포함시킨다. 모델이 더 이상 도구를 호출하지 않고 텍스트를 생성할 때까지 이 루프가 재귀적으로 반복된다. Philipp은 Gemini가 추론 모델이기 때문에 응답에 thought와 thought_signature가 포함되며, 서버 사이드 상태를 사용할 때는 이것들도 다음 요청에 포함시켜야 한다고 설명했다.
시스템 인스트럭션과 bash 도구 — 완성된 미니 에이전트
대화형 루프를 추가하고 실제 입력을 시도했을 때, 모델이 파일 쓰기 도구를 적극적으로 사용하지 않는 문제가 발생했다. 원인은 시스템 인스트럭션(System Instruction)이 없었기 때문이었다. 에이전트에게 “당신은 소프트웨어 엔지니어이며, 로컬 파일 시스템에 접근할 수 있는 도구를 갖고 있다”는 페르소나를 부여하자 모델은 즉시 파일 쓰기 도구를 올바르게 활용하기 시작했다.
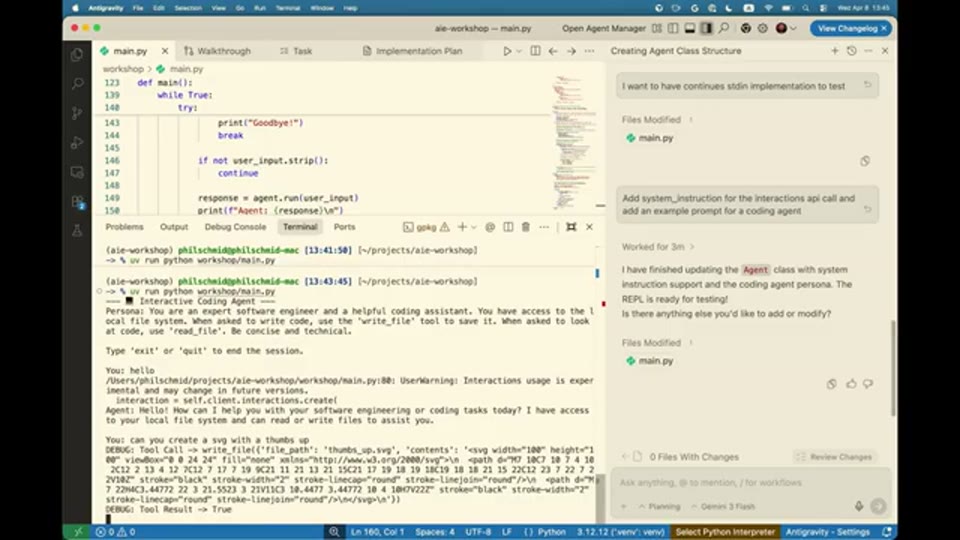
40:18 - 시스템 인스트럭션 추가 후 파일 쓰기 도구 호출 확인, 엄지손가락 SVG 아이콘 생성
마지막으로 bash 명령어 실행(run_command) 도구를 추가했다. subprocess 모듈을 활용한 간단한 구현으로, 에이전트가 쉘 명령을 실행하고 stdout 출력을 결과로 받을 수 있게 했다. 시스템 프롬프트도 코딩 에이전트의 역할과 사용 가능한 도구들을 명시하도록 업데이트되었다. 완성된 에이전트는 “Get the time” 같은 요청에 run_command date 도구를 호출하여 “Wednesday April 8” 같은 결과를 반환할 수 있는, 사실상 경량화된 Claude Code에 해당하는 구조를 갖추게 되었다.
Gemini Live API — 실시간 음성 대화 에이전트
Gemini 2.5 Flash Live — 새로운 네이티브 오디오 모델
Thor가 이어받은 두 번째 세션은 Gemini Live API를 중심으로 구성되었다. 워크숍 시점 기준으로 약 2주 전에 출시된 Gemini 2.5 Flash Live(영상에서는 “gemini 3.1 flesh life”로 발음됨)가 주인공이다. 이전 네이티브 오디오 모델은 2024년 12월 출시 이후 약 4개월 만의 업데이트로, 이번 버전에서는 기반 아키텍처를 대폭 재설계하여 지연 시간 단축과 확장성 향상에 집중했다고 Thor는 설명했다.
이 모델의 가장 중요한 특징은 **네이티브 오디오 모델(Native Audio Model)**이라는 점이다. 기존의 음성 AI 파이프라인은 세 단계로 이루어진 캐스케이딩 구조다. 음성을 텍스트로 변환(STT)하고, 그 텍스트를 LLM이 처리하고, 결과 텍스트를 다시 음성으로 합성(TTS)한다. 이 구조는 각 단계마다 지연이 누적되고, TTS 특유의 부자연스러운 운율이 생기며, 풍부한 오디오 맥락(억양, 감정, 언어 혼합 등)이 중간에 유실된다. 반면 Gemini 2.5 Flash Live는 사운드 토큰에서 사운드 토큰으로 직접 처리하므로, 모델이 오디오를 “듣고” 오디오로 “말한다”. 덕분에 97개 언어를 프리뷰 수준에서 지원하며, “Denglish”처럼 독일어와 영어가 혼합된 발화도 자연스럽게 이해하고 응답할 수 있다고 Thor는 설명했다.
Live API의 기술 구조 — WebSocket 기반 양방향 스트리밍
Gemini Live API는 **상태가 있는 WebSocket API(Stateful WebSocket API)**다. 클라이언트는 실시간 텍스트, 오디오, 영상 피드를 모델로 스트리밍할 수 있다. 오디오는 버퍼 청크 단위로 전송되고, 영상은 초당 최대 1프레임으로 스트리밍된다. 이 영상 피드는 카메라가 될 수도 있고, 화면 공유가 될 수도 있다. Shopify가 ‘Shopify Sidekick’에서 이 API를 활용하는 방식이 이에 해당한다. 사용자가 Shopify 관리 화면을 공유하면 에이전트가 화면을 보며 커스텀 도메인 설정 방법을 음성으로 안내해주는 것이다.
모델의 응답은 실시간 이벤트 형태로 WebSocket을 통해 돌아온다. 오디오 버퍼와 함께 오디오 텍스트 전사본(Audio Transcription)도 이벤트로 제공되므로, 개발자가 음성과 텍스트 모두 활용할 수 있다. Google Search 그라운딩(Grounding)이 기본 내장되어 있어, 실시간 날씨나 최신 뉴스 같은 정보도 조회 가능하다. 또한 함수 호출(Tool Calling)이 지원되며, 이번 버전에서 도구 사용과 명령 수행 능력이 이전 모델 대비 크게 개선되었다고 Thor는 강조했다.
두 가지 아키텍처 패턴 — 서버 프록시 vs. 임시 토큰
Thor는 실습 과정에서 Live API를 애플리케이션에 통합하는 두 가지 아키텍처 패턴을 직접 보여주었다.
첫 번째는 서버 투 서버(Server-to-Server) 프록시 패턴이다. FastAPI 서버를 중간에 두고, 브라우저 클라이언트는 이 서버에 WebSocket 연결을 맺는다. 서버가 클라이언트의 오디오/영상 신호를 받아 Gemini Live API로 프록시하는 구조다. 이 방식의 장점은 API 키가 서버에만 존재하므로 보안이 확보된다는 것이다. 단점은 클라이언트와 서버, 서버와 Gemini 사이의 두 홉(hop) 구조로 인해 지연 시간이 증가한다는 점이다.
두 번째는 임시 토큰(Ephemeral Token) 패턴이다. 서버는 API 키를 사용해 단명하는 임시 토큰을 생성하고 이를 클라이언트에게 전달한다. 클라이언트(브라우저)는 이 토큰으로 Gemini Live API에 직접 WebSocket 연결을 맺는다. 프록시를 거치지 않으므로 지연 시간이 훨씬 짧다. 임시 토큰은 만료 시간이 설정되어 있어, 설령 토큰이 유출되더라도 피해가 제한된다. 다만 이 패턴은 현재 v1alpha API를 사용해야 하는 제약이 있다.
음성 에이전트 커스터마이징 — 시스템 인스트럭션의 힘
Live API는 현재 약 30가지 기본 음성(Base Voice)을 제공한다. 다소 제한적으로 보일 수 있지만, 시스템 인스트럭션을 통해 음성의 특성을 상당히 세밀하게 조정할 수 있다. Thor는 “speak in a friendly Irish accent”라는 시스템 인스트럭션만으로 기본 음성이 아일랜드 억양을 띤 친근한 톤으로 변환되는 것을 직접 시연했다. Gemini의 깊은 오디오 이해 능력이 이를 가능하게 한다.
워크숍의 하이라이트 중 하나는 Live Jukebox DJ 데모였다. Lyria 3 음악 생성 모델과 Live API를 결합해, 라디오 사연 신청 DJ처럼 대화하며 즉석에서 음악을 생성하는 애플리케이션이었다. 청중의 요청으로 “영국 AI 씬에 대한 독일 테크노 슐라거(Techno Schlager) 스타일의 곡”과 “스와힐리어로 된 간호사 노래”가 실시간으로 생성되었다.
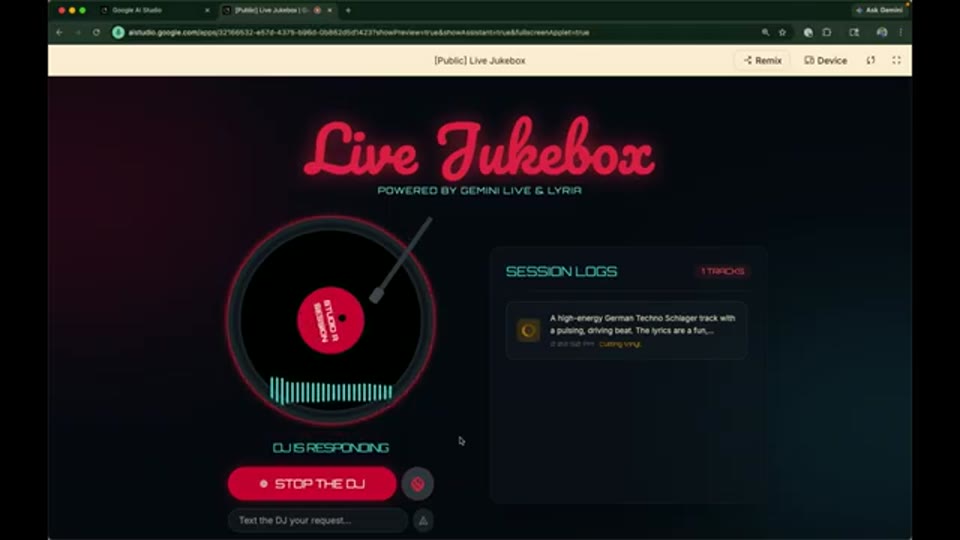
51:45 - Live Jukebox DJ 데모: 영국 AI 씬에 관한 독일 테크노 슐라거 곡 실시간 생성 중
이 애플리케이션은 Google AI Studio에서 바이브 코딩으로 제작되었으며, AI Studio에 공개되어 있다.
세션 관리와 컨텍스트 윈도우 압축
Live API 세션에는 컨텍스트 윈도우 제한이 있다. 오디오만 사용하는 세션은 최대 15분, 오디오와 영상을 함께 사용하는 세션은 최대 2분으로 제한된다. 이 제한을 극복하기 위해 **컨텍스트 윈도우 압축(Context Window Compression)**을 활성화할 수 있다. 이는 슬라이딩 윈도우 방식으로, 설정한 윈도우 크기 이전의 대화 컨텍스트를 점진적으로 잊어가며 세션을 더 길게 유지한다. 이미지 프레임이 많을수록 토큰 소비가 빠르기 때문에, 영상 입력이 있는 세션일수록 윈도우가 빠르게 소진된다는 점을 감안해야 한다.
세션 중 발생한 오디오나 전사 텍스트는 현재 API 자체에서는 저장하지 않는다. 이 기능을 필요로 하는 경우에는 LiveKit, Pipecat 같은 파트너 통합 솔루션을 활용하도록 권장되었다.
비즈니스 적용 현황과 현실적 고려사항
Thor는 실시간 음성 에이전트의 실제 비즈니스 적용 사례와 그 한계에 대해서도 솔직하게 이야기했다. Shopify Sidekick 외에도 Waymo(자율주행 차량 내 음성 인터랙션), 패션 디자인 도구 Stitch, 아르헨티나 스타트업 HeyAdo(노인을 위한 음성 동반자 서비스, 스페인어 다국어 지원) 등 다양한 사례가 언급되었다.
그러나 Thor는 현재 기술의 한계도 명확히 짚었다. 네이티브 오디오 모델은 각 파이프라인 단계에 대한 관찰 가능성(Observability)이 제한적이다. 전통적인 캐스케이딩 파이프라인은 STT 출력, LLM 응답, TTS 입력이 텍스트로 모두 기록되므로 디버깅과 품질 관리가 용이하다. 하지만 네이티브 오디오 모델은 각 단계의 중간 산출물이 노출되지 않기 때문에, 음성 응답이 나오기 직전에 텍스트를 수정하거나 필터링하는 것이 어렵다. 또한 SOC 2, HIPAA 같은 규정 준수 요건이 있는 경우에는 추가적인 파트너 통합이 필요하다. Google Search 그라운딩도 이번 데모에서 의도한 대로 동작하지 않는 문제가 발생했는데, Thor는 이를 솔직히 인정하며 “오늘 고쳐야 할 것들을 많이 발견했다”고 언급했다.
마무리 — 에이전트 개발의 실용주의
이번 워크숍이 전달하는 메시지는 기술적 완성도에 관한 것만이 아니다. Philipp과 Thor는 각각의 세션을 통해 AI 에이전트 개발의 새로운 현실주의적 접근을 보여주었다. 코딩 에이전트를 활용해 코드를 반자동으로 생성하고, 스킬 파일로 도메인 지식을 주입하며, 서버 사이드 상태 관리로 컨텍스트 공학의 복잡성을 줄이는 것. 이 모든 것이 현재 프로덕션 레벨에서 활용 가능한 도구들이다.
실시간 음성 에이전트 영역에서는 아직 해결해야 할 것들이 남아 있다. Google Search 그라운딩의 안정성, WebRTC 직접 지원(현재 LiveKit, Pipecat 같은 파트너에 의존), 세션 오디오 스토리지, 화자 구분 능력 등이 개선을 기다리는 영역들이다. 그럼에도 불구하고, 97개 언어를 넘나들며 실시간으로 음악을 생성하고 화면을 보며 대화하는 에이전트의 실제 시연은, 향후 인터랙션 패러다임이 어디를 향하고 있는지를 분명하게 가리키고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Building Conversational Agents — Thor Schaeff and Philipp Schmid, Google DeepMind |
| 채널 | AI Engineer |
| 발표자 | Thor Schaeff, Philipp Schmid (Google DeepMind Developer Experience 팀) |
| 리포트 작성 | 2026-05-01 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.