Connecting the Dots with Context Graphs
📺 원본 영상: Connecting the Dots with Context Graphs — Stephen Chin, Neo4j 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-17 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 Neo4j에서 Developer Relations 팀을 이끄는 Stephen Chin이 ‘AI Engineer’ 컨퍼런스에서 발표한 내용으로, LLM(대형 언어 모델)의 한계를 지식 그래프(Knowledge Graph)로 어떻게 보완할 수 있는지를 다룬다. 강연은 현재 엔지니어들이 처한 분절된 데이터 환경의 문제를 진단하는 것에서 출발해, 메모리 아키텍처 설계 원칙, 실제 오픈소스 데모 두 가지(팟캐스트 지식 그래프, 금융 서비스 대출 심사)를 순차적으로 제시한다. 궁극적으로 컨텍스트 그래프(Context Graph)가 기업 내 의사결정의 근거와 추적 가능성을 어떻게 확보해주는지를 설명하는 것이 핵심이다.
AI 혁명의 역설: 도구가 우리를 통제한다
강연자는 도입부에서 현재 AI 혁명 시대를 살아가는 엔지니어들의 아이러니한 상황을 묘사한다. 우리는 코파일럿, 에이전트 기반 코드 리뷰어 등 강력한 AI 도구를 손에 쥐고 있지만, 정작 그 도구에 의해 심사받고 통제당하는 처지가 되었다는 것이다. PR(Pull Request)을 올리면 에이전트가 먼저 검토하고, 우리의 작업물은 AI의 판단을 거쳐야 한다. 강연자는 이 상태를 “도구를 사용하는 게 아니라, 도구에 사용당하는 상태”라고 규정한다.
이 문제의 근원은 데이터의 사일로화(siloing)에 있다. 기업 내 수많은 지식과 의사결정 근거는 Slack 대화, 고객 지원 티켓, 각종 엔터프라이즈 시스템에 분산되어 있고, 상호 연결되지 않은 채 잠들어 있다. 이 환경에서 AI 에이전트에게 중요한 비즈니스 결정을 맡기면, 에이전트는 단편적인 정보만으로 판단하게 되어 신뢰할 수 없는 결과를 낳는다. 강연자는 이를 영화 《매트릭스》의 비유를 빌려 표현한다. 파란 약을 선택하면 이 분절된 지식의 미로 속에 계속 갇혀 있고, 빨간 약을 선택하면 모든 시스템을 연결하고 추론 근거를 축적해 매트릭스에서 탈출할 수 있다. Gartner는 이미 컨텍스트 그래프를 AI 하이프 사이클(Hype Cycle)에 공식 포함시켰고, Foundation Capital도 이 기술이 가져올 기회 규모를 3조 달러로 추산한 포스트를 발표하며 업계의 주목이 집중되고 있다.
지식 그래프의 구조: 관계가 1등 시민인 세계
본론에 앞서 강연자는 지식 그래프(Knowledge Graph)의 기초 구조를 설명한다. 그래프는 노드(Node)와 관계(Relationship)로 구성된다. 노드는 사람, 사물, 기업 등 개체를 표현하고, 관계는 그 개체들 사이의 연결을 나타낸다. 예를 들어 “Dan은 Ann과 함께 살고, Ann의 차를 운전한다”는 정보는 자연스럽게 노드와 엣지(edge)로 표현된다. 여기에 차(Car) 노드 위에 벡터 임베딩(embedding)을 추가하면, 유사도 검색(similarity search)도 함께 수행할 수 있다.
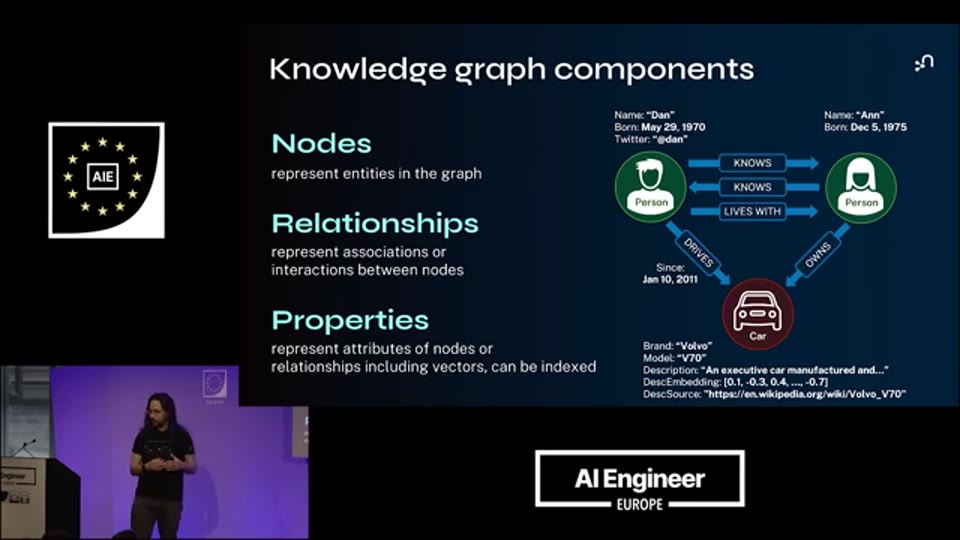
03:29 - 지식 그래프의 기본 구조 설명 - 노드(사람/사물), 관계(edges), 속성(properties), 그리고 차량 노드 위의 벡터 임베딩을 보여주는 시각 자료
이 구조가 중요한 이유는 관계 자체가 데이터의 1등 시민이기 때문이다. 관계형 데이터베이스(RDBMS)에서는 여러 테이블을 JOIN해야만 관계를 표현할 수 있지만, 그래프 데이터베이스에서는 관계가 구조 그 자체다. 강연자는 이것이 인간이 화이트보드에 무언가를 그릴 때 자연스럽게 선택하는 방식과 동일하다고 설명한다. 그래프는 우리가 세상을 개념화하는 방식을 그대로 데이터 모델로 옮긴 것이다.
LLM + 지식 그래프: 두 강점의 융합
강연자는 LLM과 지식 그래프가 서로 다른 강점을 가지고 있으며, 이 둘을 결합할 때 진정한 시너지가 발생한다고 주장한다. LLM이 뛰어난 영역은 자연어 이해, 추론, 그리고 창의성이다. 반면 지식 그래프가 강점을 가지는 영역은 지식의 구조화, 맥락(context) 보존, 그리고 데이터 보강(enrichment)이다.
이 두 가지를 결합하면 그래프 내에 저장된 관계 데이터를 기반으로 숨겨진 패턴을 발견하고, 시각화를 통해 중요한 데이터에 즉시 접근하며, AI의 분석이 의미 있는 인사이트로 이어지는 파이프라인을 구성할 수 있다. 이것이 강연자가 소개할 컨텍스트 그래프 데모들의 기반이 되는 아이디어다.
Graph RAG: 의료 사례로 보는 검색의 세 단계
강연자는 그래프 기반 검색이 왜 기존 RAG(Retrieval-Augmented Generation)보다 우월한지를 의료 사례를 통해 설명한다. 질문은 “Andrea Genkis 환자의 폐기종(emphysema) 치료 계획은 무엇인가?”였다.
첫 번째 단계는 순수 LLM이다. LLM은 폐기종 자체에 대한 일반적인 지식은 풍부하지만, 특정 환자에 대한 정보가 없으므로 “폐 손상을 예방하라” 수준의 일반적인 답변을 내놓는다. 두 번째 단계는 벡터 데이터베이스를 활용한 기존 RAG다. 환자 정보가 벡터 DB에 있어 일부 맥락을 가져오지만, 유사도 검색(similarity search)의 특성상 전체 기록이 아닌 관련성 높아 보이는 단편만을 가져온다. 그 결과 “호흡 치료, 깊은 호흡 운동” 등 여전히 다소 일반적인 조언이 나온다.
세 번째 단계가 바로 그래프 RAG다. 지식 그래프에서 환자의 이전 진단, 수술 이력, 흡연 여부 등 배경 정보가 완전히 연결된 상태로 검색된다. 그 결과 AI는 “금연 상담, 폐 재활 운동 프로그램, 약물 관리”라는 해당 환자의 이력에 특화된 권고안을 제시한다. 강연자는 이것이 유사도 검색에서는 소실될 수 있는 배경 정보, 즉 환자가 흡연 이력이 있고 수술을 받은 적이 있다는 사실이 그래프의 연결 구조를 통해 완전하게 전달되기 때문에 가능하다고 설명한다. 이 정보들이 메모리 구조 안에 올바르게 적재되면, AI는 매트릭스의 Neo처럼 필요한 모든 능력을 발휘할 수 있다.
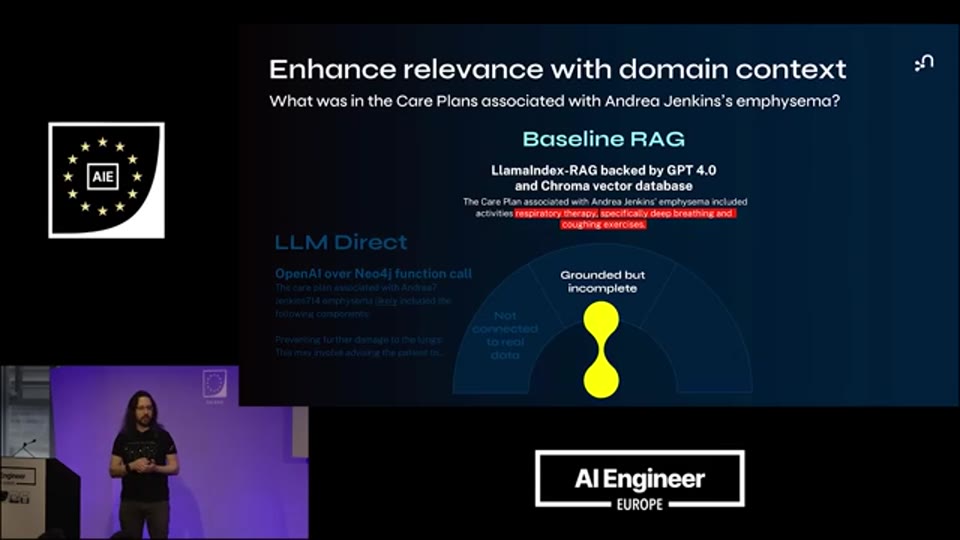
05:21 - 의료 케이스 Graph RAG 비교 슬라이드 - 기본 LLM 응답 / 벡터 RAG 응답 / 그래프 RAG 응답 세 가지를 나란히 비교하는 화면
메모리 아키텍처: 단기·장기·추론의 3계층
맥락을 완전히 보존하는 AI 시스템을 구축하려면 메모리를 체계적으로 설계해야 한다. 강연자는 이를 세 가지 계층으로 구분한다.
**단기 메모리(Short-term Memory)**는 현재 에이전트 파이프라인에서 진행 중인 내용이다. 현재 대화 상태, 에이전트 아키텍처가 작동 중인 활동의 현재 상태가 여기에 해당하며, 이를 지식 그래프에 지속적으로 저장하면 실행 파이프라인에 중요한 정보를 공급할 수 있다.
**장기 메모리(Long-term Memory)**는 데이터의 양이 방대하기 때문에 잘 조직화된 도메인 모델이 필수적이다. 비즈니스 프로세스, 주요 엔티티, 사용자나 고객 정보를 잘 구조화된 형태로 그래프에 표현해야 한다. 이를 통해 에이전트가 오랜 기간에 걸친 작업이나 여러 사용자 인터랙션을 아우르는 이력과 맥락을 보존하며 활동할 수 있다.
**추론 메모리(Reasoning Memory)**는 의사결정의 이유를 기록하는 계층으로, 강연자가 특히 강조하는 부분이다. 통상 LLM은 결과만 알려준다. 그러나 그 결과에 도달하기까지의 사고 과정, 중간 추론 단계들도 의미 있는 정보다. 이를 지식 그래프에 저장하면 두 가지 이점이 생긴다. 첫째, 이전 결정에서 학습하여 더 나은 미래 결정을 내릴 수 있다(의사결정 출처, 즉 decision provenance 확보). 둘째, 컴플라이언스 감사와 디버깅에 강력한 근거 자료가 된다.
Neo4j Agent Memory 패키지: 오픈소스 구현체
강연자는 이 세 가지 메모리 개념을 하나의 컨텍스트 그래프 구조로 통합한 오픈소스 패키지인 Neo4j Agent Memory를 소개한다. 이 패키지는 Neo4j 위에 구축되었으며 공개 GitHub 리포지토리를 통해 누구나 기여할 수 있다.
그래프가 메모리 저장소로 특히 적합한 이유를 강연자는 몇 가지로 정리한다. 관계가 구조의 1등 시민이기 때문에 별도의 JOIN 없이 자연스러운 다단계 순회(multihop traversal)가 가능하다. 다수의 GraphRAG 연구 논문들이 이 다단계 순회 성능을 GraphRAG 아키텍처의 핵심 장점으로 꼽는다. 또한 FastRP(Fast Random Projection)와 같은 그래프 임베딩 기법으로 벡터 룩업을 수행하고, 루뱅 알고리즘(Louvain algorithm)으로 커뮤니티를 그룹화하면 시작점을 잡고 그래프를 효율적으로 탐색할 수 있다. 그 결과 설명 가능한 의사결정(explainable decisions)과 폭넓은 교차 지식(cross-knowledge)을 ACID 트랜잭션 보장 위에서 제공한다.
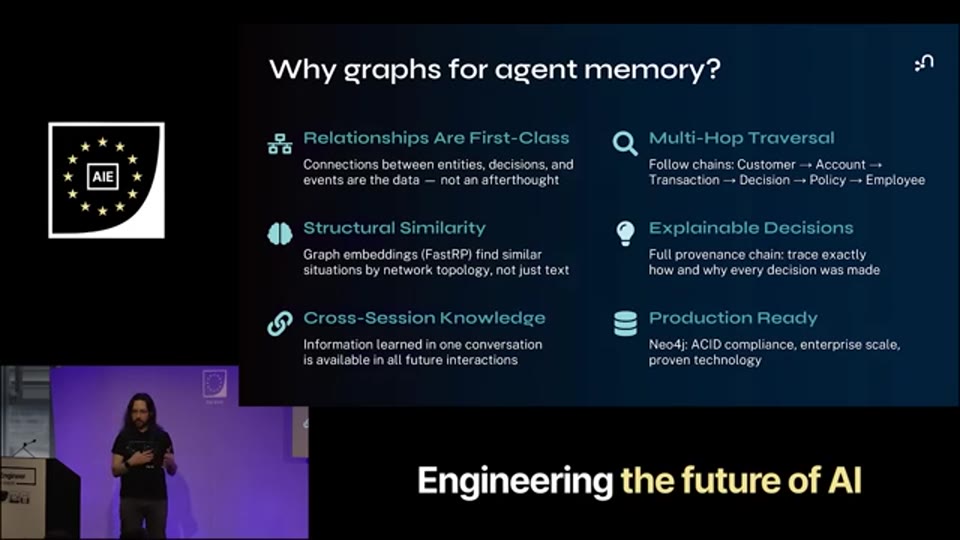
09:17 - 그래프가 메모리에 적합한 이유 설명 슬라이드 - FastRP 임베딩, 루뱅 알고리즘, 다단계 순회 성능 등의 그래프 특성 정리
실전 데모 1: Lenny’s Podcast 지식 그래프
첫 번째 데모는 Lenny’s Podcast 에피소드들을 기반으로 구축한 지식 그래프다. Lenny’s Podcast는 AI, 제품 관리 등 밀도 높은 주제를 다루는 팟캐스트로 청중 사이에서 인기가 높지만, 그만큼 정보가 방대하고 에피소드 간 연결된 맥락을 추적하기 어렵다는 단점이 있다.
이 오픈소스 프로젝트(‘Lenny Memory Podcast’)는 Neo4j Agent Memory API 위에 구축되어 있으며, 모든 에피소드 내용이 지식 그래프로 적재되어 있다. 에이전트는 메모리에 접근하는 다양한 도구(tool)를 제공받고, 예를 들어 에피소드들에서 언급된 위치 정보를 추출해 지도 위에 시각화하는 작업을 수행한다.
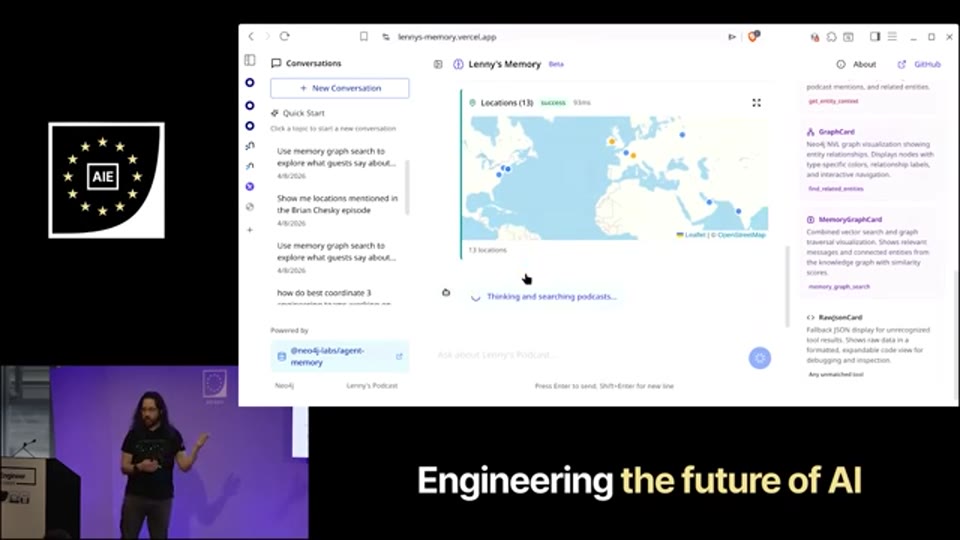
11:10 - Lenny’s Podcast 데모 화면 - 에피소드에서 추출된 위치 정보들이 지도 위에 시각화된 결과
여기서 강조할 점은 벡터 유사도 검색이 아닌 그래프 기반 검색의 장점이다. 유사도 검색은 특성상 데이터셋의 일부만 반환하지만, 그래프에서는 전체 데이터를 동적으로 쿼리하고 순회할 수 있다. 즉 “유사한 것들의 샘플”이 아니라 “해당 조건에 맞는 전체”를 얻을 수 있다.
컨텍스트 그래프의 핵심 아키텍처
이제 강연의 핵심 개념인 컨텍스트 그래프(Context Graph)의 아키텍처를 살펴볼 차례다. 컨텍스트 그래프는 단순한 감사 로그(audit log)와 달리, 의사결정의 이유를 기록한다. 모델 평가 중 발생하는 결정 추적(decision trace)을 포착하고, 이를 엔티티와 관계로 조직화하며, 다양한 소스로부터 지식을 통합한다.
실제 아키텍처는 다음 흐름으로 동작한다. 에이전트 아키텍처의 컨텍스트 그래프 검색 도구들이 지식 그래프, 벡터 검색, 데이터 사이언스 알고리즘을 조합해 검색을 수행하고, 에이전트 루프를 거치며 그 결과를 다시 컨텍스트 메모리에 저장한다. 이 저장된 정보는 그래프로 누적되고, 이후 쿼리들이 이 추론 흔적(reasoning traces)을 다시 활용해 더 나은 답변을 만들어낸다. 이전에 Slack 메시지나 이메일 속에 숨어 있던 과거 결정들이 이제 앱의 중심 저장소에서 조회 가능한 형태로 보존된다.
💡 [영상 참조] 강연자는 이 시점에서 컨텍스트 그래프의 전체 아키텍처 다이어그램을 화면에 보여줍니다. 📺 원본 영상에서 확인하세요.
실전 데모 2: 금융 서비스 대출 심사 시스템
두 번째 데모는 금융 서비스 대출 심사 시스템으로, 컨텍스트 그래프의 실용적 가치가 가장 잘 드러나는 사례다.
시스템 구성을 보면, 데이터 모델은 다음 세 계층으로 이루어진다. 먼저 엔티티 계층으로 인물과 조직이 노드로 표현된다. 다음으로 이벤트 계층으로 워크플로우 중 발생한 결정, 거래, 승인이 기록된다. 마지막으로 컨텍스트 계층으로 어떤 정책이 적용되었는지, 어떤 리스크 요인이 있었는지, 담당자가 특정 권고를 내린 이유가 무엇인지가 저장된다.
기술 스택을 보면, 지원 티켓 시스템, CRM, 내부 비즈니스 데이터 시스템 등 여러 외부 소스로부터 10가지 MCP(Model Context Protocol) 도구를 통해 데이터를 가져온다. Claude 에이전트가 OpenAI 임베딩을 생성해 Neo4j 컨텍스트 그래프를 구성하며, 이로써 도메인 그래프(domain graph)와 추론 그래프(reasoning graph)가 완성된다. 프론트엔드는 Next.js 애플리케이션으로 구성된다.
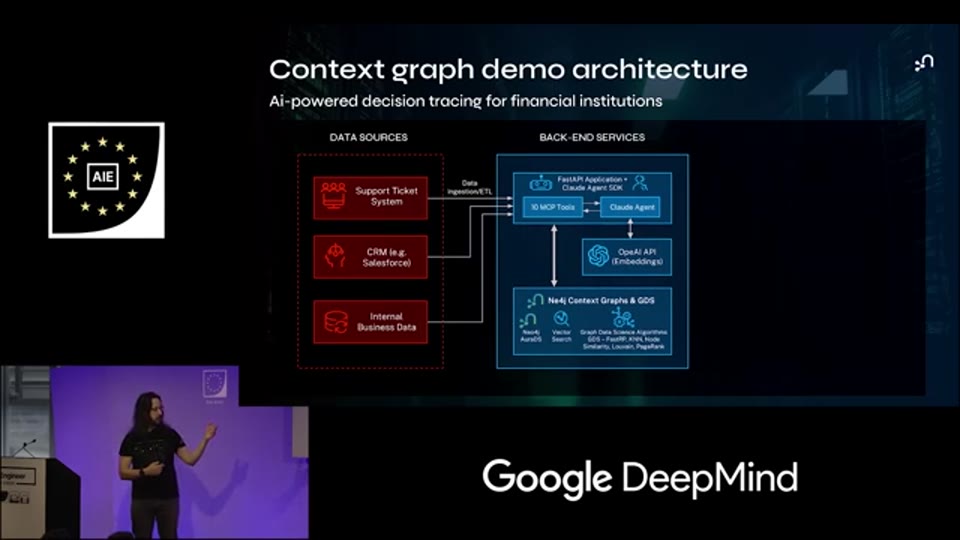
13:44 - 금융 서비스 데모 전체 아키텍처 다이어그램 - 데이터 소스(CRM, 지원 티켓, 내부 시스템), MCP 도구 10개, Claude 에이전트, Neo4j 컨텍스트 그래프, Next.js 프론트엔드 구성
데모 시나리오에서 시스템은 ‘Jessica Norris’라는 고객의 대출 승인 여부를 판단하는 질문을 받는다. 에이전트는 Neo4j 지식 그래프를 순회하며 Cypher 쿼리를 실행해 그녀의 은행 계좌 정보, 관련 마진 거래 이력, 그리고 이전 대출 거절 기록을 찾아낸다.
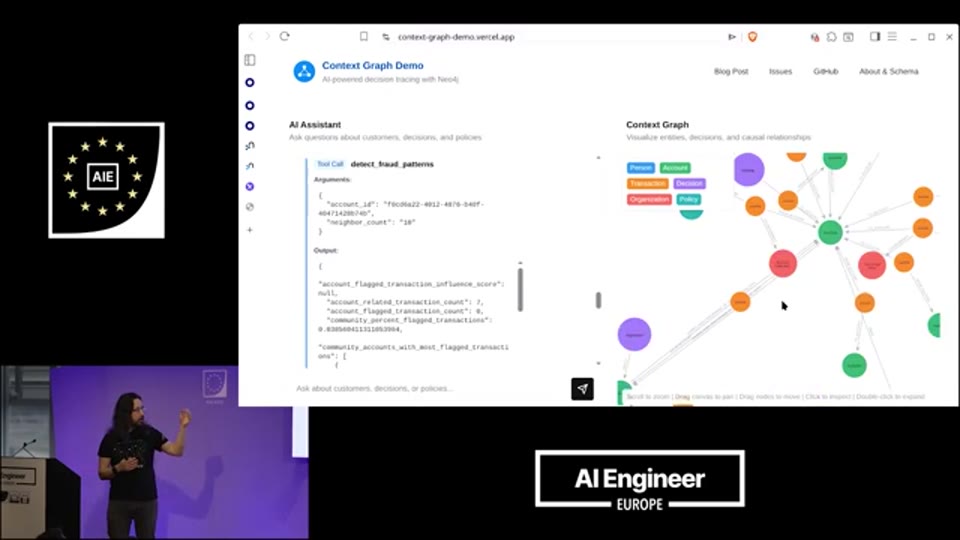
14:40 - Jessica Norris 대출 심사 데모 - 실행된 Cypher 쿼리와 순회 중인 지식 그래프 시각화, 이전 거절 기록이 노드로 표시된 화면
최종적으로 AI는 Jessica에게 대출을 승인하지 말 것을 권고하면서, 그 근거로 리스크 요인들, 과거 결정 사례들, 그리고 사기 탐지 패턴을 구체적으로 제시한다.
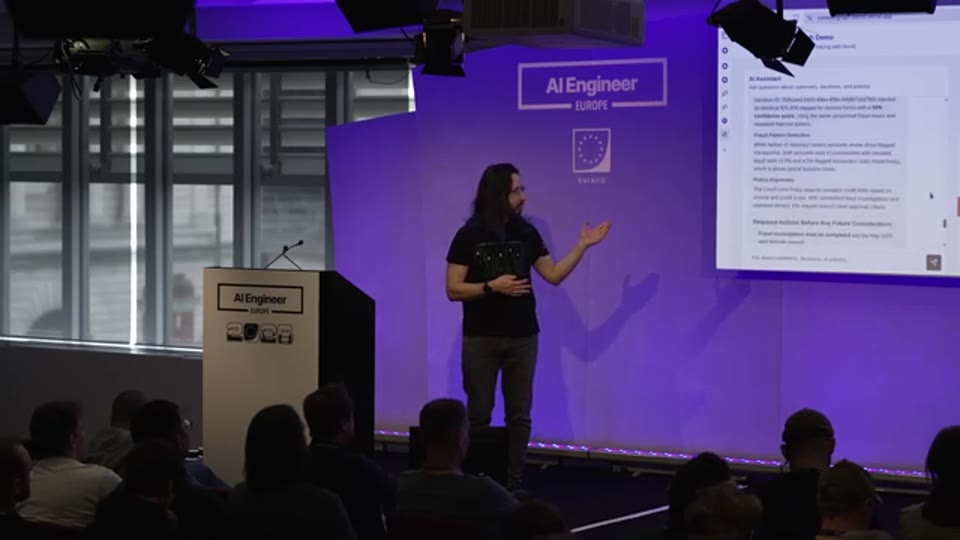
15:23 - AI의 대출 거절 권고 출력 화면 - 리스크 요인, 이전 결정 사례, 사기 탐지 패턴이 구조화된 형태로 표시
강연자는 바로 이것이 핵심이라고 강조한다. 분산된 시스템에서는 이전 거절 기록 같은 정보가 묻혀버리지만, 컨텍스트 그래프는 이를 조회 가능하고 이해 가능한 형태로 보존한다. 담당자는 AI의 권고를 맹목적으로 따르는 것이 아니라, 충분한 근거를 바탕으로 자신이 책임질 수 있는 결정을 내릴 수 있게 된다. 개발자 관점에서도 에이전트 애플리케이션이 실제 비즈니스 문제를 해결한다는 것을 조직 내에서 정당화할 수 있는 근거가 생긴다.
마무리: 매트릭스를 탈출하는 방법
강연자는 컨텍스트 그래프가 단순히 데이터를 연결하는 기술을 넘어, 기업 내 AI 의사결정의 신뢰성과 설명 가능성을 담보하는 인프라 계층이라고 결론짓는다. LLM만으로는 맥락이 분절되고, 벡터 검색만으로는 전체를 볼 수 없다. 지식 그래프가 추가될 때 비로소 에이전트는 완전한 이력, 관계, 그리고 추론의 흔적을 가지게 되고, 그 결과를 신뢰할 수 있게 된다.
Neo4j는 이 기술의 진입 장벽을 낮추기 위해 GraphAcademy에 컨텍스트 그래프 전용 무료 강좌를 새로 출시했으며, 강좌를 수강하면 무료 Neo4j Aura 인스턴스(클라우드 그래프 데이터베이스)가 자동으로 제공되어 별도 인프라 설정 없이 실습할 수 있다. 강연에서 소개된 데모들은 모두 오픈소스 프로젝트로 공개되어 있어 직접 실행해볼 수 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Connecting the Dots with Context Graphs — Stephen Chin, Neo4j |
| 채널 | AI Engineer |
| 강연자 | Stephen Chin, Head of Developer Relations, Neo4j |
| 리포트 작성 | 2026-05-17 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Why your agents need decision traces, not just documents — Zach Blumenfeld, Neo4j
- CrabRAG - Why Automated Assistants Need Graph Memory, Not More Tokens — Stephen Chin, Neo4j
- RAG 어렵다고요? PDF 하나로 5분 만에 시작하는 법 (feat. 공원나연님)
- Your Moat Is Your Data Model - Mike Phipps, Gates Foundation
- Thinner Agents on a Smarter Substrate - The Ontology-based Semantic Layer - Emil Eifrem, Neo4j