Your Moat Is Your Data Model - Mike Phipps, Gates Foundation
📺 원본 영상: Your Moat Is Your Data Model — Mike Phipps, Gates Foundation
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-23
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 일부 누락되거나 요약되었을 수 있습니다.
개요
Mike Phipps의 강연은 엔터프라이즈 AI에서 진짜 방어 가능한 자산이 무엇인지에 대한 문제의식에서 출발한다. 프런티어 모델은 빠르게 발전하고, Claude나 ChatGPT 같은 범용 인터페이스는 계속 좋아지지만, 조직 내부의 프로세스와 암묵지, 그리고 그것을 구조화한 데이터 모델은 외부 제품이 쉽게 복제할 수 없는 영역이라는 것이 강연의 핵심 주장이다.
Gates Foundation은 이 관점을 바탕으로 Strategic Intelligence Platform(SIP)을 구축했다. SIP는 재단 내부의 구조화 데이터와 비정형 문서를 Knowledge Graph(지식 그래프)로 연결하고, 이를 MCP(Model Context Protocol)를 통해 Agentic Chat 및 Agentic Workflow가 사용할 수 있도록 만든 엔터프라이즈 AI 플랫폼이다.
방어 가능한 해자는 UI가 아니라 데이터 모델이다
강연자는 먼저 AI가 매우 빠르게 발전하는 환경에서 무엇이 실제로 방어 가능한 경쟁력인지 질문한다. 오늘날에는 Claude Code와 같은 도구를 활용해 기능을 빠르게 만들 수 있지만, 실험 단계의 빠른 제작과 프로덕션 운영은 완전히 다른 문제다. 프로덕션으로 올라간 순간부터는 모니터링, 유지보수, 의존성 관리, 사용자 접근 제어, 운영 책임이 따라오며, 조직은 자신이 어느 정도까지 스택을 소유할 것인지 결정해야 한다.
이 맥락에서 Gates Foundation 팀은 자체 채팅 UI나 범용 SaaS 제품과 경쟁하는 인터페이스를 해자로 보지 않았다. 사용자는 이미 Claude나 ChatGPT 같은 환경에 익숙하고, 새로운 채팅 앱을 하나 더 제공하는 것만으로는 충분한 차별화를 만들기 어렵기 때문이다. 강연자에 따르면 이들이 진짜로 소유할 수 있는 것은 조직 내부 프로세스에 대한 이해, 데이터의 의미, 보고 관행, 보안 규칙, 그리고 데이터 간 관계를 해석하는 암묵지였다.
따라서 강연 제목의 “Your Moat Is Your Data Model”은 단순한 비유가 아니다. 여기서 데이터 모델은 테이블 스키마나 ERD만을 뜻하지 않고, 조직이 실제로 어떻게 의사결정을 하고, 예산을 배분하며, 투자를 관리하고, 성과를 해석하는지에 대한 운영 지식을 구조화한 표현이다. 모델 성능이 좋아질수록 오히려 이런 내부 지식의 중요성은 커지는데, 범용 AI가 답을 만들 수는 있어도 어떤 답이 조직의 기준에 맞는 답인지는 내부 데이터 모델이 알려주기 때문이다.
Gates Foundation의 문제는 데이터 부족이 아니라 연결의 부족이었다
Gates Foundation은 아동 사망률, 영양, 농업, 교육, 글로벌 헬스, 성평등 등 매우 넓은 영역에서 장기간 활동해 온 조직이다. 강연자는 재단이 25년 이상 축적해 온 투자와 보조금, 프로그램 데이터가 방대하며, 이 데이터로부터 대규모로 통찰을 끌어내는 일이 SIP의 핵심 문제였다고 설명한다. 여기서 중요한 점은 데이터가 없어서 문제가 생긴 것이 아니라, 데이터가 여러 시스템에 흩어져 있고 각 시스템의 의미가 조직 내부 맥락에 의존한다는 점이다.
강연에서 언급된 2023년 기준 스냅샷을 보면, 재단은 한 해에 2,000건 이상의 보조금을 집행했고, 대형 보조금도 다수 포함되어 있었다. 또한 100개 이상의 국가, 약 4,000명 규모의 내부 사용자 및 인력, 다수의 전략팀과 수혜 기관, 그리고 연간 70억 달러 이상의 집행액이 얽혀 있었다. 이런 구조에서는 단순한 검색이나 문서 요약만으로는 충분하지 않으며, 어떤 투자와 조직, 전략, 팀, 회의, 문서가 서로 어떤 관계를 갖는지 이해하는 계층적 모델이 필요해진다.
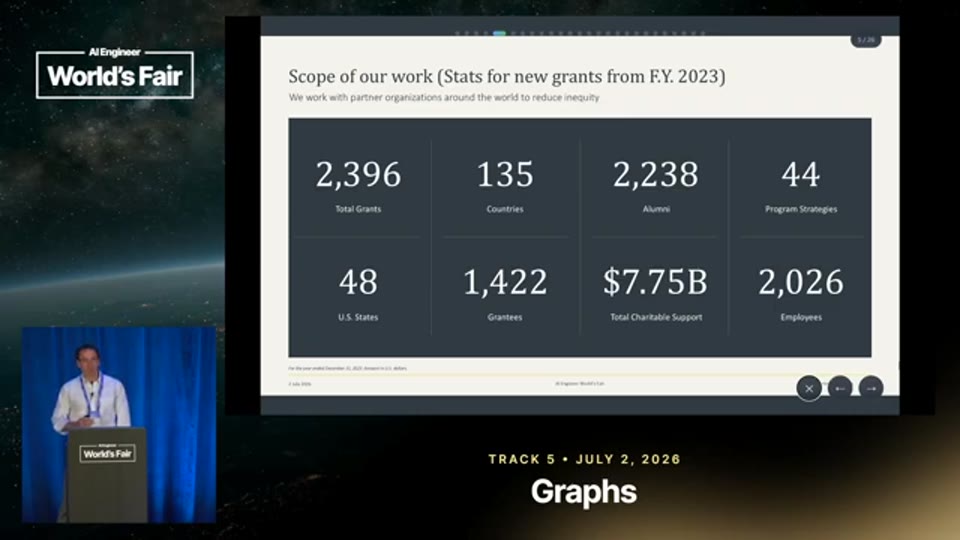
04:06 - Gates Foundation의 2023년 보조금, 국가, 직원, 연간 집행액 등 운영 규모를 보여주는 슬라이드
이 배경은 왜 Knowledge Graph가 선택되었는지를 설명한다. 재단의 데이터는 단일한 선형 구조가 아니라 투자, 펀딩, 조직, 인력, 문서, 회의, 보고 관행이 서로 엮인 네트워크에 가깝다. 따라서 SIP의 목표는 데이터를 한곳에 모으는 데서 끝나지 않고, 에이전트가 질의 시점에 이 관계망을 탐색하고 추론할 수 있도록 의미론적 계층을 제공하는 데 있다.
SIP의 아키텍처: Data Lakehouse에서 Semantic Graph로
강연자가 소개한 SIP의 큰 흐름은 기존 Systems of Record(기록 시스템)에 있던 구조화 데이터와 비정형 데이터를 Data Lakehouse 형태로 모은 뒤, Data Curation Layer(데이터 큐레이션 계층)를 거쳐 Knowledge Graph로 모델링하고, 최종적으로 Agentic Chat과 Agentic Workflow가 이를 소비하는 구조다. 이때 SIP는 단순한 검색 엔진이 아니라 여러 시스템을 가로지르는 Cross-system Semantic Graph Layer(시스템 간 의미 그래프 계층)로 동작한다.
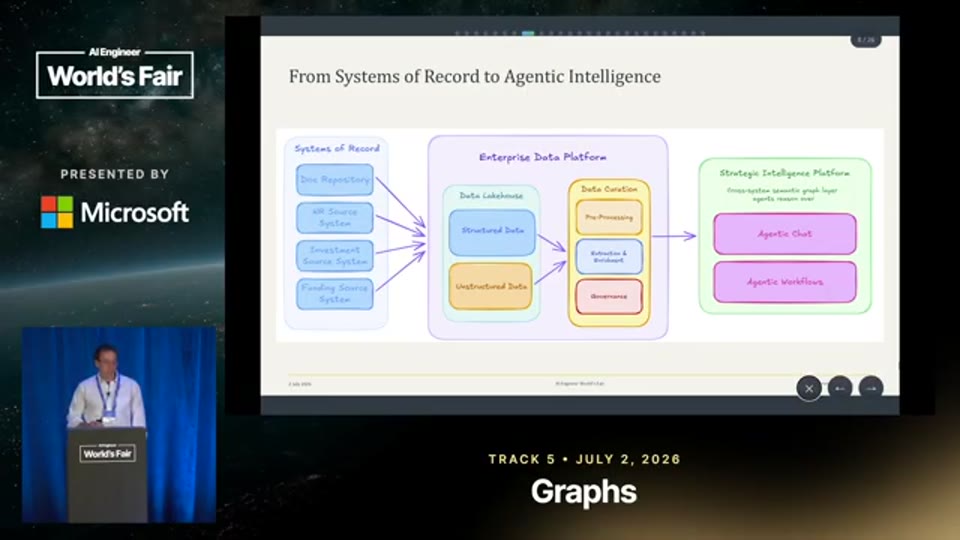
05:58 - Systems of Record, Data Lakehouse, Data Curation Layer, SIP, Agentic Chat과 Workflow로 이어지는 전체 플랫폼 아키텍처
이 구조에서 Data Curation Layer는 매우 중요한 역할을 한다. 강연자는 구조화 데이터와 비정형 문서에 대해 전처리, 필터링, 중복 제거, 문서 순서 정리, 불일치 처리, 구조화 필드 추출, Semantic Chunking(의미 단위 청킹), Figure-to-text 변환, 태깅, 메타데이터 생성이 필요하다고 설명한다. 특히 비정형 문서 안의 그림이나 표가 검색 대상이 되려면 어떤 방식으로든 텍스트 표현으로 변환되어야 하며, 이 과정에서 생성되는 태그와 메타데이터는 그래프의 속성이나 연결 관계가 된다.
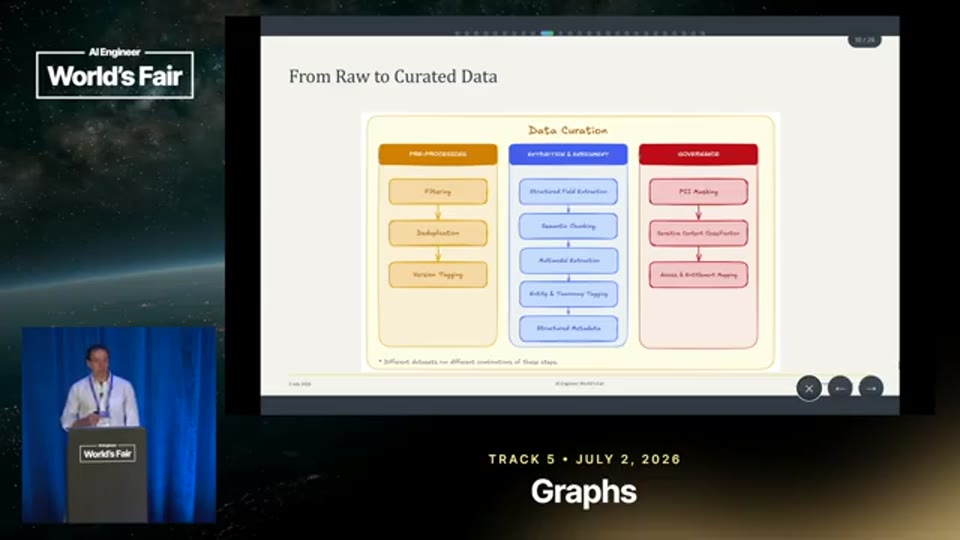
07:48 - 전처리, 추출, 태깅, 메타데이터, 거버넌스 등 데이터 큐레이션 고려사항을 정리한 슬라이드
동시에 AI는 거버넌스 문제를 더 날카롭게 만든다. 기존에도 접근 가능했던 정보가 AI를 통해 훨씬 쉽게 노출될 수 있기 때문에, 강연자는 리스크 범위가 넓어진다고 지적한다. PII(Personally Identifiable Information, 개인식별정보) 마스킹, 민감 데이터 재분류, 사용자별 Entitlement(권한) 확인, 보안 트리밍은 검색 품질만큼이나 중요한 설계 요소가 된다. 엔터프라이즈 AI에서 데이터 모델이 해자가 되려면, 그것은 단지 잘 연결된 그래프가 아니라 조직의 보안과 보고 기준까지 포함한 실행 가능한 운영 모델이어야 한다.
데이터 소유자와의 협업이 모델 품질을 결정한다
SIP 사례에서 반복적으로 강조되는 것은 데이터 소유자와의 긴밀한 협업이다. 강연자는 복잡한 Systems of Record를 다룰 때 데이터 필드의 의미, 데이터셋의 구조, 조인 방식, 데이터의 한계, 체계적 편향, 보안 규칙, 보고 관행을 이해해야 한다고 말한다. 표면적으로 같은 질문이라도 조직이 과거에 답해 온 방식이 있다면, AI는 단지 그럴듯한 답이 아니라 그 관행에 맞는 답을 내야 한다.
이 지점에서 데이터 모델링은 기술 작업인 동시에 조직 지식 발굴 작업이 된다. 데이터 사전을 읽는 것만으로는 충분하지 않고, 실제로 업무를 수행하는 사람들이 어떤 용어를 어떻게 쓰는지, 어떤 집계 기준을 신뢰하는지, 어떤 예외를 보고서에서 제외하는지 알아야 한다. 강연자가 말하는 Tacit Knowledge(암묵지)는 바로 이런 절차적 이해를 뜻하며, SIP는 이 암묵지를 그래프 구조와 도메인 규칙으로 변환하는 프로젝트에 가깝다.
이 접근은 LLM 기반 시스템의 실패 양상과도 맞닿아 있다. LLM은 자연어 질의를 능숙하게 처리하지만, 엔터프라이즈 환경에서는 “맞는 말처럼 보이는 답”보다 “우리 조직의 데이터 정의와 보고 기준에 맞는 답”이 더 중요하다. 따라서 SIP의 품질은 모델 호출 방식만으로 결정되지 않고, 데이터 소유자와 함께 모델링한 의미 구조의 정확도에 크게 좌우된다.
Knowledge Graph가 조직 구조를 표현하는 방식
강연의 기술적 핵심은 Gates Foundation의 운영 구조를 Knowledge Graph로 모델링하는 방식이다. 강연자는 이를 개념적 데이터 모델로 보여주며, 실제 그래프에는 더 많은 노드와 Cardinality(카디널리티), 즉 1대1 또는 1대N 관계가 존재한다고 설명한다. 화면의 세부 노드와 엣지는 STT만으로 완전히 재구성할 수 없지만, 음성 설명을 통해 핵심 모델링 원리는 확인할 수 있다.
첫 번째 계층은 전략팀과 연례 리뷰에서 시작한다. 재단에는 80개 이상의 전략팀이 있고, 이 팀들은 매년 리뷰를 통해 예산과 전략을 조정한다. 이 회의는 비정형 문서가 시스템에 들어오는 진입점이 되며, 동시에 다른 기록 시스템과 구조적으로 연결된다. 즉, 회의 문서는 독립적인 파일이 아니라 특정 전략팀, 예산, 투자, 포트폴리오와 연결된 의미 단위가 된다.
두 번째로 강연자는 Funding Lens(펀딩 관점)를 설명한다. 내부 펀딩 팀은 포트폴리오를 가지고 있고, 이 포트폴리오는 여러 투자로 이어지며, 하나의 투자에는 여러 펀딩 팀이 관여할 수 있다. 이 구조는 단순한 트리라기보다 Additive DAG(가산적 방향 비순환 그래프)에 가깝고, 상위에서 하위까지의 여러 레벨을 함께 고려해야 한다. 강연에서 언급된 BoW는 Body of Work를 가리키는 내부 예산 또는 업무 단위로 보이며, 펀딩 구조 안에서 투자와 연결되는 중간 계층으로 다뤄진다.
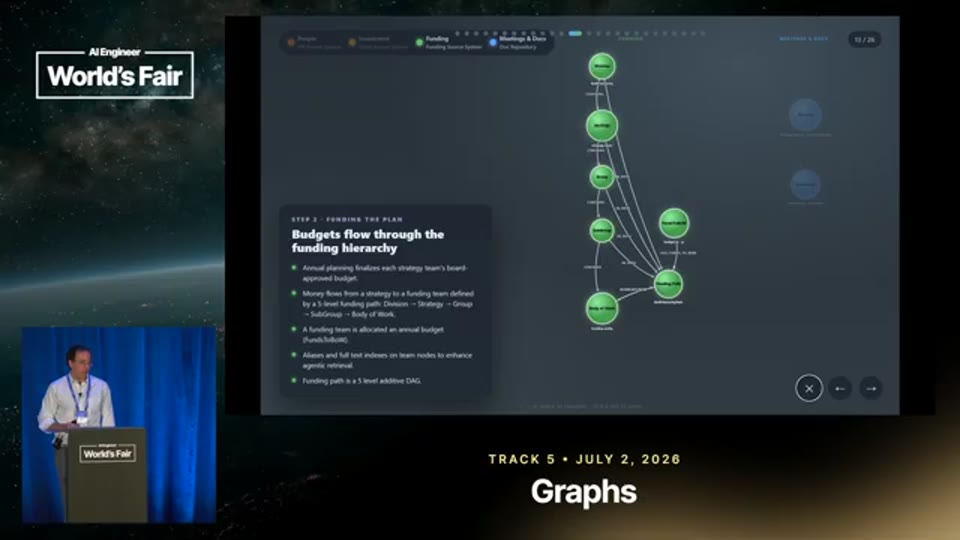
10:06 - 펀딩 팀, 포트폴리오, 투자로 이어지는 Additive DAG 형태의 펀딩 계층 데이터 모델
세 번째로 Management Lens(관리 관점)가 등장한다. 여기서는 한 팀이 직접 투자를 관리하는 Direct Management(직접 관리)와, 하위 팀까지 포함해 상위 팀에 귀속시키는 Indirect Management(간접 관리)를 함께 다룬다. 강연자는 contains 관계와 manages investment 관계를 만든 뒤, roll-up manages investment와 같은 파생 엣지를 사전 계산할 수 있다고 설명한다. 이는 에이전트가 매번 복잡한 계층 순회를 수행하지 않아도 조직 기준에 맞는 집계를 빠르게 수행하도록 돕는 설계다.
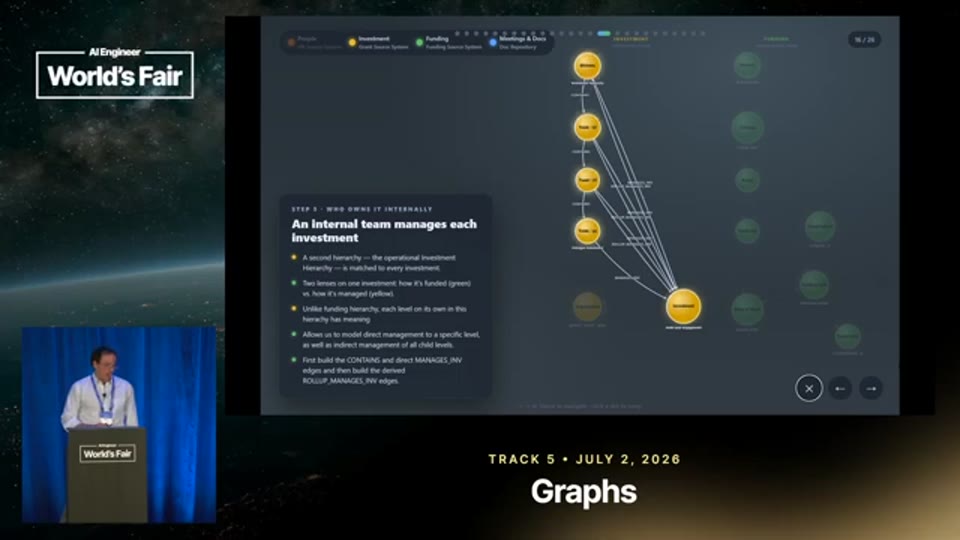
12:16 - 관리 계층에서 contains, manages investment, roll-up manages investment 같은 파생 엣지를 설명하는 그래프 모델
마지막으로 People Hierarchy(인력 계층)가 연결된다. 사람은 조직도 안에서 특정 팀에 속하고, 회의 참석자, 오너, 디렉터, 보고 대상 등 다양한 역할을 가진다. 과거에는 이런 정보가 HR 시스템에만 머물렀을 수 있지만, SIP에서는 투자, 회의, 문서, 조직 단위와 연결되면서 에이전트가 전체 맥락을 이해하는 데 필요한 구조적 단서가 된다.
구조화 데이터와 비정형 문서를 하나의 그래프로 묶는 방법
SIP가 흥미로운 이유는 구조화 데이터와 비정형 문서를 별도의 검색 시스템으로 분리하지 않고, 하나의 의미 그래프 안에서 연결한다는 점이다. 강연자는 회의가 문서를 가지고, 문서가 다시 Semantic Section 또는 Chunk(의미 섹션 또는 청크)를 가지며, 여기에 Full-text Index(전문 검색 인덱스)를 적용할 수 있다고 설명한다. 에이전트는 상황에 따라 그래프 탐색을 수행할 수도 있고, 텍스트 검색을 결합한 Retrieval(검색 증강)을 수행할 수도 있다.
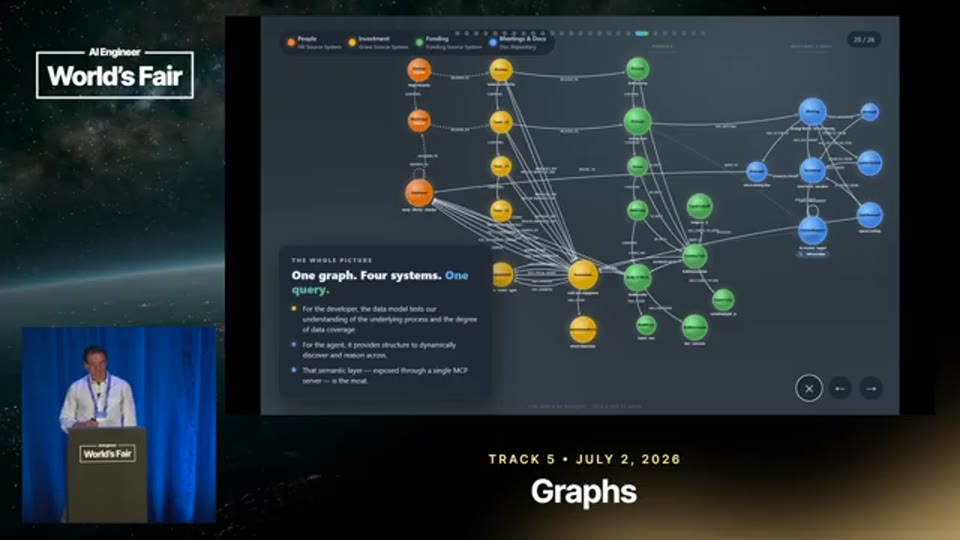
14:42 - 여러 원천 시스템과 문서 계층이 하나의 Knowledge Graph 및 Semantic Layer로 연결된 전체 데이터 모델
이 접근은 일반적인 RAG(Retrieval-Augmented Generation, 검색 증강 생성)의 한계를 보완한다. 단순한 벡터 검색은 관련 문단을 찾는 데 유용하지만, 그 문단이 어떤 투자, 어떤 팀, 어떤 연례 리뷰, 어떤 조직 구조와 연결되는지는 별도의 모델링이 필요하다. SIP는 문서 청크를 조직 구조와 연결함으로써, 에이전트가 문서의 내용뿐 아니라 그 문서가 속한 운영 맥락까지 함께 해석할 수 있게 한다.
강연자는 Neo4j를 언급하며, 이런 구조화 데이터와 비정형 문서의 결합이 그래프 데이터베이스에서 구현할 수 있는 중요한 장점이라고 설명한다. 특히 여러 원천 시스템에 흩어진 공통 엔티티를 찾아 연결하면, 에이전트는 질의 시점에 복잡한 조직 구조를 동적으로 탐색할 수 있다. 개발자 입장에서도 이 과정은 가치가 있는데, 그래프를 만들다 보면 자신이 무엇을 모르고 있었는지, 어떤 데이터셋이 빠져 있는지, 어떤 관계가 명확하지 않은지 빠르게 드러나기 때문이다.
MCP는 사용자가 이미 있는 곳으로 플랫폼을 가져간다
SIP는 자체 UI를 해자로 보지 않았기 때문에, 사용자가 이미 활동하는 환경으로 지식 그래프를 제공하는 방식을 택했다. 강연자는 Claude나 ChatGPT 같은 범용 채팅 환경에서 사용자가 이미 일하고 있다면, 별도의 채팅 앱을 강요하는 것이 좋은 전략이 아닐 수 있다고 본다. 따라서 SIP는 MCP(Model Context Protocol)를 통해 그래프 기반 플랫폼을 에이전트에게 노출한다.
강연자는 Neo4j가 제공하는 기성 MCP 서버를 기반으로 하되, Gates Foundation의 요구에 맞게 상당 부분 수정했다고 설명한다. 예를 들어 스키마 관련 업데이트, 시스템으로 상태를 되돌려 보내는 기능, Conversation ID(대화 ID), Message Number(메시지 번호) 같은 상태 추적 요소가 추가되었다. 이는 단순한 도구 호출을 넘어, 엔터프라이즈 환경에서 대화 흐름과 시스템 상태를 추적해야 하는 현실적인 요구를 반영한다.
또한 SIP는 일반 채팅뿐 아니라 더 제약된 Workflow Experience(워크플로 경험)도 지향한다. 강연자는 MCP Apps를 통해 사용자가 채팅 경험 안에서 특정 UI를 사용하고, Sandbox 기반 에이전트가 그 워크플로를 실행하는 방식도 개발 중이라고 설명한다. 이런 접근은 자유로운 채팅의 장점과 통제된 업무 흐름의 장점을 결합하려는 시도로 볼 수 있으며, 백엔드는 동일한 지식 그래프 플랫폼을 공유한다.
Eval은 모델 평가가 아니라 데이터 모델 개선 루프다
강연 후반부에서 중요한 전환이 일어난다. Eval(평가)은 단지 AI 응답 품질을 측정하는 절차가 아니라, 데이터 모델의 빈틈과 애매함을 발견하는 피드백 루프가 된다. 강연자는 평가를 수행하다 보면 사용자의 질문이 모호하거나, 데이터 모델이 특정 보고 기준을 충분히 반영하지 못하거나, 반환 결과가 기존 Reporting Standard(보고 표준)에 맞지 않는 경우를 발견한다고 설명한다.
Gates Foundation 팀은 데이터 소유자와 함께 목표 평가 질문을 만들고, 이를 복잡도 티어로 나누었다. 여기서 흥미로운 점은 구조화 데이터가 계속 변하기 때문에 정답을 고정된 값으로 저장하지 않는다는 것이다. 대신 각 평가 질문에 대해 그래프 쿼리 자체를 만들고, 평가 실행 시점에는 Live Graph(실시간 그래프)에서 기대값을 가져온 뒤, 에이전트가 반환한 답과 비교한다. 이는 동적으로 변하는 엔터프라이즈 데이터 환경에서 평가 체계를 유지하기 위한 현실적인 설계다.
강연자는 Pass@1 Stability(첫 응답 안정성)도 측정한다고 언급한다. 같은 질문을 여러 번 했을 때 같은 답을 돌려주는지 확인하고, LLM-as-a-Judge(LLM을 평가자로 사용하는 방식)를 통해 답변의 일관성과 적합성을 평가한다. 이후 발견된 문제는 데이터 모델, 도메인 규칙, 스키마 설명 업데이트로 이어진다. 결국 Eval은 모델을 비난하기 위한 장치가 아니라, 조직 지식의 누락과 표현의 모호성을 찾아내는 데이터 모델 개선 장치가 된다.
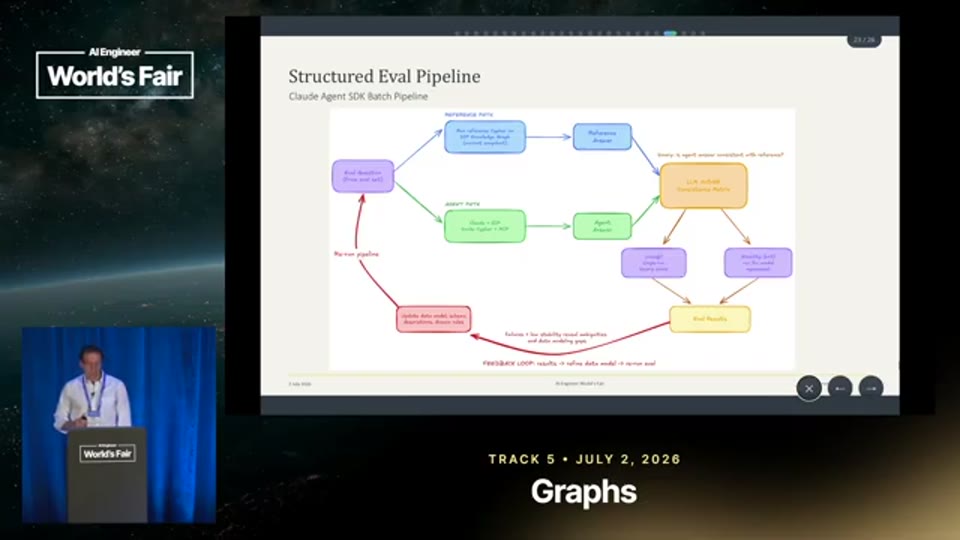
18:25 - Eval 파이프라인, Pass@1 Stability, LLM-as-a-Judge, 데이터 모델 개선 피드백 루프를 보여주는 평가 구조
SIP의 다음 과제: 확장과 연합 그래프
강연자는 SIP가 이미 Gates Foundation 전사 약 4,000명 규모의 사용자에게 프로덕션으로 배포되었다고 설명한다. 그러나 현재 모델이 완성형이라는 의미는 아니다. SIP의 다음 과제는 기존 데이터 모델에 맞는 Systems of Record 데이터를 계속 채워 넣고, 주요 그래프를 더 많은 전사 데이터셋으로 확장하는 것이다.
특히 강연자는 Federated Graph Experience(연합 그래프 경험)에 대한 수요가 크다고 말한다. 이는 중앙의 엔터프라이즈 그래프가 존재하되, 각 팀이 보유한 고유 데이터도 여기에 연결하고 싶어 하는 상황을 뜻한다. 중앙집중형 그래프만으로 모든 팀의 특수한 데이터를 흡수하려 하면 병목이 생기고, 반대로 각 팀이 독립적으로 그래프를 만들면 전체 조직 차원의 연결성이 약해질 수 있다. 따라서 SIP의 향후 방향은 중앙 의미 계층과 팀별 데이터 확장을 어떻게 균형 있게 결합할 것인가에 달려 있다.
Agentic Experience(에이전트 기반 경험)의 확장도 남은 과제다. 일반 채팅은 진입 장벽이 낮지만, 업무 정확성과 재현성이 필요한 상황에서는 제약된 워크플로가 더 적합할 수 있다. SIP가 동일한 Knowledge Graph 백엔드를 기반으로 채팅, MCP Apps, Sandbox 기반 에이전트 워크플로를 제공하려는 이유도 여기에 있다.
엔터프라이즈 AI에 주는 함의
이 강연의 실무적 메시지는 명확하다. 엔터프라이즈 AI를 구축할 때 가장 먼저 고민해야 할 것은 “어떤 모델을 쓸 것인가”만이 아니라 “우리 조직의 지식을 어떤 구조로 모델링할 것인가”이다. 모델은 계속 바뀌고 인터페이스도 바뀌지만, 조직 내부의 프로세스와 데이터 관계를 정확히 표현한 Semantic Layer(의미 계층)는 장기적으로 재사용될 수 있다.
또한 이 사례는 RAG를 단순한 문서 검색 문제로 축소해서는 안 된다는 점을 보여준다. 엔터프라이즈 환경에서 사용자는 문서의 한 문단만 묻는 것이 아니라, 특정 투자와 조직, 예산, 회의, 사람, 보고 기준이 연결된 맥락 속에서 답을 원한다. 이때 Knowledge Graph는 에이전트가 검색 결과를 조직의 실제 구조 안에 배치하도록 돕는 핵심 인프라가 된다.
마지막으로, 데이터 모델링은 한 번에 끝나는 설계 산출물이 아니라 지속적으로 개선되는 운영 시스템이다. Eval을 통해 질문의 모호함을 발견하고, 데이터 소유자와 함께 도메인 규칙을 정교화하며, 스키마 설명과 그래프 구조를 갱신하는 과정 자체가 AI 시스템의 품질을 끌어올린다. 강연자가 말하는 해자는 바로 이 반복 가능한 학습 루프, 그리고 그 루프 안에 축적되는 조직 고유의 암묵지다.
마무리 / 핵심 정리
Mike Phipps의 강연은 AI 시대의 엔터프라이즈 경쟁력이 화려한 UI나 특정 모델 호출 방식에만 있지 않다고 주장한다. Gates Foundation의 SIP 사례에서 보듯, 진짜 방어 가능한 자산은 조직의 운영 방식을 이해하고, 그 암묵지를 데이터 모델과 Knowledge Graph로 구조화하며, 에이전트가 이를 안전하게 탐색하도록 만드는 능력에 있다.
SIP는 Data Lakehouse, Data Curation Layer, Knowledge Graph, MCP, Agentic Workflow, Eval 루프를 하나의 운영 체계로 연결한다. 이 구조는 AI가 더 강력해질수록 오히려 더 중요해진다. 범용 모델은 계속 좋아지겠지만, 어떤 데이터가 무엇을 의미하고, 어떤 관계를 따라가야 하며, 어떤 보고 기준으로 답해야 하는지는 각 조직이 스스로 모델링해야 하기 때문이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Your Moat Is Your Data Model — Mike Phipps, Gates Foundation |
| 채널 | AI Engineer |
| 영상 길이 | 약 20분 03초 |
| 리포트 작성 | 2026-07-23 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Thinner Agents on a Smarter Substrate - The Ontology-based Semantic Layer - Emil Eifrem, Neo4j
- Connecting the Dots with Context Graphs — Stephen Chin, Neo4j
- Enterprise Agents Have a Structure Problem - Ishita Daga, Tesla
- RAG 어렵다고요? PDF 하나로 5분 만에 시작하는 법 (feat. 공원나연님)
- CrabRAG - Why Automated Assistants Need Graph Memory, Not More Tokens — Stephen Chin, Neo4j