투자 비용이 회수된다. 비어 있는 자리는 곧 놀고 있는 GPU이고, 그것은 감가상각만 발생시키는 낭비다. GPU 사용률(utilization)을 70~80% 이상으로 유지해야만 비로소 수익성 있는 서빙이 가능하다는 것이 이 분석의 핵심 결론이다.
트레이닝 배치와 추론 배치의 결정적 차이
트레이닝에서의 배치와 추론(inference)에서의 배치는 동일한 용어를 쓰지만 의미가 다르다. 트레이닝 배치는 보통 (배치 크기, 시퀀스 길이, 히든 차원)이라는 3차원 텐서로 표현되며, 시퀀스 길이도 미리 정해진 값으로 꽉 채워진 상태로 구성된다. 반면 추론 배치에서는 사용자마다 입력 길이가 제각각이고, Decode 단계에서는 시퀀스 길이가 사실상 1(직전 생성 토큰 하나)에 불과하다. 이를 트레이닝 방식처럼 패딩으로 채우면 메모리 낭비가 극심해지므로, 추론 프레임워크는 여러 사용자의 요청을 “이어 붙여(concatenate)” 하나의 배치로 구성하는 방식을 사용한다.
이때 각 사용자의 KV 캐시 매핑이 뒤엉기는 문제가 발생하는데, vLLM이나 SGLang 같은 추론 서버는 오케스트레이션 레이어를 운용해 이를 해결한다. 배치의 특정 위치에 담긴 토큰이 어떤 사용자의 것인지, 그 사용자의 KV 캐시는 메모리 어느 주소에 위치하는지를 모두 추적하고 매핑하는 것이 이 레이어의 역할이다. 어떤 사용자는 이미 80만 토큰의 컨텍스트를 쌓은 상태일 수 있고, 어떤 사용자는 방금 막 세션을 시작한 상태일 수 있다. 이 모든 다양성을 하나의 20ms 사이클 안에서 일관된 벡터화 연산으로 처리하는 것이 추론 서빙 엔지니어링의 핵심이다.
PagedAttention과 Chunked Prefill
vLLM이 고안한 PagedAttention(페이지 어텐션) 기법은 이 문제를 운영체제의 가상 메모리 개념에서 착안해 해결한다. KV 캐시를 고정 크기의 “페이지(page)” 단위로 분할하고, 포인터 테이블로 관리함으로써 사용자마다 다른 컨텍스트 길이에 유연하게 대응하고 메모리 파편화를 최소화한다. PagedAttention이 없었다면 각 사용자의 KV 캐시를 정적인 최대 길이 텐서에 넣고 빈 부분을 패딩으로 채워야 했을 것이며, 이는 어마어마한 메모리 낭비로 이어졌을 것이다.
프리필과 디코드를 동일한 추론 사이클 내에서 효율적으로 혼합하는 청크드 프리필(Chunked Prefill) 기법도 현대 서빙 아키텍처의 핵심 요소다. 5만 토큰짜리 코드를 한꺼번에 프리필하면 그 사이클 동안 디코드 중인 다른 수천 명의 사용자가 처리를 기다려야 하므로, 대형 프리필 요청을 작은 청크로 쪼개어 디코드 요청과 인터리빙(interleaving)하는 방식으로 지연 공정성(latency fairness)을 확보한다. 진행자에 따르면 이 “어떻게든 채운다”는 목표 — 한 사이클에 프리필과 디코드 요청을 최적으로 혼합해 GPU를 놀리지 않는다 — 가 최신 LLM 서빙의 핵심 중의 핵심이다.
프론티어 랩의 진짜 해자(Moat)
에피소드 전반에 걸쳐 두 진행자가 도달하는 공통된 결론은, 현재 AI 경쟁의 진짜 차별화 요소가 모델 훈련 능력보다 추론 및 서빙 인프라 엔지니어링 역량으로 이동하고 있다는 점이다. 어떻게 하드웨어를 깊이 이해하고, 다양한 워크로드를 혼합하여 배치 효율을 극대화하며, 컨텍스트 길이가 제각각인 수천 명의 사용자를 20ms 주기의 연산 사이클에 꽉꽉 채워 처리할 것인가 — 이 문제의 해법은 공개적으로 공유되지 않으며, 그것이 바로 OpenAI, Anthropic, Google 같은 프론티어 랩들의 실질적인 해자(moat)가 된다.
vLLM이나 SGLang 같은 오픈소스 추론 프레임워크가 PagedAttention, Chunked Prefill 등의 혁신을 담고 있기는 하지만, 최전선 업체들이 내부적으로 운용하는 최적화 수준은 이를 훨씬 상회한다. 나아가 DeepSeek의 MLA(Multi-head Latent Attention)나 Sparse Attention 같은 아키텍처 혁신이 KV 캐시 크기를 극적으로 줄이는 방향으로 진행되는 것도, 이 서빙 효율 최적화의 연장선이다. 모델 아키텍처와 추론 인프라가 하나의 공동 목표를 향해 수렴하고 있는 셈이다.
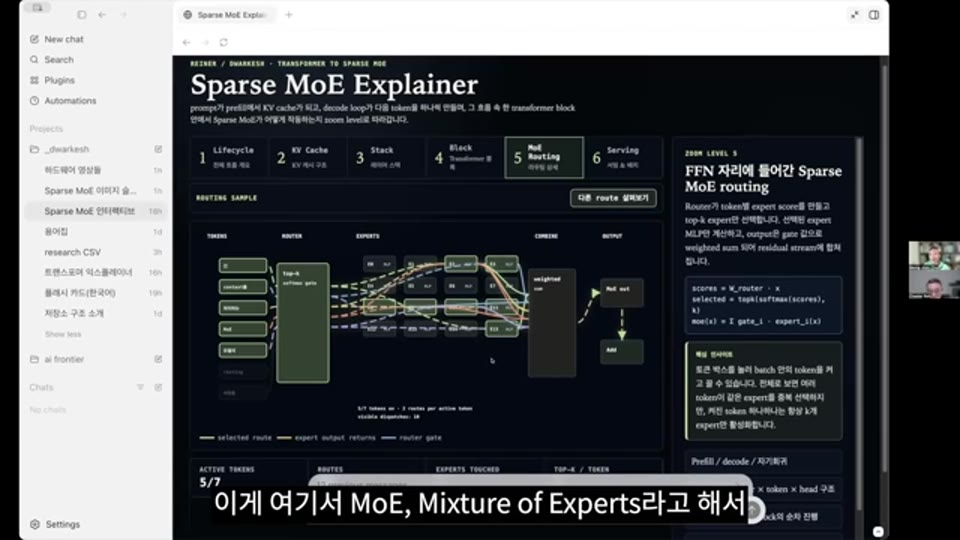
27:48 - MoE 인터랙티브 시각화 - 16개 전문가 중 일부만 활성화되는 라우팅 패턴, 같은 전문가가 두 번 선택되는 경우 시연
진행자는 “저는 다 애들 장난이었다고 생각하거든요, Claude Code를 본격적으로 쓰기 전까지는”이라고 고백하며, 코딩 에이전트의 등장이 단순한 인터페이스 혁신을 넘어 추론 인프라 전체에 새로운 수준의 압력을 가하고 있음을 체감했다고 밝힌다. 워크로드의 성격 자체가 달라졌다 — 짧은 대화가 아닌, 수만 토큰의 컨텍스트를 끊임없이 갱신하며 진행되는 장기 세션이 일상화된 것이다. 이 변화가 클로드 코드, Codex, 그리고 추론 인프라 회사들을 동시에 성장시키는 엔진이 되고 있다.
마무리 — 핵심 정리
이 에피소드를 통해 두 진행자가 전달하고자 한 핵심은 하나다. AI를 이용하는 사람이라면 그 안에서 어떤 경제적·물리적 원리가 작동하는지를 이해하는 것이 점점 더 중요해지고 있다는 것이다. “왜 컨텍스트가 길면 비싼가”, “왜 캐시 히트 가격이 다른가”, “왜 200K를 기준으로 가격 티어가 나뉘는가” — 이 모든 질문에 대한 답이 T_compute와 T_memory라는 두 수식과 하드웨어의 물리적 구조로부터 논리적으로 도출된다는 것을 이 에피소드는 보여준다.
또한 최신 NVIDIA 하드웨어(NVL72, GB200/GB300)의 출하 시기와 MoE 기반 모델 아키텍처의 확산, 그리고 5T~10T 파라미터급 대형 모델의 등장이 우연이 아닌 필연적 흐름임을 이해할 수 있다. 하드웨어가 가능하게 만든 것을 모델이 활용하고, 모델의 수요가 하드웨어를 다시 이끄는 선순환 — 이것이 “AI 모델은 하드웨어의 그림자”라는 명제의 실체다.
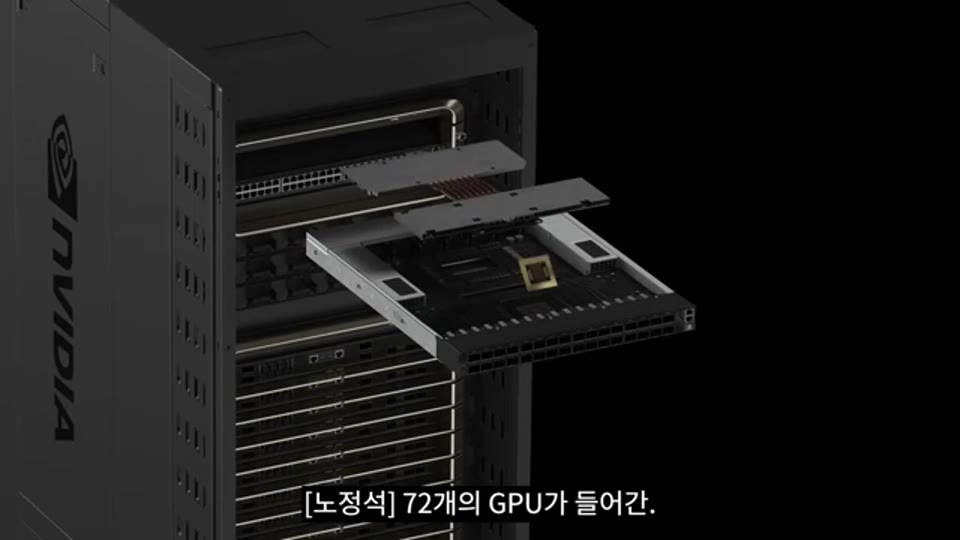
31:28 - NVL72 렉 조립 영상 - Blackwell GPU 2개와 CPU 1개가 슈퍼칩으로 결합되고, HBM이 부착된 후 스위치 카드와 조합돼 72-GPU 렉을 구성하는 과정
이 에피소드는 Dwarkesh 팟캐스트의 약 2시간 강연 중 앞 30분 분량만을 다루고 있으며, 뒷부분에는 Sparse Attention, MLA, 그리고 실제 스케일에서의 수치 계산 등 더 심화된 내용이 이어진다. 진행자들은 이를 시청자에게 숙제로 남기며, Dwarkesh가 이 에피소드를 준비하면서 스스로 만든 플래시카드(Codex로 한국어 번역한 버전 포함)도 함께 공개한다. 이 플래시카드에 담긴 질문들 — “한 번의 Forward Pass에 걸리는 시간의 방정식은 무엇인가?”, “T_compute의 방정식은?”, “레이턴시 그래프를 그려라” — 은 오늘 에피소드의 핵심 개념을 자가 점검하는 데 좋은 기준점이 된다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | EP 96. LLM 추론 인프라와 토큰 경제학 |
| 채널 | 노정석 |
| 리포트 작성 | 2026-05-09 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다.
정확한 내용은 원본 영상을 참조해 주세요.