How this startup uses AI agents to eliminate bugs and optimize infrastructure
📺 원본 영상: How this startup uses AI agents to eliminate bugs and optimize infrastructure 🎙️ 채널: How I AI 📅 정리 일자: 2026-06-15 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 에피소드에서 How I AI의 호스트 Claire Vau는 evals 및 AI 관측성(observability) 플랫폼 Braintrust의 CEO Ankur Goyal과 대화를 나눈다. 대화의 두 축은 인간 엔지니어가 현실적으로 다루기 어려웠던 복잡한 인프라 문제를 AI 코딩 에이전트로 공략하는 방법론, 그리고 AI 제품의 품질을 체계적으로 개선하는 핵심 도구인 evals(평가 체계)의 실전 적용이다. 시니어·스태프 엔지니어, VP of Engineering, CTO에게 특히 밀도 높은 내용이다.
AI 에이전트로 “풀지 못한 인프라 문제”에 도전하다
복잡한 데이터베이스 쿼리 최적화 — 인간 엔지니어의 한계를 넘어서
Braintrust의 핵심 제품은 사용자가 수십억 건의 트레이스(trace) 중에서 특정 조건에 맞는 데이터를 찾아낼 수 있는 쿼리 시스템이다. 한 고객은 90일치의 방대한 데이터셋에서 특정 패턴의 인터랙션 5천 건을 추출하는 쿼리를 실행했는데, 이런 쿼리가 만성적으로 느려지는 문제가 발생했다. 데이터베이스 문헌에는 다양한 인덱스 구조, 데이터 프리패치(prefetch), 컬럼 스토어 선택 등 수많은 이론적 해결책이 존재하지만, 인간 엔지니어가 이 모든 조합을 직접 실험해보는 것은 사실상 불가능에 가깝다.
Ankur가 주목한 지점은 바로 그 불가능에 가까운 실험을 AI 에이전트에게 맡기는 것이었다. 그의 접근법은 두 단계로 구성된다. 먼저 사용자들이 자주 실행하는 느린 쿼리 패턴을 파악하고, 해당 데이터를 로컬에 재현한 뒤, 코딩 에이전트를 투입해 데이터베이스 문헌에 등장하는 다양한 아이디어를 자동으로 시도하게 한다. 인간이 설계하고 에이전트가 반복 실험하는 구조다.
Tantivy 컬럼 스토어 — 망라적(exhaustive) 실험의 실제 사례
05:51 - Braintrust가 Tantivy 컬럼 스토어의 한계를 극복하기 위해 오픈소스 컬럼 스토어 포맷과 실행 엔진의 전체 조합(매트릭스)을 에이전트로 테스트하는 방법론 설명
구체적인 사례로, Braintrust는 내부적으로 Tantivy라는 Rust 기반 전문 검색 라이브러리를 사용하고 있다. Tantivy 자체는 훌륭하지만 내장 컬럼 스토어 성능이 기대에 미치지 못했다. 이에 Ankur는 오픈소스 컬럼 스토어 포맷 전체를, 그리고 컬럼 스토어 실행 엔진 전체를 대상으로 조합 실험(매트릭스 탐색)을 진행하고 있다. 이 실험은 에이전트가 원격 서버에서 장기간 구동되며, 노트북 한 대가 감당할 수 없을 만큼의 컴퓨팅 자원을 소비한다.
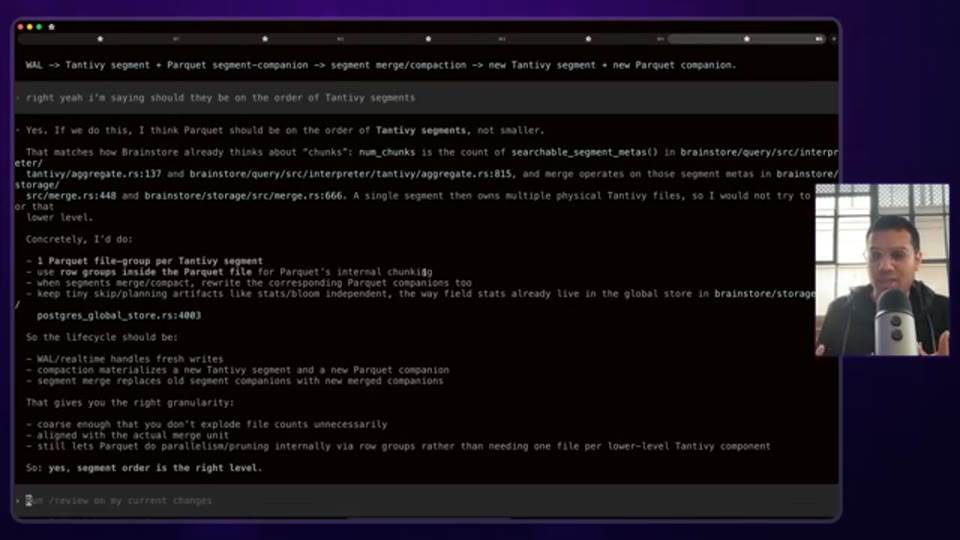
16:50 - EC2와 S3 간 동시 4,000개 읽기 요청 지연 시간 측정 — 원격 서버에서 수일째 구동 중인 컬럼 스토어 성능 실험 화면
실제로 그가 수일에 걸쳐 실행한 실험 중 하나는 AWS EC2와 S3 사이에서 동시에 4,000개의 읽기 요청을 처리할 때의 지연 시간(latency)을 측정하는 것이었다. 단순히 빠르냐 느리냐를 넘어, 인덱싱 전체 라이프사이클을 최적화하는 방향으로 실험이 확장되고 있다. 한쪽에서는 쿼리 속도를 높이는 방법을 찾고, 동시에 인덱싱 자체가 얼마나 느려지는지도 검증하는 과정이다.
”리스크를 피하는 조직”이 AI로 해방되는 방법
Claire는 이 접근 방식이 엔지니어링 조직에 갖는 의미를 정확하게 짚는다. 핵심 데이터 스토어나 플랫폼 컴포넌트를 변경하는 작업은 구현 비용이 높고 예측하기 어려운 위험(unknown unknowns)이 도사리고 있어, 팀이 매우 보수적으로 접근하게 된다. “지금 배포한 것이 앞으로 평생 가져가야 할 것”이라는 암묵적인 두려움 때문에 대규모 플랫폼 전환이 미뤄지는 현상이다.
반면 AI 에이전트를 활용하면 “이 솔루션 후보군을 가지고 우리가 원하는 결과에 가장 가까이 다가가는 것이 무엇인지 프로그래밍 방식으로 테스트해보자”는 접근이 가능해진다. CEO가 스태프 엔지니어 전원을 1년간 데이터베이스 인덱싱 문제에만 투입할 수는 없지만, 에이전트가 백그라운드에서 진행하면서 팀이 다른 기능도 병행해 출시할 수 있다면 이야기가 달라진다. 비즈니스가 감당할 수 있는 비용으로 인프라의 근본적인 개선을 시도할 수 있게 되는 것이다.
Bloom 필터 사례로 본 벤치마킹의 혁명
이론적 품질 vs. 실질적 품질
Ankur는 AI가 복잡한 코드를 제대로 쓰지 못한다는 주장에 강하게 반박한다. 그의 논지는 기술적 우월성이 아니라 현실적 실행 가능성에 초점을 맞춘다. Bloom 필터는 원래 나쁜 평판을 가지고 있었지만, Braintrust가 약 1주일에 걸친 연속 실험을 통해 다양한 인덱스 타입을 비교한 결과, 자신들의 사용 사례에서 실제로 매우 효과적인 솔루션으로 판명됐다. 이 결론은 인간 엔지니어만으로는 도달하기 어려웠을 것이다.
10:14 - Bloom 필터 인덱스 벤치마킹 이야기 - 동료 코드 리뷰에서 지적받는 벤치마크 공백을 AI 에이전트가 어떻게 채우는지 설명하는 장면
일반적으로 최고의 엔지니어들도 몇 가지 벤치마크를 실행한 뒤 동료들에게 코드 리뷰를 요청하는 수준에서 마무리하게 된다. 동료들이 미흡한 벤치마크를 지적하면 “이 부분은 테스트 안 했지만, 코드를 보면 O(n²)가 아니라 O(log n)이라 문제없을 것”이라는 식으로 넘어가게 되는데, Ankur에 따르면 이런 추론이 틀리는 경우가 절반에 달한다고 한다. AI 에이전트가 있으면 이제 그 모든 벤치마크를 실제로 실행하지 않을 이유가 없다.
실제로 Bloom 필터 인덱스를 도입할 때, Braintrust 팀은 쿼리 속도 향상은 잘 측정했지만 인덱싱 자체가 얼마나 느려지는지는 충분히 검증하지 못했다는 것을 뒤늦게 발견했다. AI 에이전트와의 협업이 이 구멍을 드러내게 했고, 이후 인덱싱 효율화에 상당한 시간을 투입하게 됐다. 그는 이를 두고 “이제 리거(rigour, 엄밀성)를 갖추지 않을 이유가 없다”고 단언한다. 버그도, UI의 사소한 결함도, 성능 문제도 — 핑계가 사라진 시대라는 것이다.
에이전트 플리트(fleet) 운용 — 실전 워크플로우
’에이전트 라인(Agent Line)‘이라는 개념
Ankur가 제시하는 가장 중요한 자기성찰 질문은 “내가 지금 하는 일이 에이전트에게 맡겨도 되는 일인가?”이다. 그는 이를 ‘에이전트 라인’이라고 부른다. 어떤 회의에서 나누는 정보나 내리는 결정들이, 동등한 맥락을 에이전트에게 전달했을 때 에이전트가 풀 수 있는 수준이라면, 그 업무는 에이전트 라인 아래에 속한다는 것이다. 그리고 이 라인은 모델이 발전할수록, 그리고 조직 내 스마트한 인재들이 좋은 스킬과 통합 체계를 구축할수록 계속 위로 올라간다.
이 관점에서 엔지니어링 리더가 해야 할 일은 에이전트 라인을 적극적으로 위로 밀어올리는 것, 즉 더 많은 업무를 에이전트에게 위임할 수 있는 체계를 만드는 일이다. 라인이 충분히 높아지면, 인간 엔지니어에게는 진정으로 의미 있는 창의적 작업에 투자할 시간이 훨씬 많아진다. Ankur 자신은 오후 12시 이후 회의를 일절 잡지 않는 방식으로 이 시간을 확보한다.
tmux로 관리하는 포어그라운드 에이전트 4~6개
Ankur의 실제 워크플로우는 놀라울 정도로 단순하다. 그는 Paul Graham의 메이커/매니저 스케줄 프레임워크에서 말하는 메이커 모드에 매일 진입하기 위해, 오후 시간 전체를 구조적으로 확보한다. 이 시간 동안 그는 평균 4~6개의 포어그라운드 에이전트를 동시에 구동한다. 각 에이전트는 tmux 세션으로 관리되며, 현재 터미널에는 braintrust-1부터 braintrust-4까지의 세션이 각각 UI와 서비스를 구동하며 독립적으로 실행되고 있다.
백그라운드 에이전트 솔루션도 탐색 중이지만, 복잡한 소프트웨어에서는 포트 충돌 등의 문제로 완전한 격리가 어렵다는 점을 인정한다. 단순한 SaaS 웹앱 수준에서는 이미 상업적으로 좋은 배경 에이전트 제품들이 존재하지만, Braintrust 수준의 복잡도를 가진 소프트웨어를 위한 솔루션은 아직 성숙하지 않았다. 많은 팀들이 이미 자체적인 내부 배경 에이전트 시스템을 구축하고 있으며, 심지어 두 달 된 스타트업도 백그라운드 에이전트 PR 시스템을 자체 개발했다는 사례를 언급한다. 포트 관리 문제와 관련해서는 Vercel의 Chris Tate가 출시한 Portless라는 도구가 로컬 머신의 포트 관리를 단순화해준다고 소개한다(원본 영상 쇼노트 링크 참조).
Evals — “무엇을(What)“을 정의하는 현대적 PRD
프로그래밍 패러다임의 전환 — How에서 What으로
Ankur는 머신러닝의 본질을 “프로그래밍을 How(어떻게)에서 What(무엇을)으로의 전환”으로 정의한다. 중학교 통계 시간의 선형 회귀(linear regression)를 예로 들면, 우리는 기울기와 y절편을 직접 지정하지 않는다. 대신 데이터 포인트(What)를 입력하면 모델이 스스로 How를 찾아낸다. 트랜스포머(Transformer) 아키텍처와 다음 토큰 예측 태스크도 동일한 철학에서 출발한다. 방대한 컴퓨팅 자원과 명확한 목표(다음 토큰 예측)만 주어지면, 모델이 스스로 How를 학습한다.
이 철학을 AI 제품 개발에 적용한 것이 바로 evals이다. Evals는 “이것이 성공의 모습”이라고 정의하는 방법론이며, Ankur는 이를 현대적 PRD(Product Requirements Document)라고 표현한다. 기존 PRD가 산문(prose) 형태로 성공을 기술하고 필요에 따라 예시를 추가하는 것과 마찬가지로, evals도 산문과 예시로 구성된다. 결정적인 차이는 그 예시(user story)들이 정량적으로 측정 가능한 형태로 인코딩된다는 점이다. 팀이 What을 정밀하게 정의할수록, 모델(또는 에이전트)이 스스로 How를 찾아낼 여지가 넓어진다.
Braintrust UI로 실전 Evals 구축하기
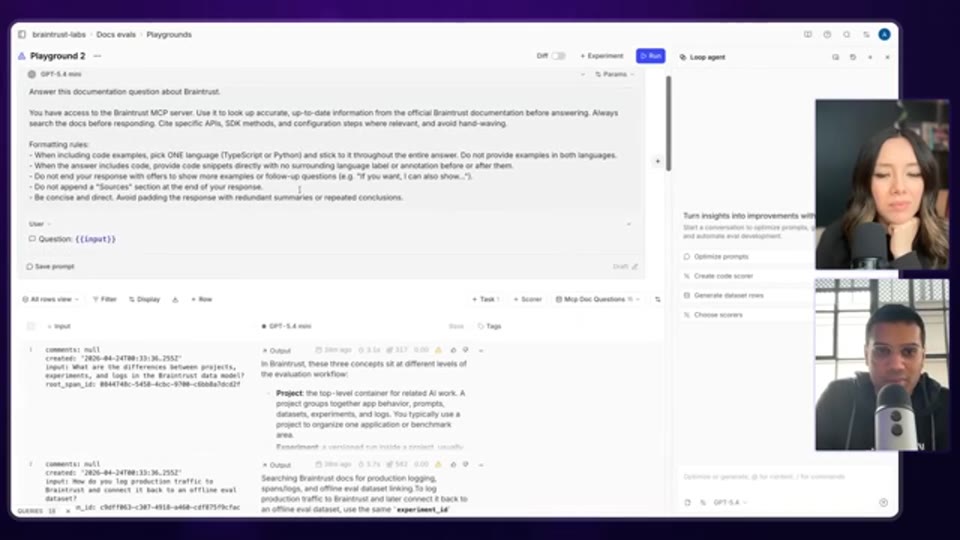
26:43 - Braintrust evals UI 데모 — 문서 질문 데이터셋 업로드, 초기 프롬프트, Braintrust MCP 서버 및 Context7 연결 완료 상태의 플레이그라운드 화면
실제 시연에서 Ankur는 Braintrust 문서에 관한 질문에 답하는 에이전트를 위한 프롬프트를 최적화하는 과정을 보여준다. 먼저 실제 사용자들이 문서에서 묻는 질문들을 데이터셋으로 구성하고, 초기 프롬프트를 작성한 뒤 GPT-5.4 mini 모델과 Braintrust MCP 서버를 연결했다. Context7처럼 문서를 AI를 위해 자동으로 인덱싱해주는 도구를 MCP로 연결하는 것도 가능하며, MCP를 끄고 모델이 해당 제품에 대해 이미 알고 있는 것만으로 테스트하는 방식도 지원된다.
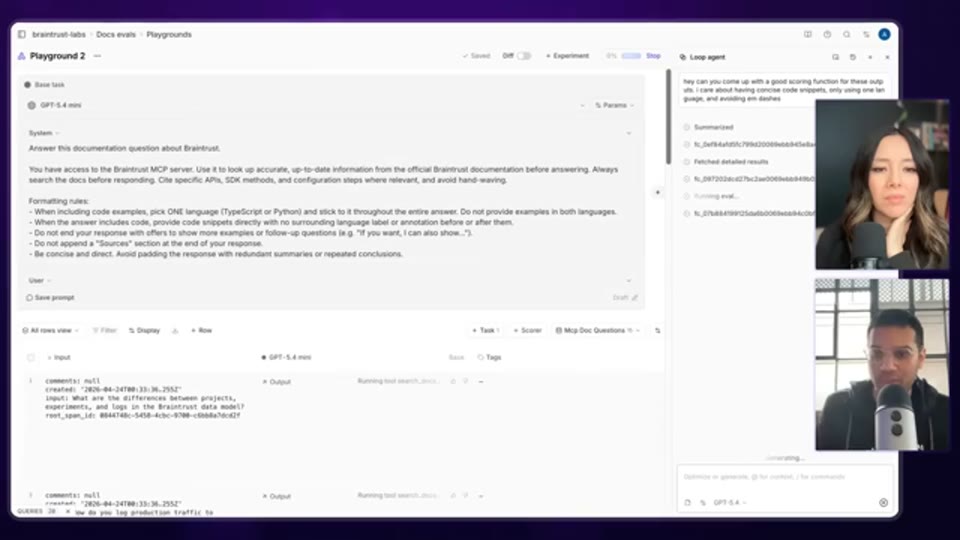
27:55 - GPT-5.4 모델이 기존 출력들을 분석하여 스코어링 함수(간결한 코드 스니펫·단일 언어·em dash 금지 등 기준)를 자동 생성하는 실시간 데모 화면
실행 결과를 하나씩 수동으로 검토하고 싶지 않기 때문에, 그는 모델에게 “이 출력들에 맞는 좋은 스코어링 함수를 만들어달라”고 요청한다. 구체적인 기준으로는 간결한 코드 스니펫 사용, 단일 언어 통일, em dash(—) 사용 금지 등을 지정했다. 스코어링 기준을 손으로 일일이 작성하는 것은 상당한 작업이기 때문에, 모델이 출력들을 분석하고 재실행하며 기준을 자동으로 도출하도록 하는 것이 핵심이다. 이후 모든 케이스에 대해 이 스코어링 함수가 적용되고, 결과를 개별로 보거나 집계 지표로 확인할 수 있다.
이 워크플로우의 또 다른 특성은 안전성이다. 에이전트가 bash를 통해 로컬 머신에서 구동될 때는 예상치 못한 파일 변경 등의 위험이 있지만, evals 플레이그라운드 내에서 데이터와 프롬프트만 다루는 에이전트는 잘못되어도 피해가 제한적이다. Ankur는 이처럼 에이전트가 로컬 환경 밖의 격리된 공간에서 높은 자율성으로 실행되는 패턴이 앞으로 더 많은 제품에서 나타날 것이라 전망한다.
바이브 체크(Vibe Check)와 정량적 평가의 결합 — David의 사례
흔한 대안은 한두 가지 예시만 직접 테스트해보고 일반화하는 것이다. Ankur는 이를 ‘바이브 체크(vibe check)‘라고 부르며, 완전히 나쁜 방법은 아니지만 결정적인 한계가 있다고 지적한다. 한두 케이스에서 잘 작동하도록 프롬프트를 조정하면 다른 케이스가 망가지는 ‘두더지 잡기(whack-a-mole)’ 현상이 발생하기 때문이다. 배포하고 나서야 다른 입력에서 실패한다는 것을 발견하게 되는 전형적인 패턴이다.
이에 대한 Braintrust의 해법은 David라는 디자이너를 중심으로 구성된 워크플로우다. David는 팀 내 최고의 ‘테이스트메이커(taste-maker)‘다. Ankur는 우선 방대한 evals를 실행해 정량적으로 품질을 개선하고, 자신의 판단으로도 결과가 좋다고 느껴질 때 수일에 한 번 David에게 바이브 체크를 요청한다. David가 지적한 내용을 새로운 스코어링 기준으로 인코딩하면서, 같은 실수를 반복하지 않도록 evals 체계를 점진적으로 발전시킨다.
이 대목에서 Claire가 중요한 통찰을 덧붙인다. 자신의 취향이나 전문성을 시스템으로 만들면 “내 자리를 AI가 대체하는 것 아닌가”라는 우려를 하는 사람들이 많다. 하지만 Ankur의 입장은 정반대다. David의 팔레트(취향)가 더 많은 결과물에 적용될 수 있게 되고, 그 결과 Braintrust가 더 높은 품질 기준에 더 많은 것을 맞출 수 있게 된다는 것이다. 전문가의 가치가 줄어드는 것이 아니라, 그 영향력이 확장되는 구조다.
CI(지속적 통합)에 대한 투자 — 속도의 진정한 원천
”조각(Carving)“으로서의 제품 개발
Ankur는 AI 에이전트가 대량의 코드를 생성하는 환경에서 오히려 CI(Continuous Integration) 파이프라인의 중요성이 더 높아졌다고 강조한다. 그는 이를 “제품 빌딩은 이제 건축(constructing)이 아니라 조각(carving)에 가깝다”는 비유로 설명한다. 기능이 너무 많고 버튼이 너무 많고 코드가 너무 방대한 것을 만드는 것은 오히려 너무 쉬워졌다. 진짜 어려운 작업은 불필요한 것을 제거하고 시스템이 더 잘 작동하도록 단순화하는 것이다.
UI에서 Command + F를 눌렀을 때의 동작을 예로 들면, 사용자는 단순히 현재 화면에 보이는 것을 검색하고 싶을 뿐이다. 하지만 수백 MB의 텍스트가 가상화되어 있고, 여러 스팬(span)을 가로지르며, 테이블까지 포함된 강력한 검색 구현을 만들었을 때 많은 사용자가 혼란을 느꼈다. Braintrust는 이런 경우 기능 자체를 단순화하거나 제거하는 방향을 선택한다. 불만의 근본 원인을 이해하면 복잡성 자체를 필요로 하지 않는 시스템을 만들 수 있다는 철학이다.
CI에 투자해야 속도가 난다
고속 출시 속도를 지속하기 위해 Braintrust는 CI 인프라에 적극적으로 투자한다. 속도가 막힌다고 느껴지면 더 많은 미완성 코드를 배포하는 것이 아니라, 잠시 멈추고 CI를 개선해 더 빠르게 움직일 수 있는 능력을 획득한다는 방침이다. Ankur는 모든 엔지니어가 이제 플랫폼 빌더가 됐다고 표현한다. 플랫폼 위에서 에이전트가 과거에 인간이 수동으로 하던 작업을 수행하는 구조이며, CI는 그 플랫폼의 핵심 인프라다.
AI 제품을 만드는 팀의 1순위 역할은 프롬프트 엔지니어링도, 에이전트 프레임워크 선정도, 데이터베이스 재작성도 아니다. 실세계 데이터를 evals로 변환하는 피드백 루프 파이프라인을 구축하는 것이다. 이 파이프라인이 없으면 어떤 개선도 검증할 수 없고, 어떤 배포도 자신 있게 할 수 없다. CI가 소프트웨어 엔지니어링에 주는 것이 바로 그 피드백 루프다.
마무리 / 핵심 정리
이 에피소드를 관통하는 핵심 메시지는 “결과(What)를 명확히 정의하면 AI가 방법(How)을 찾아낸다”는 원칙이다. 데이터베이스 쿼리 최적화든, AI 제품의 응답 품질이든, 이 원칙은 동일하게 적용된다. Ankur Goyal의 접근법이 주목받는 이유는 단순히 AI를 잘 활용하기 때문이 아니라, 엄밀한 실험 설계와 정량적 피드백 루프를 갖추었기 때문이다.
에이전트 라인은 계속 올라가고 있다. 앞으로 모델이 더욱 발전할수록 인간 엔지니어의 역할은 “무엇이 성공인지 정의하는 사람”으로 더욱 집중될 것이다. 엔지니어링 리더에게 남겨진 과제는 이 변화에 어떻게 대비할지, 그리고 팀이 에이전트 라인을 위로 밀어올릴 수 있는 환경을 어떻게 구축할지에 있다. Ankur의 조언은 명확하다: CI에 투자하고, evals 파이프라인을 만들고, 코드를 직접 쓸 시간을 구조적으로 확보하라.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | How this startup uses AI agents to eliminate bugs and optimize infrastructure |
| 채널 | How I AI |
| 출연 | Ankur Goyal (CEO, Braintrust) / Claire Vau (호스트) |
| 리포트 작성 | 2026-06-15 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- How agent o11y differs from traditional o11y — Phil Hetzel, Braintrust
- CD Is Dead, Agents Need Continuous Compute and Computers — Hugo Santos and Madison Faulkner
- The maturity phases of running evals — Phil Hetzel, Braintrust
- Does GenAI belong to data scientists — Phil Hetzel, Braintrust
- Multiplayer agentic engineering — Arjun Singh, Superconductor