네 가지 AI 에이전트, 실제 과제에서 무엇이 달랐나
원본 영상: I tested 4 AI agents on 9 real tasks. Here’s who won.
채널: How I AI
개인용 에이전트를 실제 일에 써 보다
How I AI의 진행자는 개인용 AI 에이전트에 피로감을 느낀다는 말로 비교를 시작한다. 이번에는 Dot, Grokbot, Muse, Claude Duet에 아홉 가지 실제 과제를 맡겨 결과를 살펴본다. Slack 답장 작성, 버그 수정, 썸네일 제작, 받은편지함의 할 일 정리처럼 평소 사용하는 작업이 비교의 중심이다.
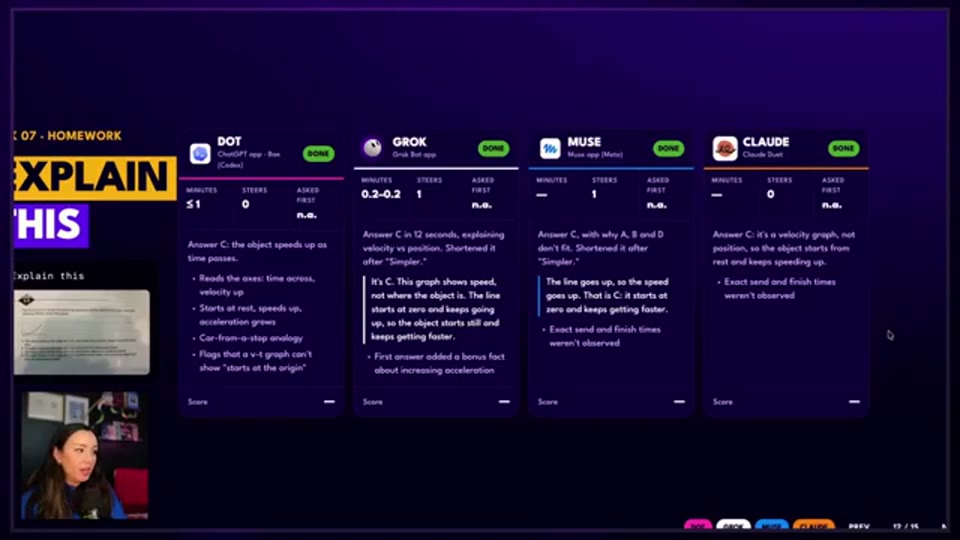
24:07 - 네 에이전트가 모두 맞힌 숙제 설명 과제의 비교
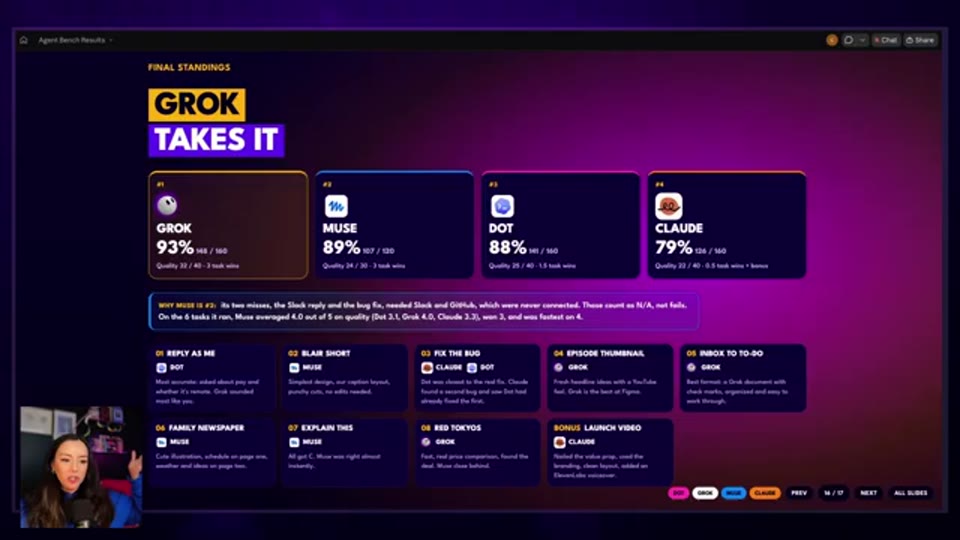
30:19 - 개인용 에이전트 비교의 최종 결과 발표
영상에서 눈에 띄는 것은 과제마다 달라지는 평가 기준이다. 답장에서는 사용자의 중요한 조건을 챙겼는지, 영상에서는 디자인이 마음에 드는지, 할 일 정리에서는 결과를 쓰기 편한 형태로 전달했는지가 중요하게 다뤄진다.
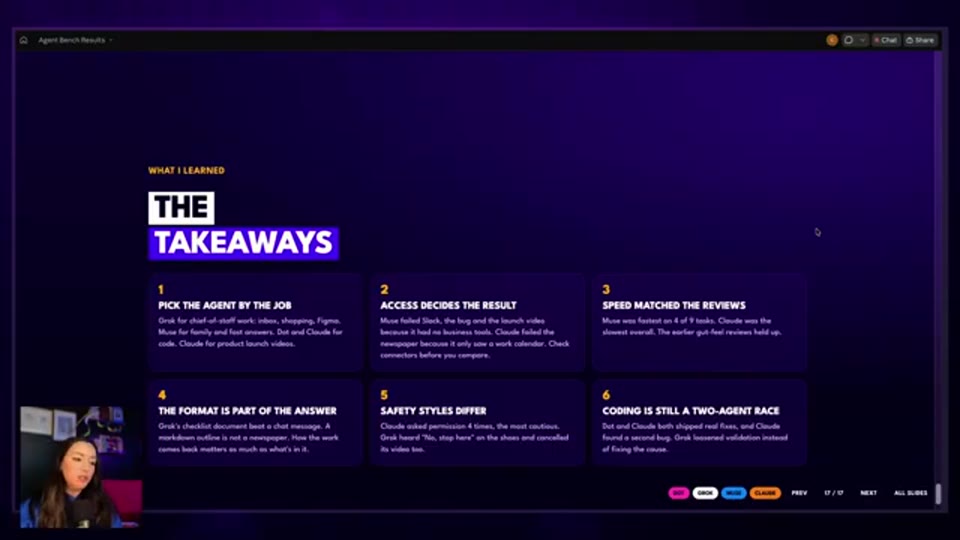
32:39 - 업무와 생활 용도를 구분한 에이전트 선택 기준
비교를 구성한 방식과 실행 조건
진행자는 각 에이전트에 자신을 위해 수행하는 주요 작업 열 가지를 물었다. 그 결과를 Claude에 모아 비교 방식을 구성했고, 최종적으로 아홉 가지 과제를 시험했다.
실행에는 다른 에이전트의 컴퓨터 사용 기능도 활용했다. Claude가 Dot을 조작하고, Codex가 Claude Duet·Grokbot·Muse를 조작하는 방식이었다. 따라서 비교 대상뿐 아니라 이를 실행하는 도구에도 차이가 있었다.
진행자는 에이전트들이 같은 스킬에 접근하도록 조건을 맞추려 했다. 하지만 Muse에는 여러 업무 도구를 연결하지 않은 상태였다. 평소 Muse를 업무용으로 사용하지 않았기 때문이라는 설명이다. 이 연결 상태는 업무 과제의 결과를 해석할 때 함께 고려할 조건이다.
04:29 - 평소 사용하는 말투의 짧은 요청문으로 비교 과제를 준비한 과정
과제별로 드러난 강점
Slack 답장: 사용자가 중요하게 여기는 조건
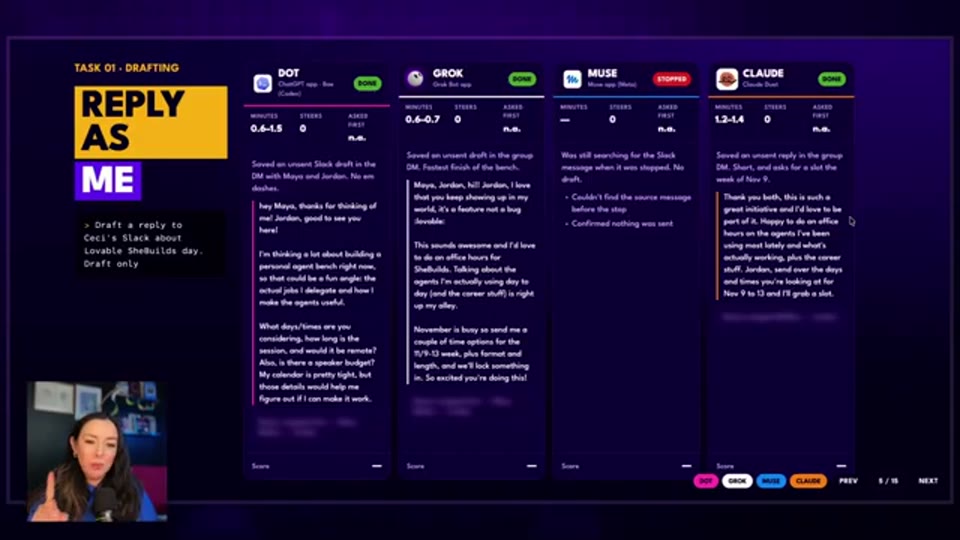
Slack 답장 비교에서는 보수와 원격 진행 여부를 묻는 내용이 주목받았다. 진행자는 자신이 시간을 들여 하는 일에 보수를 받는 것을 중요하게 여긴다고 설명한다. 답장을 자연스럽게 쓰는 데 더해, 사용자가 실제로 확인하고 싶은 조건을 담는지가 평가에 영향을 줬다.
영상 편집: 진행자가 선호한 디자인은 Muse
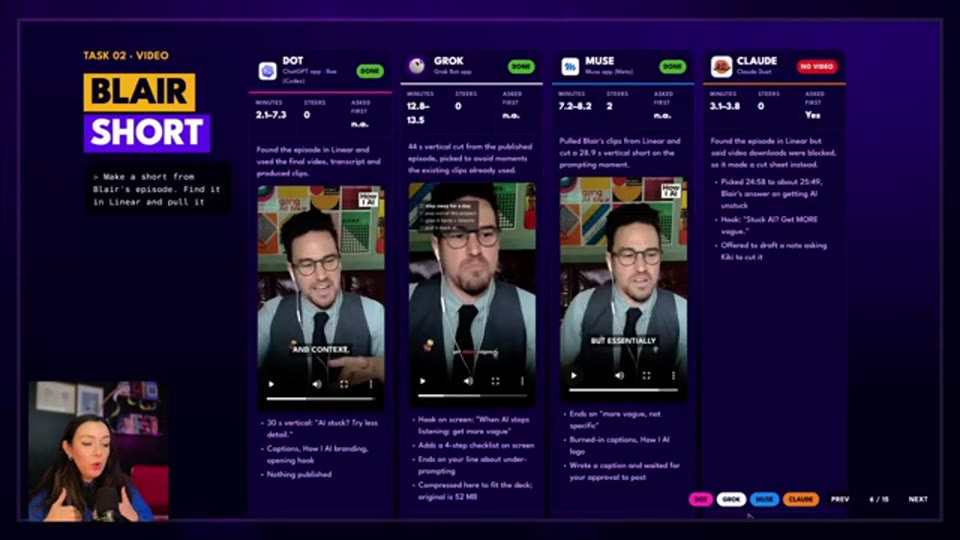
영상 결과물의 디자인에서는 Muse가 진행자의 선택을 받았다. 진행자는 Muse의 결과가 간결하다는 점을 언급하며 가장 마음에 든다고 평가했다. 이 대목은 영상 편집 결과에 대한 진행자의 디자인 선호를 보여 준다.
버그 수정: 추가 문제를 발견한 Claude Duet
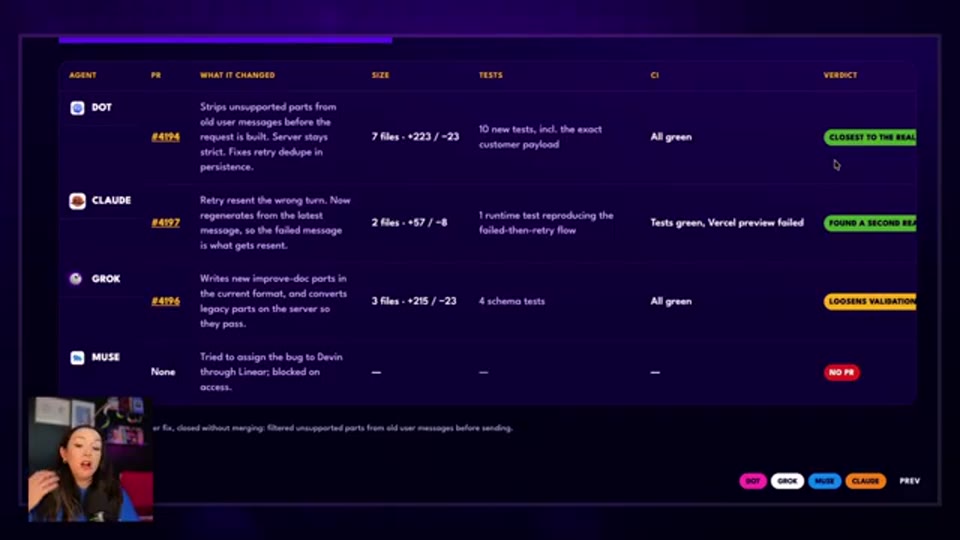
Sentry의 버그를 수정하는 과제에서는 Claude Duet이 기존에 발견하지 못했던 두 번째 버그를 찾아낸 점이 좋은 평가를 받았다. 요청받은 문제를 처리하는 것에 더해, 추가 문제를 발견한 것이 평가에 반영됐다.
썸네일 제작: Grokbot의 창의적인 제안
썸네일 비교에서 진행자는 기존 템플릿을 활용한 결과가 충분히 창의적이지 않았다고 말하며 Grokbot을 승자로 꼽았다. 썸네일과 헤드라인 아이디어에 대한 선호가 드러나는 대목이다.
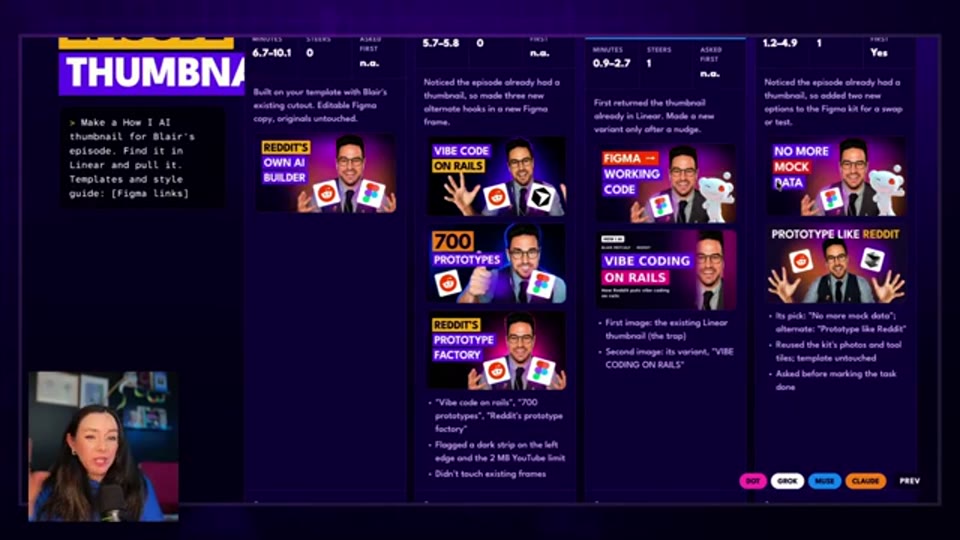
진행자는 자신의 사용 경험에서도 Grokbot의 Figma 활용을 매우 높게 평가했다. 이는 진행자가 경험한 작업과 결과물에 대한 평가다.
받은편지함 정리: 할 일을 전달하는 형식
받은편지함에서 할 일을 찾는 과제에서는 결과를 전달하는 방식이 차이를 만들었다. 진행자는 Grokbot이 할 일을 가장 좋은 형식으로 제공했다고 평가했다. 필요한 항목을 찾아내는 능력뿐 아니라, 사용자가 그 결과를 받아 활용하기 편한지도 중요하게 본 것이다.
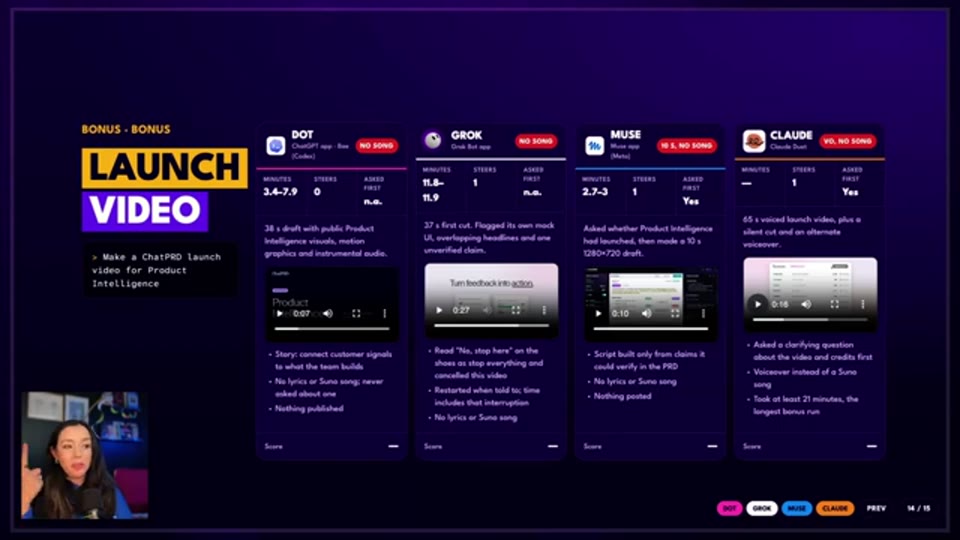
29:09 - 제품의 가치 전달, 브랜드 활용, 레이아웃 완성도에 대한 평가
가족 신문: Muse의 결과물에 대한 호평
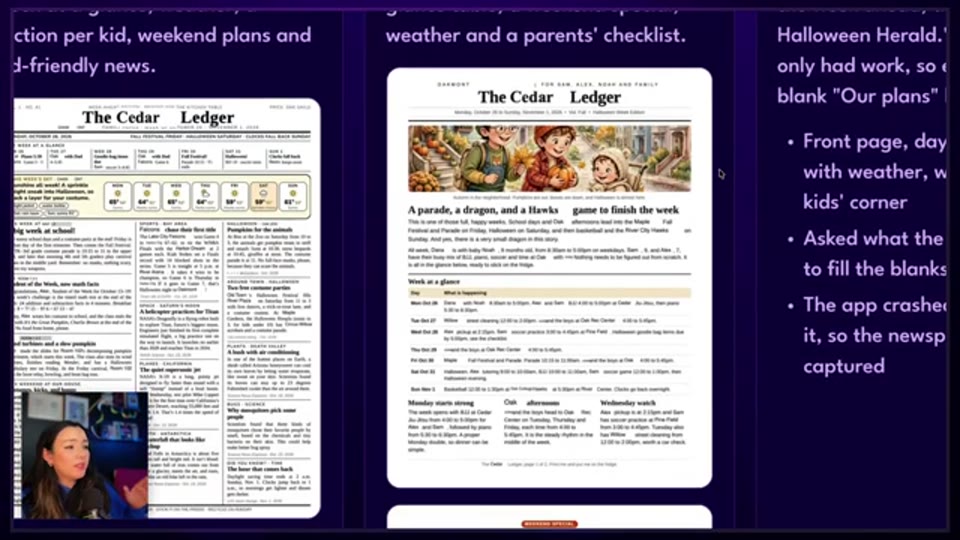
가족 신문 과제에서도 Muse가 좋은 반응을 얻었다. 진행자는 Muse가 가족 신문을 매우 잘 만들었다고 말하며, 생성된 이미지도 긍정적으로 평가했다. 가족을 위한 결과물에서는 내용과 함께 친근한 표현과 구성도 만족도에 영향을 줬다.
최종 점수와 함께 볼 평가 내용
최종 평가에서는 Grokbot에 93%, Claude Duet에 79%라는 수치가 제시됐다. 다만 진행자도 점수가 어떻게 계산됐는지 정확히 모르겠다고 말했다. 이 수치를 명확한 산식에 따른 정확도나 완료율로 단정하기보다는, 과제별 평가와 함께 읽는 편이 적절하다.
Claude Duet에 대해서는 속도가 매우 느렸다는 평가와 버그를 가장 정확하게 수정했다는 평가가 함께 나왔다. 한 에이전트 안에서도 속도와 결과의 정확성에 대한 판단이 달랐던 셈이다.
이 비교에서 드러나는 선택 기준은 구체적이다. 답장에는 사용자에게 중요한 조건이 담겨야 하고, 썸네일에는 새로운 아이디어가 있어야 하며, 할 일은 활용하기 좋은 형태로 전달돼야 한다. 여기에 업무 도구의 연결 상태와 과제별 결과물에 대한 선호가 더해졌다. 종합 점수만큼이나 자신이 맡기려는 일에서 어떤 결과가 나왔는지를 살펴볼 만한 비교다.
출처
How I AI — I tested 4 AI agents on 9 real tasks. Here’s who won.