에이전트를 더 이상 직접 돌볼 필요가 없도록 — 컨텍스트 엔진이 답이다
📺 원본 영상: Stop babysitting your agents… — Brandon Walsenuk, Unblocked 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-27 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Unblocked의 Brandon Walsenuk은 AI 에이전트 시대의 핵심 문제를 하나의 문장으로 정리한다. CLI에서 에이전트를 실행하는 순간, 그것은 마치 “방금 채용된 천재 소프트웨어 엔지니어”와 같다. 역량은 뛰어나지만 조직에 대해서는 아무것도 모르는, 완전한 제로 컨텍스트(Zero Context) 상태다. 이 강연은 그 문제를 해결하기 위한 세 가지 잘못된 접근법(신화)을 반박하고, Unblocked가 컨텍스트 엔진(Context Engine)을 직접 구축하면서 뼈아프게 배운 세 가지 교훈을 공유하며, 실제 동작하는 오픈소스 도구 데모로 마무리된다.
우리 모두가 컨텍스트 엔진이 되어버린 현실
과거에는 엔지니어 본인이 모든 것을 알고 있었다. 코드의 전체 구조, 비즈니스 도메인, 팀 내 의사결정 흐름까지 — 모두 개발자의 머릿속에 내재화되어 있었다. 그런데 에이전트 시대가 열리면서 상황이 묘하게 역전되었다. 이제 엔지니어 본인이 에이전트를 위한 컨텍스트 엔진 역할을 맡게 된 것이다. 에이전트가 무언가를 실행할 때마다 필요한 배경 지식을 사람이 직접 주입해야 하는, 일종의 “에이전트 돌보기” 상태가 고착화되고 있다.
Brandon은 이 현상을 인간이 회사에 입사하는 과정에 빗대어 설명한다. 신입 첫날에는 아무것도 모르지만 매우 똑똑하다. 시간이 지나면서 PR을 올리고, 거절당하고, 팀원을 만나고, 마켓을 이해하면서 비로소 조직의 맥락을 쌓아간다. 그리고 결국에는 좋은 질문을 던질 줄 알고, 정확한 정보를 취합하며, 불필요한 것은 솎아낼 수 있는 진정한 시니어 엔지니어로 성장한다. 에이전트도 정확히 같은 과정이 필요한데, 지금은 그 과정 전체를 사람이 대신 수행해주고 있다는 것이 문제의 본질이다.
Brandon은 이것을 “컨텍스트 성숙도 사다리(Context Maturity Ladder)“라는 개념으로 설명한다(이 프레임워크는 Bassem Elias — 강연에서는 “Basim Eldis”로 언급됨, STT 변환 오류일 가능성 있음 — 의 연구에서 발전시킨 것이다). 대부분의 팀은 아직 “사람이 직접 컨텍스트 엔진이 되는” 초기 단계에 머물러 있다. 이 사다리를 올라가기 위한 다음 단계는 “큐레이션된 컨텍스트(Curated Context)” 레이어를 만드는 것이다. 많은 팀이 CLAUDE.md, agents.md 파일이나 정적 저장소를 만들어 회사의 핵심 정보를 에이전트가 접근할 수 있는 형태로 쌓기 시작한다. 하지만 이 정적 콘텐츠들은 누군가가 지속적으로 유지 관리해야 하고, 무엇보다 실시간 런타임 데이터를 담을 수 없다는 구조적 한계를 가진다. 이 사다리의 정점, 즉 Codex와 같은 솔루션이 도달하고자 하는 곳은 완전히 자율적인 컨텍스트 엔진이다.
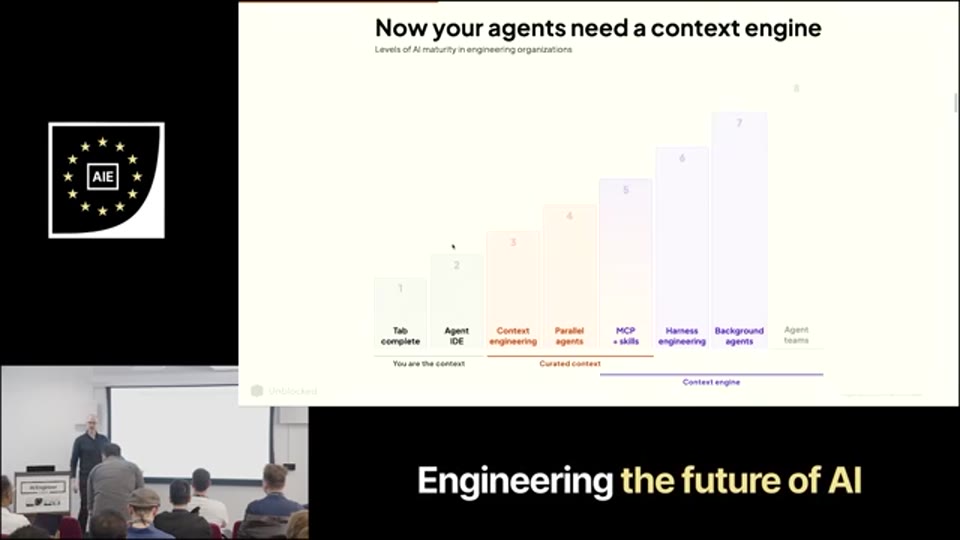
02:10 - 컨텍스트 성숙도 사다리(Context Maturity Ladder) 슬라이드 — ‘사람이 직접 컨텍스트 엔진’ 단계부터 완전 자율 에이전트 단계까지의 레이어 구조 시각화
컨텍스트 엔진이란 무엇인가
컨텍스트 엔진은 단순한 문서 저장소가 아니다. 런타임에 에이전트로부터 쿼리가 들어오면 — 예를 들어 “이 기능을 어떻게 구현하면 되죠?” — 엔진은 회사 전체의 지식 코퍼스(Knowledge Corpus)를 대상으로 정적 소스와 실시간 데이터를 동시에 수집한다. SaaS 앱, 다양한 시스템, 수많은 데이터 저장소를 가로질러 철저하게(exhaustively) 탐색하고, 거기서 실제로 중요한 것들만 추려서 토큰 최적화된 — 즉 작고 압축된 — 응답을 에이전트에게 전달한다. 에이전트는 이 패킷을 받고 나서야 비로소 자신의 실행 단계를 시작한다.
Brandon이 강조하는 핵심 원리는 “좋은 컨텍스트를 먼저 제공하면, 이후의 모든 에이전트 판단과 행동이 훨씬 정확해진다”는 것이다. 예를 들어, 새로운 인티그레이션 작업을 시작하기 전에 “우리 팀은 팩토리 패턴을 사용한다”, “이런 컨벤션을 따른다”는 내용이 담긴 연구 패킷을 에이전트에게 미리 제공하면, 에이전트는 코드베이스를 무작정 grep하지 않고도 정확한 방향으로 배경 작업을 실행할 수 있다. 이는 토큰 효율을 높이고 작업 완료 속도를 높이며, 궁극적으로 “처음부터 다시 만든 잘못된 코드”라는 결과물을 방지한다.
Andrej Karpathy(강연에서는 STT 오류로 “Kaparthi”로 발음됨)의 말을 빌리자면, 지금 이 문제는 지능의 부재가 아니다. 에이전트는 이미 충분히 영리하다. 문제는 이해(Understanding)의 부재다. 접근 권한(Access)을 늘리는 것과 진정한 이해를 제공하는 것은 완전히 다른 차원의 문제다.
04:42 - Andrej Karpathy 인용 및 ‘Access vs Understanding’ 대비 슬라이드 — 접근 권한이 아닌 이해가 핵심이라는 주장
컨텍스트에 대한 세 가지 신화
06:00 - 컨텍스트에 대한 3가지 신화 요약 슬라이드 시작 — Naive RAG, MCP 연결, 대형 컨텍스트 윈도우
신화 1: 문서에 Naive RAG를 적용하면 컨텍스트가 해결된다
많은 팀이 첫 번째로 시도하는 접근법이 Naive RAG다. 문서들을 데이터 스토어에 넣고, 에이전트가 그것을 탐색하게 한다. 하지만 Brandon은 이것이 충분하지 않은 이유를 “검색 만족(Satisfaction of Search)“이라는 현상으로 설명한다. 이 개념은 원래 방사선 의학에서 온 것으로, 방사선과 전문의가 X-ray에서 하나의 이상 소견을 발견하는 순간 더 이상 스캔을 이어가지 않는 경향을 가리킨다. 이미 “답”을 찾았다고 착각하기 때문이다. 에이전트도 정확히 같은 방식으로 실패한다. Zendesk 통합을 요청하면 에이전트는 MCP를 호출하고, 처음 발견한 데이터 패턴을 “이게 맞겠지”라고 판단한 뒤 탐색을 멈춰버린다. 더 깊이 파고들지 않기 때문에 올바른 구현 패턴을 찾지 못하고, 결과물을 받아본 엔지니어는 “아니, 그게 아니야”를 반복하며 다시 에이전트를 직접 돌보는 doom loop에 빠지게 된다.
신화 2: MCP를 충분히 연결하면 된다
MCP(Model Context Protocol)는 에이전트가 다양한 시스템에 접근할 수 있게 해주는 파이프(Pipe)다. 하지만 파이프는 접근(Access)을 제공할 뿐, 이해(Understanding)와 추론(Reasoning)을 제공하지 않는다. 회사의 모든 시스템 접근 권한을 가진 신입 엔지니어를 떠올려보라. 그 신입은 자신이 무엇을 모르는지조차 모른다. 어딘가에 기존 서비스가 이미 존재하는데, 에이전트는 그 존재 자체를 인지하지 못한 채 처음부터 코드를 짠다. 결국 시니어 엔지니어가 “야, 이미 그 서비스 있는데?”라며 PR을 거절하는 상황이 반복된다. Brandon이 직접 진행한 실험에서, MCP 접근만 갖춘 Naive 실행은 코드 컴파일에는 성공했지만, 시니어 엔지니어의 평가로는 “이대로 배포했으면 시스템 전체가 망가졌을” 수준의 결과물이었다.
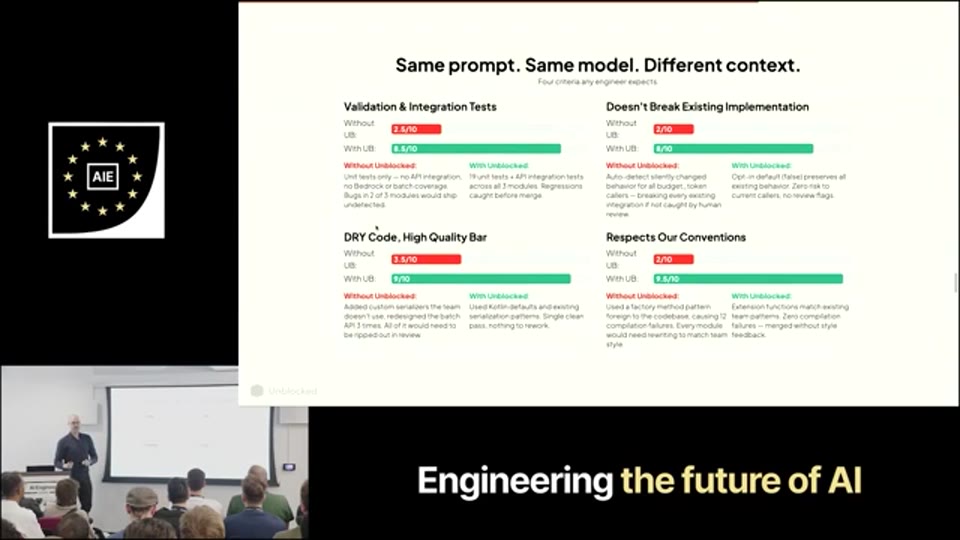
11:48 - Claude가 생성한 Naive MCP 실행 vs 컨텍스트 엔진 적용 비교 바 차트 — 엔지니어링 품질 지표별 차이
신화 3: 컨텍스트 윈도우가 100만 토큰이 되면 해결된다
많은 이들이 꿈꾸던 거대한 컨텍스트 윈도우는 이미 실현되었다. 하지만 실제로 그것을 가득 채우고 에이전트에게 추론을 요청해본 사람이라면 알겠지만, 에이전트는 그 방대한 데이터를 제대로 처리하지 못한다. 엔티티(Entity)와 관계(Relationship) 구조 없이 날것의 텍스트가 수백만 토큰 분량 쌓여있으면, 에이전트는 그 안에서 실제로 중요한 것을 추려내지 못한다. Brandon은 설령 컨텍스트 윈도우가 1억 토큰에 달하더라도 컴퓨팅 제약으로 인해 여전히 충분하지 않을 것이라고 주장한다. “월도를 찾아라”처럼 특정 바늘 찾기 문제에는 유용하지만, 복잡한 코드베이스를 이해하고 조직의 패턴을 추론하는 데에는 구조화된 컨텍스트가 필수적이다. 그리고 에이전트 세션이 종료되는 순간, 그 모든 grep 비용과 탐색 결과는 사라진다. 다음 세션에서 처음부터 다시 반복해야 하는 것이다.
컨텍스트 엔진이 갖춰야 할 여섯 가지 핵심 역량
Brandon은 Unblocked에서 구축한 컨텍스트 엔진의 여섯 가지 핵심 차별점을 제시한다. 이것들은 단순한 마케팅 용어가 아니라, 실제 프로덕션 환경에서 직접 부딪히며 얻어낸 설계 원칙들이다.
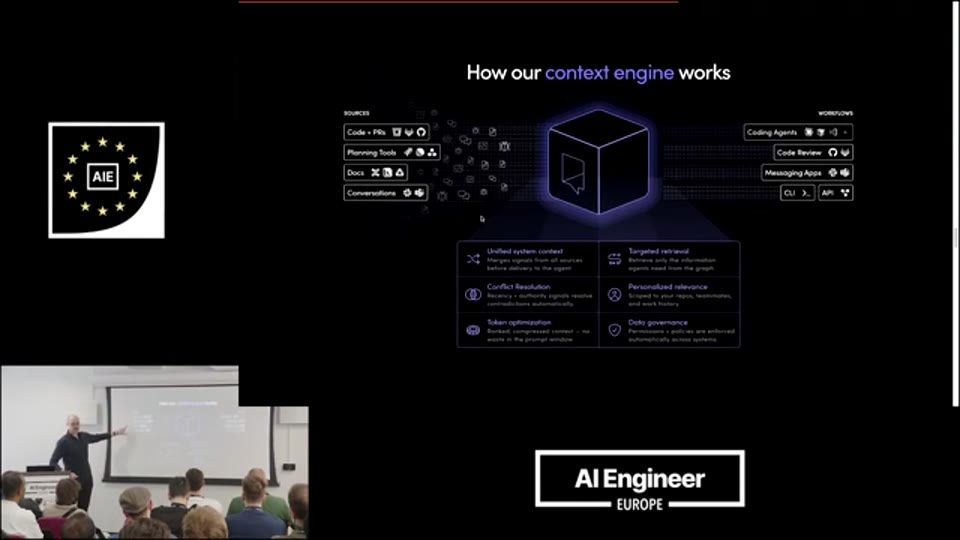
10:17 - 컨텍스트 엔진 아키텍처 다이어그램 — 데이터 소스 인제스트, 6개 핵심 역량, 에이전트/인간 출력 인터페이스
첫째, **통합 시스템 컨텍스트(Unified System Context)**다. 엔진은 조직의 모든 시스템 오브 레코드(System of Record)를 가로질러 추론할 수 있어야 한다. SaaS 앱, 코드 저장소, 협업 도구 등 분산된 데이터 소스를 단일 컨텍스트로 통합해야 한다. 둘째, **타겟 검색(Targeted Retrieval)**이다. Naive RAG와 달리, 쿼리의 의도를 파악하고 실제로 관련 있는 부분만을 정확하게 가져와야 한다. 셋째, **충돌 해결(Conflict Resolution)**이다. 코드베이스와 Slack 대화가 서로 다른 사실을 말하고 있을 때, 엔진이 어느 쪽이 진실인지 판단해야 한다. 메인 브랜치의 코드가 특정 방식으로 구현되어 있는데, CTO가 Slack 스레드에서 “그건 잘못 구현된 거야”라고 말한 경우를 생각해보라. 소셜 그래프(Social Graph)를 통해 CTO의 발언이 더 높은 신뢰도를 가진다고 추론하고, 에이전트에게 CTO의 판단이 현재의 진실임을 전달하는 것이 이 역할이다.
넷째, **데이터 거버넌스(Data Governance)**다. 조직이 20명을 넘어서면 데이터 접근 제어가 필수가 된다. Slack DM이나 비공개 채널의 내용은 해당 당사자에게만 제공되어야 하며, 다른 사람이 같은 질문을 해도 절대 노출되어서는 안 된다. 이것이 컨텍스트 엔진이 MCP 위에서 OAuth 모델을 통해 제공되어야 하는 이유다. 다섯째, **개인화된 관련성(Personalized Relevance)**이다. 소셜 그래프가 핵심 피벗 포인트 역할을 한다. 같은 “Zendesk 통합 방법”을 물어도, 질문자가 어떤 코드베이스에서 주로 작업하는지, 누구와 협업하는지, 어떤 PR 히스토리를 갖는지에 따라 응답이 달라져야 한다. 여섯째, **토큰 최적화(Token Optimization)**다. 좋은 컨텍스트 엔진은 에이전트가 불필요한 grep 작업을 반복하지 않게 막는 것만으로도 자동으로 토큰을 절약한다. 더 나아가, 엔진이 모든 데이터 소스를 추론한 후 에이전트에게 꼭 필요한 내용만 압축해서 전달함으로써 추가적인 효율화가 가능하다.
직접 겪은 세 가지 뼈아픈 교훈
교훈 1: 접근(Access)이 아닌 이해(Understanding)를 최적화해야 한다
Unblocked 팀도 초기에는 “모델이 알아서 처리할 거야, 에이전트가 알아서 파악하겠지”라고 낙관했다. 더 많은 도구 접근 권한을 주면 모델이 스스로 reasoning해서 결론을 낼 거라는 믿음이었다. 하지만 그 믿음은 틀렸다. 도구 접근 권한을 아무리 늘려도, 에이전트가 그 데이터를 진정으로 이해하고 추론하지 못하면 아무 소용이 없다. 이 교훈은 Anthropic이 Claude 에이전트와 함께 발표한 방향성과도 일치한다. 컨텍스트는 반드시 에이전트 실행 하네스(Harness) 안으로 구조화되어 들어와야 하며, 그 방법이 바로 컨텍스트 엔진이다.
교훈 2: 충돌을 숨기지 말고 해결해야 한다
초기 Unblocked 엔진은 여러 소스에서 충돌하는 정보를 발견할 때, “어차피 모델이 판단하겠지”라는 생각으로 그냥 에이전트에게 넘겼다. 결과는 처참했다. 에이전트는 충돌하는 정보들 중 하나를 임의로 선택했고, 그 선택이 틀린 경우가 빈번했다. 충돌 해결은 반드시 컨텍스트 엔진 레이어에서 처리해야 하는 중요한 문제다. 아직 완전히 해결된 문제는 아니지만, 소셜 그래프를 통해 발언자의 조직 내 권위를 추론하는 것이 현재 Unblocked가 채택한 핵심 기법이다.
교훈 3: “좋은 답변”을 캐싱하면 안 된다
피드백 루프를 통해 좋은 답변이 나왔을 때, 팀은 레이턴시 최적화를 위해 그 답변을 캐싱하기 시작했다. 겉보기엔 합리적인 결정처럼 보였다. 하지만 이것은 치명적인 실수였다. 문서를 작성하는 바로 그 순간부터 그 문서는 이미 낡아가기 시작한다는 것을 떠올려보라. 어제의 정확한 답변은 오늘 거짓말이 될 수 있다. 코드베이스는 24시간 안에도 바뀐다. 같은 질문에 캐시된 답변을 돌려준다면, 엔진은 엔지니어에게 이미 낡은 정보를 마치 최신 사실인 양 전달하게 된다. 일부 안정적인 질문들의 경우에는 캐싱이 무방하겠지만, 일반적인 원칙으로는 레이턴시 최적화를 위한 답변 캐싱을 강력히 권장하지 않는다.
AI 선도 팀들이 컨텍스트 엔진을 활용하는 방식
컨텍스트 엔진은 에이전트 코딩 보조에만 쓰이는 것이 아니다. Brandon은 Unblocked 고객사들이 다양한 방식으로 컨텍스트 엔진을 활용하고 있음을 소개한다.
그 중 가장 흥미로운 사례 하나는 “Ask Engineering” 채널이다. 지원팀, 영업팀 등 비개발 부서에서 개발팀 채널에 “지금 프로덕션에 뭐가 돌아가고 있어?” 같은 질문을 던지면, 컨텍스트 엔진이 자동으로 질문을 감지하고 신뢰도를 평가한 뒤 자동으로 답변한다. 사람이 직접 답할 필요도, 티켓을 생성할 필요도 없다. 이 자동 응답 메커니즘은 에이전트가 데이터를 요청하는 방식과 정확히 동일하게 작동한다. 이 외에도 티켓 보강(Ticket Enrichment), 트리아지(Triage), 인시던트 관리, 코딩 에이전트 지원 등 다양한 용도로 활용된다. 그리고 팀이 성숙해지면 엔진을 팀 특성에 맞게 커스터마이징한다. 표준 운영 절차(SOP)를 반영한 스킬을 추가하고, 자체 워크플로우를 구축하며, 이 모든 커스텀 에이전트들이 동일한 컨텍스트 엔진을 공유함으로써 엄청난 레버리지를 얻는다.
데모 1: 소셜 그래프 시각화 도구
💡 [영상 참조] 강연자는 이 시점에서 팀의 엔지니어링 조직을 시각화한 소셜 그래프 도구를 직접 시연합니다. 📺 원본 영상에서 확인하세요.
Brandon이 컨퍼런스 워크숍에서 팀들과 함께 만들고, 강연 당시 오픈소스 공개를 앞두고 있던 도구는 컨텍스트 엔진의 핵심 컴포넌트인 소셜 그래프 생성기다. 코드 저장소를 가리키면 알고리즘이 절차적으로(procedurally) 그래프를 생성한다. 노드의 크기는 코드 기여량을 나타내며, 엣지는 협업 관계를 시각화한다. Anthropic API 키를 사용한 레이블링을 통해 각 엔지니어가 전문화된 영역 — libs, services 등 — 도 자동으로 파악된다. 이 외에도 협업 히트맵, 동료 테이블, 코드 리뷰 네트워크 등 다양한 시각화를 제공한다.
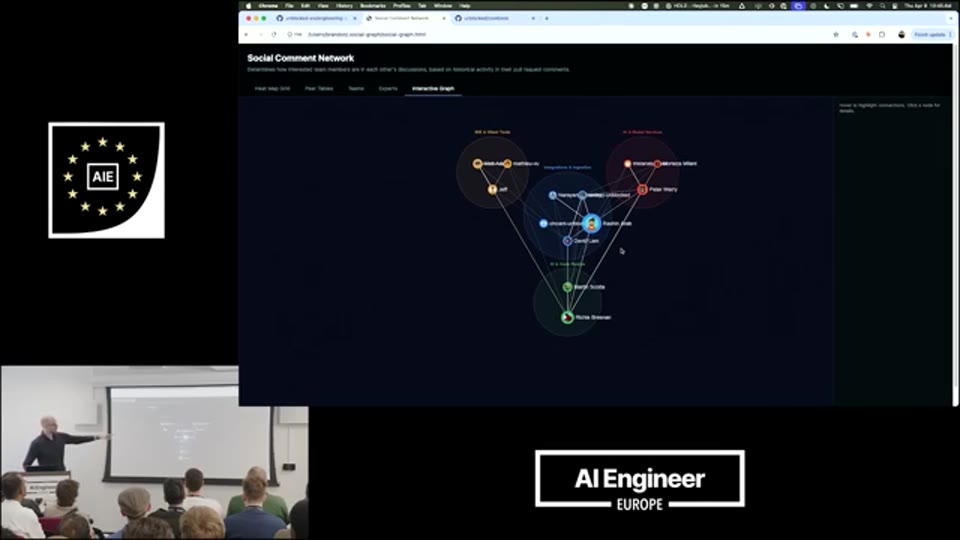
15:34 - Unblocked 엔지니어링 팀 소셜 그래프 시각화 — 기여량 기반 노드 크기, 협업 관계 엣지, 전문 영역 레이블
이 그래프가 컨텍스트 엔진에서 갖는 가치는 명확하다. 어떤 엔지니어가 “Zendesk 통합” 방법을 물어볼 때, 엔진은 그 엔지니어의 소셜 그래프를 피벗 포인트로 삼아 그가 주로 작업하는 코드베이스, PR 히스토리, 함께 일하는 동료들의 정보를 바탕으로 개인화된 답변을 제공할 수 있다. 20,000명 규모의 대형 조직에서는 같은 질문이라도 질문자의 컨텍스트에 따라 전혀 다른 답변이 필요하다. 소셜 그래프는 그 차이를 만들어내는 핵심 데이터 구조다.
데모 2: MCP를 통한 컨텍스트 엔진 활용
💡 [영상 참조] 강연자는 이 시점에서 터미널(Ghostty) 환경에서 에이전트가 컨텍스트 엔진 MCP를 사용해 Zendesk 통합 계획을 수립하는 과정을 직접 시연합니다. 📺 원본 영상에서 확인하세요.
두 번째 데모에서 Brandon은 Unblocked 컨텍스트 엔진과 MCP로 연결된 에이전트에게 “Zendesk에 새로운 일급(First-class) 인티그레이션을 어떻게 만드나요?”라고 질문한다. 에이전트는 MCP의 형태(Shape)를 분석해 스스로 research task 도구를 선택하고, 적절한 쿼리를 구성한 뒤 effort: high 설정으로 심층 추론을 요청했다. 컨텍스트 엔진으로부터 연구 결과 패킷을 수신한 에이전트는 이후 정확한 위치에서 탐색(explore) 에이전트들을 실행하기 시작했다. 이것이 핵심이다. 연구 패킷이 먼저 들어왔기 때문에, 에이전트는 “어디를 봐야 하는지”를 알고 탐색을 시작한다.
결과로 생성된 계획서는 팩토리 패턴 등록, 라이브러리 모듈, 클라이언트 구현 등 실제로 중요한 요소들을 모두 담고 있었다.
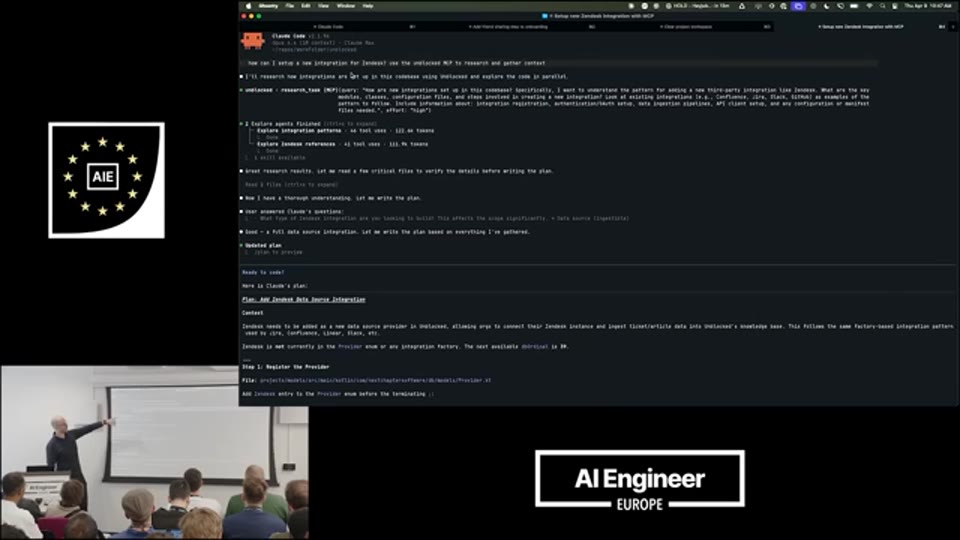
17:33 - 컨텍스트 엔진 MCP 연동 후 생성된 Zendesk 통합 계획서 — 팩토리 패턴, 라이브러리 모듈, 클라이언트 구조 포함
Brandon은 “완벽하진 않지만 몇 번의 추가 프롬프팅으로 완전히 맞출 수 있는 수준”이라고 평가하며, 시니어 엔지니어에게 PR을 냈을 때 “nitpick 하나 고치면 머지해도 된다”는 피드백을 받았다고 덧붙인다. 컨텍스트 엔진 활용의 가장 효과적인 패턴은 계획(Planning) 단계에서 엔진을 사용하고, 실행(Execution) 단계를 진행한 후, 코드 리뷰 단계에서 다시 엔진을 호출하는 것이다. 이 엔진은 특히 코드 리뷰와 계획 수립에서 강력한 성능을 발휘한다.
마무리: 에이전트가 써야 할 코드의 기준
Brandon이 이 강연에서 남기고 싶은 핵심 메시지는 단 하나다. 에이전트가 작성한 코드는, 수년간 그 팀에서 일해온 사람이 작성한 것처럼 느껴져야 한다. 그것이 지금 우리가 에이전트에게 기대해야 하는 수준이며, 그 기대를 실현하기 위한 가장 실용적인 기술적 경로가 컨텍스트 엔진이다. 에이전트에게 충분한 접근 권한을 주는 것을 넘어서, 에이전트가 진정으로 조직을 이해할 수 있도록 구조화된 컨텍스트를 제공하는 것 — 그것이 “에이전트 돌봄”에서 해방되는 길이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Stop babysitting your agents… — Brandon Walsenuk, Unblocked |
| 채널 | AI Engineer |
| 강연자 | Brandon Walsenuk (Unblocked) |
| 리포트 작성 | 2026-05-27 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Mergeable by default - Building the context engine to save time and tokens - Peter Werry, Unblocked
- Why More Context Makes Your Agent Dumber and What to Do About It — Nupur Sharma, Qodo
- CrabRAG - Why Automated Assistants Need Graph Memory, Not More Tokens — Stephen Chin, Neo4j
- RAG 어렵다고요? PDF 하나로 5분 만에 시작하는 법 (feat. 공원나연님)
- Skills are the New SDKs - Elvin Aghammadzada, DataRobot