The Prime Intellect Stack - Will Brown, Prime Intellect
📺 원본 영상: The Prime Intellect Stack — Will Brown, Prime Intellect
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-07-14
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 코드, 슬라이드 세부 내용은 포함되지 않을 수 있습니다.
개요
Will Brown은 Prime Intellect가 구축하고 있는 오픈 소스 AI 연구 인프라 스택을 “Open Superintelligence Stack”이라는 관점에서 설명한다. 이 강연의 중심은 모델을 단순히 가져다 쓰는 단계를 넘어, 실제 제품과 업무 흐름에서 발생하는 신호를 바탕으로 모델을 지속적으로 개선하는 포스트 트레이닝(Post-training) 체계를 어떻게 만들 것인가에 있다.
강연은 특히 Verifiers와 PrimRL이라는 두 라이브러리에 초점을 맞춘다. Verifiers는 평가와 강화학습을 위한 환경(Environment)을 구성하는 도구이고, PrimRL은 대규모 비동기 강화학습(Asynchronous Reinforcement Learning)을 실행하기 위한 학습 프레임워크다. Brown은 이 둘을 분리된 도구가 아니라, 평가, SFT(Supervised Fine-Tuning), RL, distillation, 배포 후 반복 개선까지 이어지는 하나의 모델 개선 루프로 제시한다.
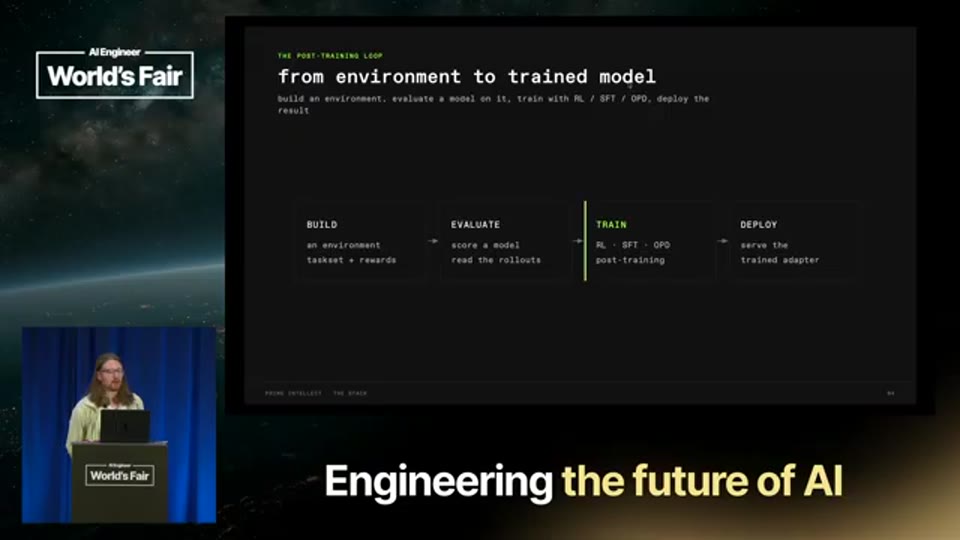
07:32 - evaluation에서 SFT, RL, distillation, deployment로 이어지는 post-training flywheel을 설명하는 구간
모델을 가져다 쓰는 시대에서 모델을 개선하는 시대로
Prime Intellect의 문제의식은 명확하다. 오픈 소스 모델은 빠르게 좋아지고 있지만, 실제 기업이 원하는 것은 범용 모델 자체가 아니라 자기 제품, 자기 데이터, 자기 워크플로우에 더 잘 맞는 모델이다. Brown은 Prime Intellect가 대규모 GPU 마켓플레이스, 학습 프레임워크, 환경 라이브러리, 샌드박스, 평가 플랫폼을 하나의 스택으로 묶으려 한다고 설명한다. 이 스택의 목적은 대형 연구조직이 아니어도 실제 규모의 포스트 트레이닝을 할 수 있게 만드는 것이다.
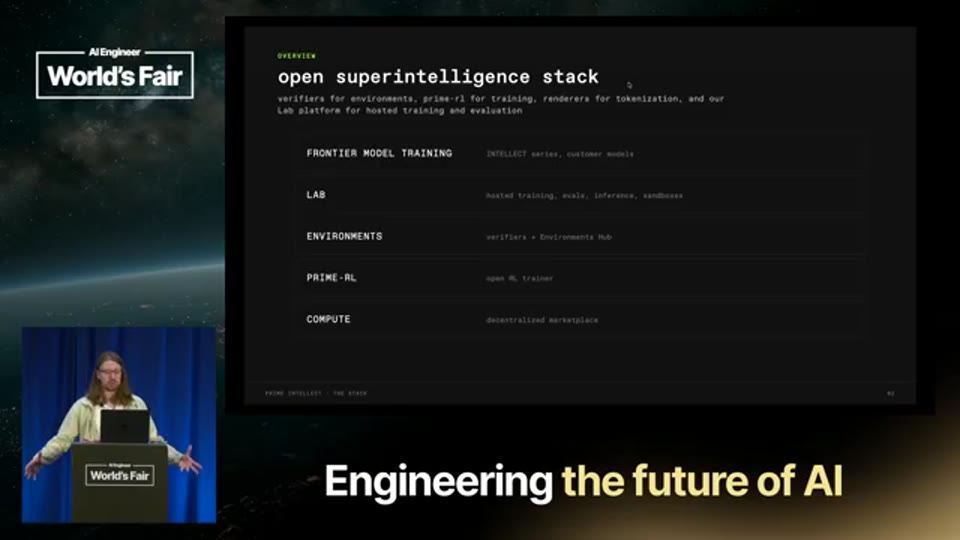
02:50 - Prime Intellect의 전체 스택을 설명하며 compute, training framework, environments, lab platform이 어떻게 연결되는지 보여주는 구간
그가 말하는 “Open Superintelligence Stack”은 단순한 마케팅 문구가 아니라, 점점 더 현실적인 기술 구조가 되고 있다. 모델이 이미 많은 영역에서 인간 이상의 성능을 보이는 상황에서 중요한 것은 모델 자체보다 그 모델을 어떤 환경에서 평가하고, 어떤 신호로 학습시키며, 어떻게 운영 중인 제품의 피드백을 다시 학습 루프로 되돌릴 것인가다. 따라서 Prime Intellect의 스택은 모델 학습만을 다루지 않고, 데이터센터 규모의 컴퓨트부터 환경, 평가, 샌드박스, 추론, 학습 오케스트레이션까지 모두 포함한다.
이 관점에서 포스트 트레이닝은 한 번 실행하고 끝나는 작업이 아니다. Brown은 모델이 실제 사용 과정에서 얻은 신호를 바탕으로 계속 개선되어야 하며, 학습 비용이 전체 추론 비용 대비 충분히 작게 amortize될 수 있다면 기업 입장에서도 지속적 모델 개선이 경제적으로 의미를 갖는다고 본다. 즉, 앞으로의 경쟁력은 가장 큰 모델을 호출하는 능력보다, 자기 문제에 맞는 평가와 학습 루프를 빠르게 반복하는 능력에서 나온다는 주장이다.
환경은 평가와 학습을 잇는 공통 언어다
Brown이 강연 전반에서 가장 강조하는 개념은 환경(Environment)이다. 전통적인 강화학습 문맥에서 환경은 에이전트가 행동하고 보상을 받는 공간으로 이해되지만, 그는 이를 훨씬 넓게 정의한다. 환경은 모델에게 어떤 작업을 시킬지, 어떤 상황에 놓을지, 어떤 도구와 상호작용하게 할지, 그리고 무엇을 좋은 결과로 볼지까지 포함하는 명세 체계다.
이 정의가 중요한 이유는 평가(Evaluation)와 학습(Training)이 사실 같은 단위의 로직을 공유하기 때문이다. 어떤 모델이 GPT, Claude, 오픈 소스 모델 중 무엇이든 특정 작업에 더 적합한지 판단하려면 평가 환경이 필요하다. 그런데 일단 그 평가 환경이 만들어지면, 같은 환경은 강화학습의 rollout을 생성하거나, SFT 데이터를 만들거나, on-policy distillation을 수행하는 데에도 활용될 수 있다. Brown은 “evals are the thing that opens the door to post training”이라는 취지로, 평가를 포스트 트레이닝의 출발점으로 본다.
이 접근은 제품 개발 관점에서도 현실적이다. 많은 팀은 처음부터 자체 모델 학습에 뛰어들기보다, 프롬프트 최적화나 API 모델 선택, 하네스(Harness) 개선을 먼저 시도한다. Brown은 이러한 단계가 포스트 트레이닝과 경쟁하는 것이 아니라 오히려 같은 루프의 일부라고 본다. 평가를 잘 만들어두면 지금은 API 모델을 고르는 데 쓰더라도, 이후에는 같은 평가 로직을 학습 데이터 생성과 RL 보상 설계로 확장할 수 있기 때문이다.
Verifiers V1이 환경을 다시 쪼갠 방식
Verifiers V1에서 Prime Intellect는 환경을 task set, harness, runtime이라는 세 요소로 재구성했다. task set은 모델이나 에이전트에 독립적인 작업 데이터와 규칙을 담는다. 예를 들어 Hugging Face Datasets, Prime Intellect Environments Hub, NeMo Gym, OpenEnv와 같은 생태계의 여러 RL 환경 구성요소가 이 범주에 들어갈 수 있다. 핵심은 task set이 특정 에이전트 실행 방식에 묶이지 않고, 여러 harness와 조합될 수 있어야 한다는 점이다.
harness는 모델이 실제로 어떻게 행동할지를 정의한다. 예전 Verifiers의 multi-turn environment나 tool environment 패턴은 시스템 프롬프트와 도구 호출 루프를 중심으로 구성되어 있었고, 단일 턴에서 다중 턴 도구 사용으로 넘어가는 시기에는 충분히 유용했다. 그러나 CLI agent, MCP, Codex, Claude Code, OpenCode, LangChain, DSPy 같은 다양한 실행 방식이 등장하면서 하나의 환경 클래스가 모든 실행 패턴을 소유하는 구조는 점점 한계에 부딪혔다. 그래서 Brown은 task set과 harness를 분리해, 같은 작업을 여러 에이전트 실행 방식으로 평가하거나 학습할 수 있게 만드는 것이 필요했다고 설명한다.
runtime은 harness가 실행되는 장소다. 로컬 프로세스일 수도 있고, Docker일 수도 있으며, Prime Sandboxes나 다른 샌드박스 계층일 수도 있다. 이 구조 덕분에 개발자는 로컬 MacBook에서 빠르게 환경을 실험하다가, 같은 구성요소를 클라우드나 샌드박스 기반 대규모 평가로 옮길 수 있다. Brown이 말하는 hot swap 패턴은 바로 이 지점을 겨냥한다. 모델, harness, runtime, task set을 서로 바꿔 끼워가며 어떤 조합이 특정 작업에 가장 적합한지 실험할 수 있게 되는 것이다.
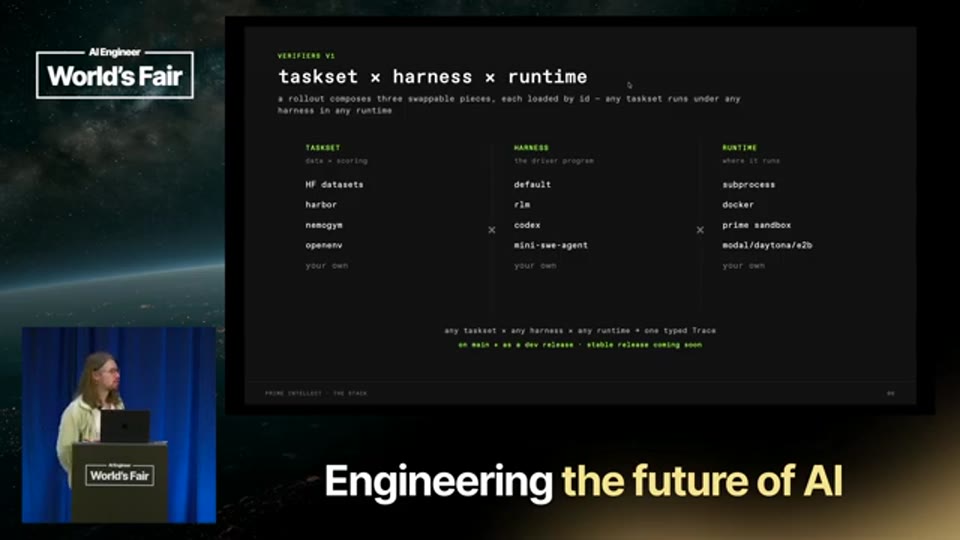
13:20 - Verifiers V1의 task set, harness, runtime 분리 구조와 외부 환경 도구 연동을 설명하는 구간
보상 함수는 단순 점수가 아니라 연구 인터페이스다
Verifiers에서 reward와 metric은 rollout 기록을 입력받아 숫자를 반환하는 함수로 설명된다. reward는 RL에서 실제 학습 신호로 사용되고, metric은 도구 사용 횟수, 에러 수, 실행 시간 같은 관찰 지표를 대시보드에 기록하는 역할을 한다. 이 구분 자체는 단순해 보이지만, Brown이 강조하는 지점은 reward 설계가 점점 더 복잡한 연구 인터페이스가 되고 있다는 점이다.
특히 group reward는 Prime Intellect가 중요하게 다루는 기능이다. 많은 RL 프레임워크는 각 rollout이 독립적이라고 가정하기 때문에, 여러 응답을 서로 비교해 보상을 주는 패턴을 구현하기가 어렵다. 하지만 실제 연구에서는 pairwise judging, ranking, shortest correct answer 보너스처럼 여러 샘플 간 비교가 필요한 경우가 많다. Brown은 이런 패턴이 현대 포스트 트레이닝 알고리즘에서 매우 중요하다고 본다.
대표적인 예가 conciseness bonus다. 모델은 충분한 압박이 없으면 생각을 길게 이어가려는 경향이 있고, 특히 오픈 모델은 긴 Chain-of-Thought를 과도하게 생성하는 문제가 생길 수 있다. 그렇다고 모든 문제에 대해 사전에 적절한 토큰 길이 제한을 정하기는 어렵다. 문제 난이도, 모델 성능, 학습 단계에 따라 적절한 길이가 달라지기 때문이다. 그래서 Brown은 여러 rollout 간 분산을 활용해, 정답인 응답들 중 더 간결한 응답에 보너스를 주는 방식이 유용하다고 설명한다. 이는 정답률과 효율성을 동시에 최적화하려는 reward shaping의 한 예다.
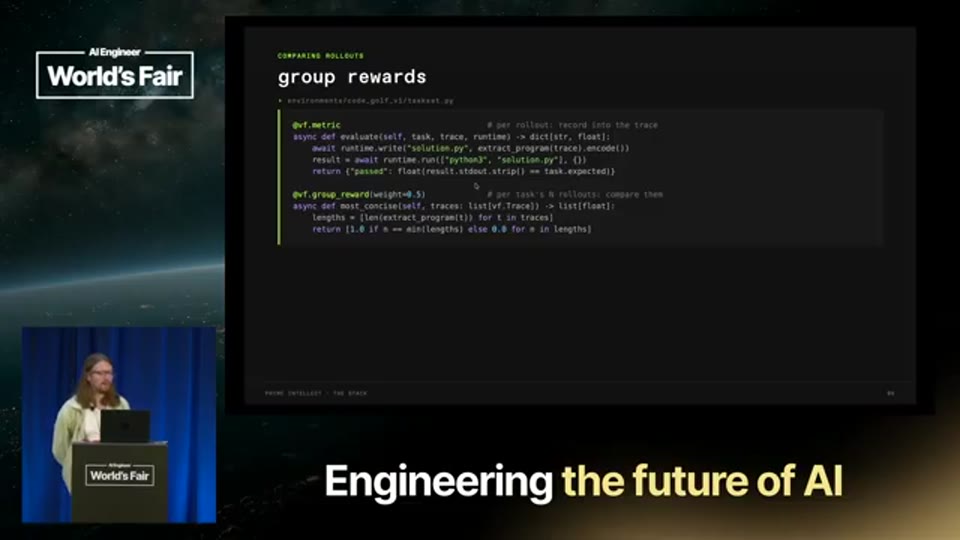
18:41 - group rewards와 conciseness bonus를 통해 rollout 간 비교 기반 보상 설계를 설명하는 구간
사용자 시뮬레이터와 MCP는 현실적인 에이전트 학습을 만든다
Brown은 복잡한 애플리케이션에서 사용자 시뮬레이터(User Simulator)의 중요성이 커지고 있다고 말한다. 실제 제품의 에이전트는 혼자서 정적 문제를 푸는 것이 아니라, 사용자의 추가 요청, 설명, 수정, 확인 과정을 거치며 작업을 완성한다. 따라서 에이전트를 학습시키려면 단순한 입력-출력 데이터셋보다, 사용자와의 다중 턴 상호작용을 모델링할 수 있는 환경이 필요하다.
Prime Intellect는 MCP(Model Context Protocol)를 도구와 사용자 시뮬레이터를 연결하는 백엔드 프레임워크처럼 활용한다. 흥미로운 점은 모델 입장에서는 사용자처럼 보이지만, 뒤에서는 MCP 서버와 LLM 기반 스크립트가 특정 맥락을 바탕으로 사용자 역할을 수행할 수 있다는 것이다. 이 구조는 실제 사용자가 매번 학습 루프에 들어오지 않아도, 사용자와 상호작용하는 제품 환경을 더 현실적으로 재현할 수 있게 한다.
이러한 구조는 에이전트 제품이 보편화될수록 중요해진다. 코드 에이전트, 리서치 에이전트, 업무 자동화 에이전트 모두 사용자의 중간 피드백에 의해 작업 방향이 바뀌기 때문이다. Brown은 이를 RL 환경의 일급 구성요소로 포함해야 한다고 보며, 도구, 사용자 시뮬레이터, grading script, runtime이 모두 모듈식으로 연결되는 구조를 제안한다.
Interception Server가 RL과 실제 배포 사이의 간극을 줄인다
강연에서 기술적으로 중요한 설계 중 하나는 interception server다. Prime Intellect는 harness가 RL 전용 코드로 변형되는 것을 원하지 않는다. 실제 제품에서 쓰는 harness를 최대한 그대로 학습 환경에서도 사용하려면, harness는 자신이 RL rollout을 수행한다는 사실을 몰라도 되어야 한다. 이를 위해 Verifiers는 각 rollout에 OpenAI 호환 또는 Anthropic 호환 형태의 가짜 base URL을 제공하고, harness는 그냥 일반 API 엔드포인트에 요청을 보내는 것처럼 동작한다.
그 요청은 interception server에서 가로채진다. 서버는 필요한 경우 log probabilities(logprobs)를 확보하고, temperature 같은 학습에 필요한 설정을 조정한 뒤, RL trainer와 연결된 inference server로 요청을 보낸다. 응답이 돌아오면 harness에는 평범한 모델 API 응답처럼 전달된다. 이 구조 덕분에 같은 harness 코드를 evaluation, training, deployment에 걸쳐 재사용할 수 있다.
이 설계는 단순한 편의 기능이 아니다. 실제 agent harness는 CLI, 도구 호출, 파일 시스템, 샌드박스, 사용자 시뮬레이터 등 다양한 구성요소와 얽혀 있다. 이를 RL 프레임워크 내부 형식에 맞추려고 억지로 재작성하면, 배포 환경과 학습 환경이 달라지고 평가 신뢰도도 떨어진다. Brown이 제안하는 방식은 학습 시스템이 harness에 맞추는 구조에 가깝고, 그래서 실제 운영 코드와 연구 코드 사이의 차이를 줄이는 데 의미가 있다.
Trace Graph와 Renderer는 토큰화 문제를 정면으로 다룬다
에이전트 학습에서 겉으로 잘 드러나지 않지만 치명적인 문제는 메시지와 토큰 사이의 불일치다. harness와 환경의 논리 세계에서는 메시지가 기본 단위다. 사용자 메시지, assistant 응답, tool call, tool result가 순서대로 이어지는 구조로 생각하면 충분해 보인다. 그러나 RL trainer와 inference engine은 토큰 수준의 logprob, sequence, mask를 다뤄야 하며, 이때 retokenization이 미묘한 수치 문제를 일으킬 수 있다.
Brown은 tokenization이 many-to-one 성격을 갖기 때문에, 모델이 생성한 텍스트를 다시 tokenizer에 넣으면 원래 토큰열과 완전히 일치하지 않을 수 있다고 설명한다. 작은 newline 차이나 chat template의 strip 동작이 trainer와 inference 사이의 mismatch를 만들고, 이는 큰 규모의 학습 후반부에서 안정성 문제로 이어질 수 있다. 특히 branch 구조를 갖는 agent rollout에서는 논리적으로는 같은 prefix처럼 보이는 부분이 토큰 공간에서는 다르게 표현될 수 있어 더 복잡해진다.
Prime Intellect가 만든 trace graph는 메시지 수준의 논리 구조와 토큰 수준의 학습 구조를 함께 보존하려는 시도다. 여기에 renderers라는 별도 라이브러리가 결합된다. Brown은 기존 chat template, 특히 Jinja 기반 템플릿을 디버깅하기가 매우 고통스럽다고 말하며, renderers를 tokenizer와 chat template을 더 명시적이고 프로그래밍 가능한 artifact로 다루기 위한 추상화로 소개한다. 이 라이브러리는 Prime Intellect 내부 도구에만 묶이지 않고, 어떤 inference engine과도 함께 쓸 수 있는 독립 Python 라이브러리로 제시된다.
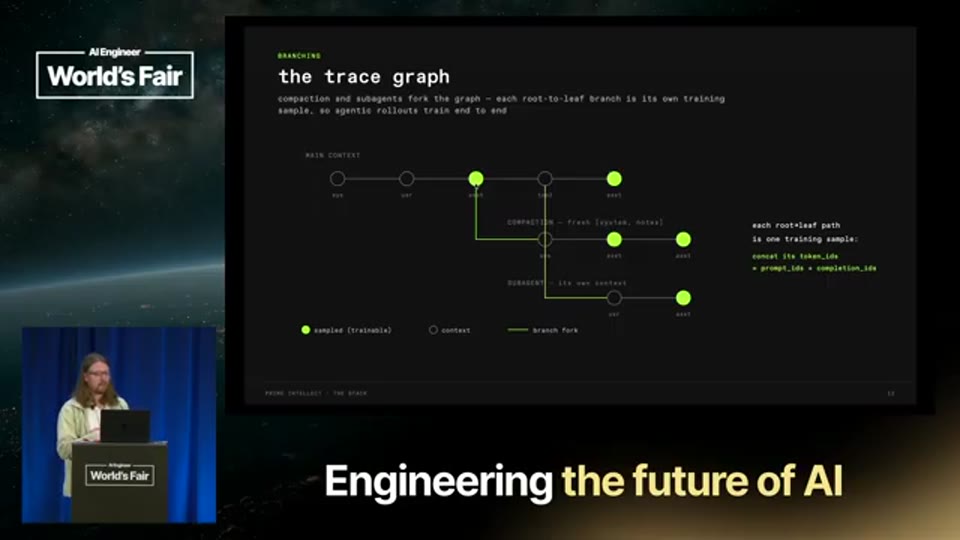
24:43 - trace graph, subagent branch, 메시지 공간과 토큰 공간의 불일치 문제를 설명하는 구간
PrimRL은 비동기 RL을 기본값으로 삼는다
PrimRL은 Verifiers가 만든 환경을 실제 학습으로 소비하는 프레임워크다. Brown은 PrimRL이 처음부터 async RL을 중심으로 설계되었다고 설명하며, synchronous training에 대해서는 꽤 명확한 반대 입장을 보인다. 에이전트 환경에서는 rollout 시간이 길고 불규칙하기 때문에, 모든 rollout이 끝날 때까지 기다리는 동기 방식은 GPU 사용률과 전체 학습 속도에 큰 손실을 만든다.
코딩 에이전트 작업을 생각하면 이 문제가 분명해진다. 어떤 작업은 30초 만에 끝나지만, 어떤 작업은 몇 분 또는 몇 시간까지 이어질 수 있다. 동기식 RL에서는 가장 느린 rollout이 전체 batch의 속도를 결정한다. 반면 async RL에서는 rollout이 끝나는 대로 가능한 batch에 들어가고, inference server는 최신 모델 버전을 사용해 계속 진행한다. 이 과정에서 어느 정도 off-policy 상태가 발생하지만, Brown은 에이전트 학습에서는 이를 감수하는 편이 전체 시스템 효율성 면에서 더 합리적이라고 본다.
PrimRL의 orchestrator는 이 구조에서 핵심 역할을 한다. inference server와 trainer는 별도 프로세스, 별도 서버로 동작하며 GPU를 공유하지 않는다. orchestrator는 환경을 실행하고, endpoint를 inference server에 매핑하며, rollout을 모아 batch로 패키징한 뒤 trainer에 전달한다. trainer는 받은 batch를 loss function에 맞는 sequence와 mask로 변환해 학습한다. 이런 분리는 환경 복제 수, 샌드박스 사용 여부, inference scaling, trainer scaling을 독립적으로 조절할 수 있게 해준다.
대규모 학습 비용과 속도는 기업 도입의 현실성을 결정한다
Brown은 PrimRL의 최근 스케일링 결과로 GLM-4.5 계열 모델에서의 장기 코딩 작업 학습 사례를 언급한다. STT상 “GLM5”와 “5.2”로 인식된 부분은 문맥상 GLM-4.5 및 해당 계열 업데이트를 의미하는 것으로 보인다. 그는 28개 노드에서 131K context의 long-horizon coding task에 대해 한 step을 5분 미만으로 수행할 수 있었고, 1,000 step run을 약 3일 안에 끝낼 수 있으며, rental price 기준 약 50,000달러 수준이라고 설명한다.
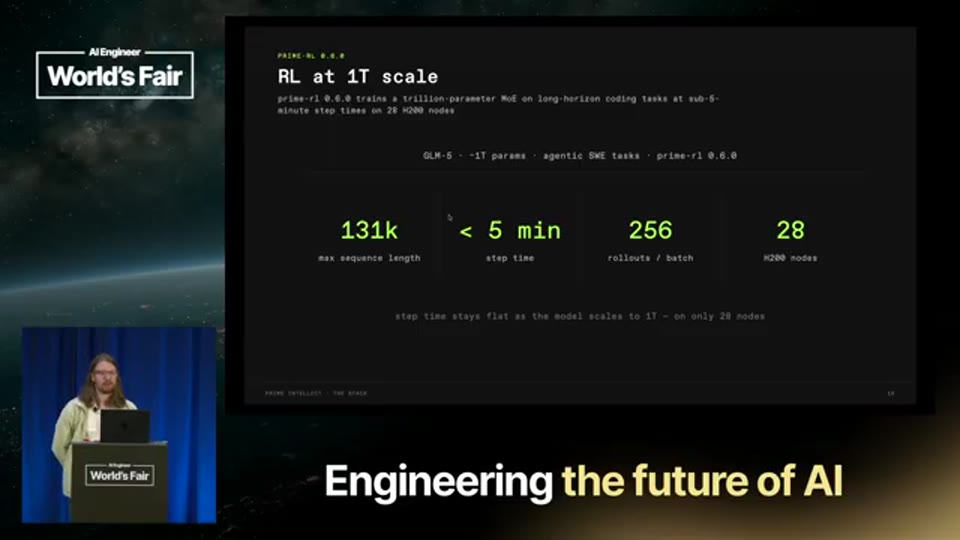
32:21 - GLM-4.5 계열 장기 코딩 작업 학습에서 28개 노드, 131K context, 1,000 step run 비용과 시간을 설명하는 구간
이 숫자는 절대적으로 작지는 않다. 그러나 Brown의 관점에서는 frontier-size model을 실제 agent environment에서 학습시키는 비용으로는 기업이 검토할 만한 수준이다. 많은 기업이 한 달에 토큰 비용으로 비슷한 규모의 지출을 하기도 하며, 특정 업무 흐름에서 자체 모델이 더 효율적으로 작동한다면 장기적으로 추론 비용과 품질 양쪽에서 이득을 얻을 수 있기 때문이다. 포스트 트레이닝의 경제성은 단일 학습 실행 비용만으로 판단할 수 없고, 운영 중 반복적으로 발생하는 inference budget과 비교해야 한다는 것이 그의 논리다.
이 지점에서 Prime Intellect의 비즈니스 모델도 드러난다. 단순히 오픈 소스 라이브러리를 공개하는 것을 넘어, 대규모 GPU 인프라와 hosted training platform을 제공해 기업이 직접 복잡한 GPU 운영을 하지 않아도 되도록 하는 것이다. Brown은 멀티테넌트 LoRA 기반 hosted training이 이미 제공되고 있으며, full fine-tuning도 곧 제공될 예정이라고 설명한다. 이는 사용자가 환경과 보상 함수를 로컬 CPU에서 개발한 뒤, 플랫폼에 패키지로 올려 대규모 학습으로 확장하는 흐름을 염두에 둔 구조다.
시스템 최적화는 알고리즘 연구를 가능하게 하는 기반이다
강연 후반부에서 Brown은 PrimRL이 대규모 모델 학습을 위해 적용한 시스템 최적화들을 빠르게 훑는다. FP8, expert parallelism, context parallelism, wide expert parallelism, disaggregated prefill, KV offloading, router replay 같은 항목이 언급된다. STT상 일부 용어는 부정확하게 인식되었을 가능성이 있으나, 전체 맥락은 Mixture-of-Experts(MoE) 모델과 긴 컨텍스트 학습에서 메모리, 라우팅, 병렬화, 저장소 관리가 핵심 병목이 된다는 설명으로 읽힌다.
특히 router replay는 Brown이 “nasty systems problem”이라고 표현할 만큼 까다로운 문제로 제시된다. MoE 모델에서는 각 토큰이 각 레이어에서 어떤 expert로 라우팅되었는지에 대한 메타데이터를 추적해야 하고, 이는 단순 token과 logprob보다 훨씬 많은 부가 데이터를 생성한다. 여기에 multimodal 학습처럼 이미지나 대형 artifact가 포함되면, 모든 것을 메모리에 들고 있을 수 없기 때문에 object storage나 외부 파일 시스템으로 무거운 artifact를 offload해야 한다.
흥미로운 선택은 Prime Intellect가 Megatron이 아니라 TorchTitan 기반으로 PrimRL을 구축했다는 점이다. Brown은 TorchTitan이 hackable하고 modular하다는 점을 이유로 든다. 새로운 모델이나 논문 아이디어가 나왔을 때, 작은 연구팀이 빠르게 코드를 수정하고 실험하려면 거대한 monolithic framework보다 구조가 명확하고 변경하기 쉬운 기반이 유리하다는 것이다. 이는 Prime Intellect가 단순 운영 효율뿐 아니라 연구 속도를 핵심 가치로 보고 있음을 보여준다.
알고리즘 레이어는 Loss와 Algorithm으로 분리된다
Brown은 현대 포스트 트레이닝이 단순한 PPO류 강화학습만으로 설명되지 않는다고 본다. On-policy distillation, self-distillation, SFT, OPD, Echo류 알고리즘, world modeling과 RL의 결합 등 다양한 연구 패턴이 빠르게 등장하고 있기 때문이다. 이런 상황에서 매번 trainer 내부 깊은 곳에 if statement를 추가하는 방식은 유지보수와 실험 속도를 모두 망친다.
PrimRL은 이를 해결하기 위해 loss와 algorithm을 분리한다. loss는 실제 gradient를 계산하는 대상이고, algorithm은 rollout 데이터를 어떻게 준비하고, advantage를 어떻게 부여하며, 어떤 signal과 masking을 loss에 전달할지를 결정하는 계층이다. Brown은 advantage를 넓은 의미의 score로 일반화하면, SFT의 cross entropy나 negative log likelihood도 advantage가 1인 특수한 경우처럼 볼 수 있다고 설명한다. RL에서는 reward에서 baseline을 뺀 값이 advantage가 되고, on-policy distillation 계열에서는 logprob ratio가 유사한 역할을 한다.
이 추상화의 장점은 인프라를 바꾸지 않고 알고리즘만 교체할 수 있다는 점이다. 현재 policy model이 생성한 rollout을 쓸 수도 있고, teacher model이 생성한 데이터를 쓸 수도 있으며, 환경별로 다른 algorithm을 적용할 수도 있다. self-distillation에서는 teacher에 다른 hint나 prompt를 주고, renderers를 통해 sequence를 다시 원래 형태로 slicing해 reference logprob로 사용할 수 있다. 결국 PrimRL은 다양한 포스트 트레이닝 알고리즘을 하나의 데이터 흐름 안에서 조합하려는 프레임워크로 설계되어 있다.
Hosted Training Platform과 LoRA, Full Fine-Tuning의 역할 분담
Prime Intellect의 hosted training platform은 사용자가 직접 GPU 운영을 신경 쓰지 않고 PrimRL 기반 학습을 실행하게 하는 계층이다. 현재 제공되는 self-serve 버전은 multi-tenant LoRA 중심이며, 이는 여러 사용자가 같은 base model weight copy 위에서 각자의 LoRA adapter를 hot swap해 학습하고 추론할 수 있게 한다. Brown은 이를 일반적인 토큰 기반 inference 서비스와 유사한 구조로 설명한다. 하나의 큰 모델 복사본이 여러 요청을 처리하고, 각 사용자는 자기 LoRA만 별도로 갖는 방식이다.
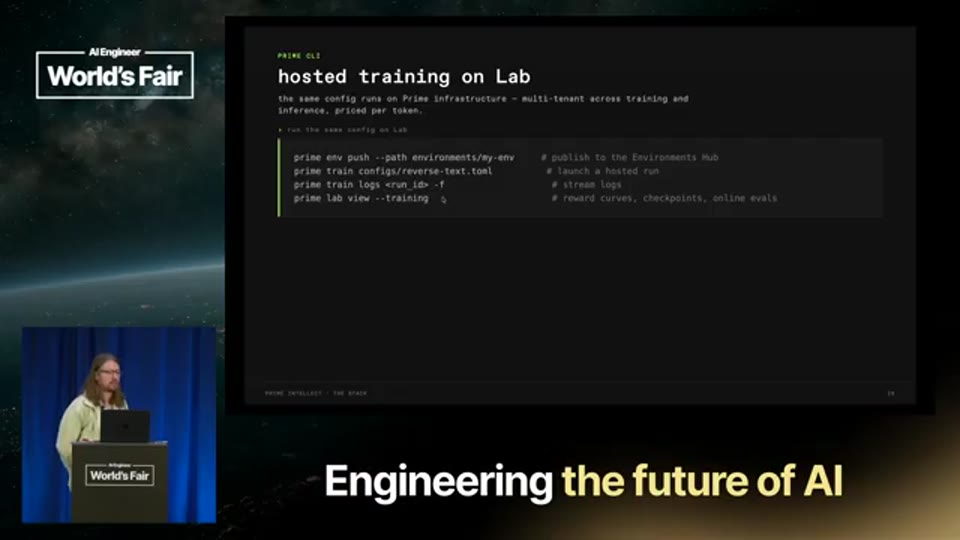
42:43 - hosted training platform, multi-tenant LoRA, full fine-tuning 제공 계획을 설명하는 구간
이 구조는 비용 효율적이다. 사용자가 각자 전체 모델을 띄우거나 GPU를 예약하지 않아도 되기 때문에, token-based pricing과 잘 맞는다. 다만 모든 경우에 LoRA가 충분한 것은 아니다. 대규모 SFT, mid-training, 새로운 알고리즘 연구, 모델 내부 구조까지 바꿔야 하는 실험에서는 full fine-tuning이 필요할 수 있다. Brown은 Prime Intellect가 full fine-tuning도 곧 제공할 예정이며, 이 경우 사용자는 모델, 알고리즘, loss function, trainer 내부까지 더 깊게 수정할 수 있다고 설명한다.
이 계층화는 실무적으로 중요하다. 대부분의 팀은 처음에는 reward function이나 environment만 바꾸고 싶어 한다. 조금 더 깊이 들어가면 learning rate, loss function, algorithm config를 조정하고 싶어진다. 연구팀은 algorithm class나 loss function 자체를 바꾸고 싶을 수 있다. Prime Intellect는 이 모든 깊이를 하나의 플랫폼에서 지원하려 하며, 사용자가 필요한 만큼만 스택의 아래쪽으로 내려가도록 설계하고 있다.
마무리 / 핵심 정리
이 강연의 핵심은 포스트 트레이닝을 “모델을 한 번 fine-tune하는 작업”이 아니라, 평가, 환경, rollout, reward, distillation, RL, 배포, 운영 피드백이 이어지는 반복 시스템으로 봐야 한다는 점이다. Brown은 Verifiers를 통해 이 시스템의 환경 표현을 정리하고, PrimRL을 통해 대규모 비동기 학습을 실행하며, hosted platform을 통해 기업이 이를 실제로 사용할 수 있는 형태로 제공하려 한다.
기술적으로 가장 중요한 통찰은 평가와 학습의 단위가 같아져야 한다는 것이다. 좋은 eval을 만들면 모델 선택에만 쓰이는 것이 아니라, SFT 데이터 생성, RL reward 설계, distillation, 배포 후 개선 루프까지 확장될 수 있다. 그래서 환경은 단순한 벤치마크가 아니라 모델 개선의 공통 언어가 된다.
또 다른 핵심은 실제 에이전트 시대의 학습 시스템은 복잡성을 피할 수 없다는 점이다. 사용자 시뮬레이터, 도구, MCP, 샌드박스, CLI agent, 긴 rollout, 토큰화 불일치, MoE 라우팅 메타데이터, off-policy async training 같은 문제들이 모두 한꺼번에 등장한다. Prime Intellect의 접근은 이 복잡성을 숨기는 것이 아니라, task set, harness, runtime, renderer, orchestrator, algorithm이라는 계층으로 나누어 연구와 제품 양쪽에서 다룰 수 있게 만드는 데 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | The Prime Intellect Stack — Will Brown, Prime Intellect |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-07-14 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Local Models - Trust, Control, Optimization - Carter Abdallah, NVIDIA
- Data and Environment Curation for Post-Training LLMs — Mahesh Sathiamoorthy, Bespoke Labs
- Let LLMs Wander - Engineering RL Environments — Stefano Fiorucci
- The Base Model Is Dead — Varun Singh, Arcee AI
- Training Frontier Models to Out-Think Hackers - Uri Rolls, Arithmetic & Thom Wolf, Hugging Face