LLM에게 탐험의 공간을 — RL 환경 엔지니어링 심층 분석
📺 원본 영상: Let LLMs Wander: Engineering RL Environments — Stefano Fiorucci 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-08 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(코드, 슬라이드, 학습 곡선 그래프 등)는 포함되지 않을 수 있으며, 해당 부분은 원본 영상 참조를 권장합니다.
개요
Haystack 개발자이자 AI 엔지니어인 Stefano Fiorucci는 이 강연에서 강화학습(Reinforcement Learning, RL) 환경을 LLM 평가 및 훈련에 적용하는 방법론을 실험적으로 탐구한다. 단순한 이론 소개에 머물지 않고, 오픈소스 라이브러리인 Verifiers를 활용해 실제로 소형 언어 모델을 틱택토(Tic-Tac-Toe) 마스터로 변신시키는 전 과정을 상세히 공개한다. 강연의 핵심 메시지는 명확하다. 명확한 보상 신호(reward signal)를 정의할 수 있다면, 집에서도 소형 특화 모델을 훈련해 특정 태스크에서 대형 클로즈드 모델을 능가할 수 있다는 것이다.
강화학습의 기초, 그리고 LLM과의 만남
강화학습에는 두 명의 핵심 주인공이 등장한다. 에이전트(agent)와 환경(environment)이다. 에이전트는 현재 세계의 상태(state)를 관찰하고 행동(action)을 취하며, 환경은 그 행동에 반응해 상태를 변경하고 에이전트에게 보상(reward)이라는 숫자 신호를 돌려준다. 에이전트의 목표는 이 누적 보상을 최대화하는 것이며, 이를 위해 탐험(exploration, 새로운 행동을 시도해 더 나은 전략을 발견하는 것)과 착취(exploitation, 이미 효과적임이 알려진 행동을 사용하는 것) 사이의 균형을 끊임없이 맞춰야 한다. 이 상호작용의 기록, 즉 상태·행동·보상의 전체 시퀀스를 가리켜 궤적(trajectory) 또는 롤아웃(rollout)이라 부르며, 이 강연에서는 이를 하나의 완전한 에피소드, 예컨대 한 판의 게임 전체를 의미하는 것으로 사용한다.
이 고전적인 강화학습 개념을 LLM에 그대로 대입하면, 언어 모델이 에이전트 역할을 맡는다. 환경은 특정 태스크에 필요한 데이터, 하네스(harness), 채점 규칙 등 모델이 상호작용할 수 있는 모든 요소를 포괄한다. SFT(Supervised Fine-Tuning, 지도 미세조정)가 주로 정적인 대화 데이터셋에 의존하는 것과 달리, RL 패러다임은 모델이 상호작용할 수 있는 동적 시스템, 즉 환경을 요구한다. 그리고 에이전트의 정의 자체도 확장되고 있다. 언어 모델에게 날씨 API부터 터미널까지 다양한 도구를 쥐어줄 수 있게 되면서, 훈련 및 평가 환경은 더욱 복잡하고 중요해지고 있다.
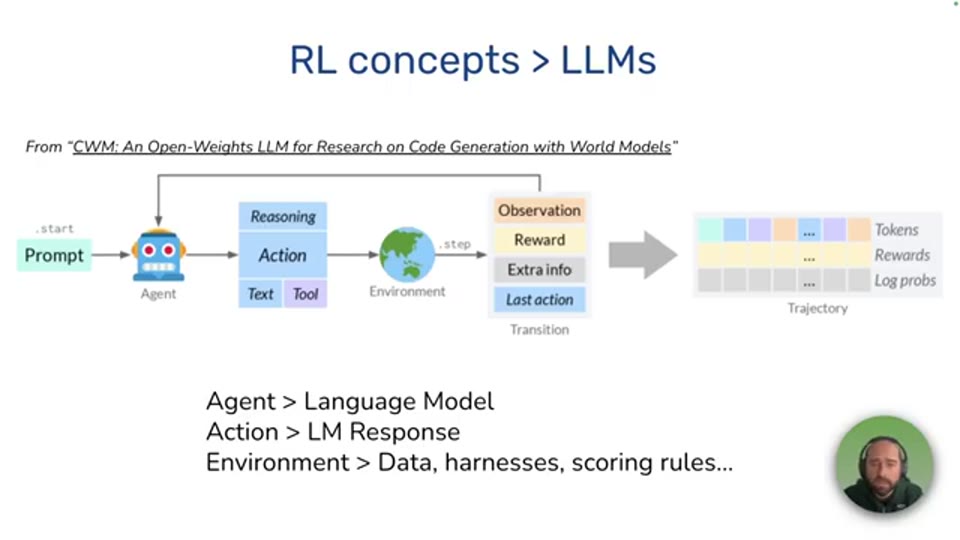
08:03 - 강화학습 개념을 LLM 도메인에 매핑한 다이어그램 — 에이전트(LLM), 환경, 보상의 관계
SFT의 한계와 새로운 스케일링 패러다임
언어 모델의 표준 훈련 레시피는 대규모 인터넷 텍스트를 이용한 사전 학습(pre-training), 대화 예제를 활용한 SFT, 그리고 인간의 선호도를 반영하기 위한 PPO(Proximal Policy Optimization) 등의 RL 기법 적용이라는 세 단계로 구성된다. SFT 단계에서 모델은 프롬프트-응답 쌍으로 이루어진 예제를 통계적으로 모방하며 학습한다.
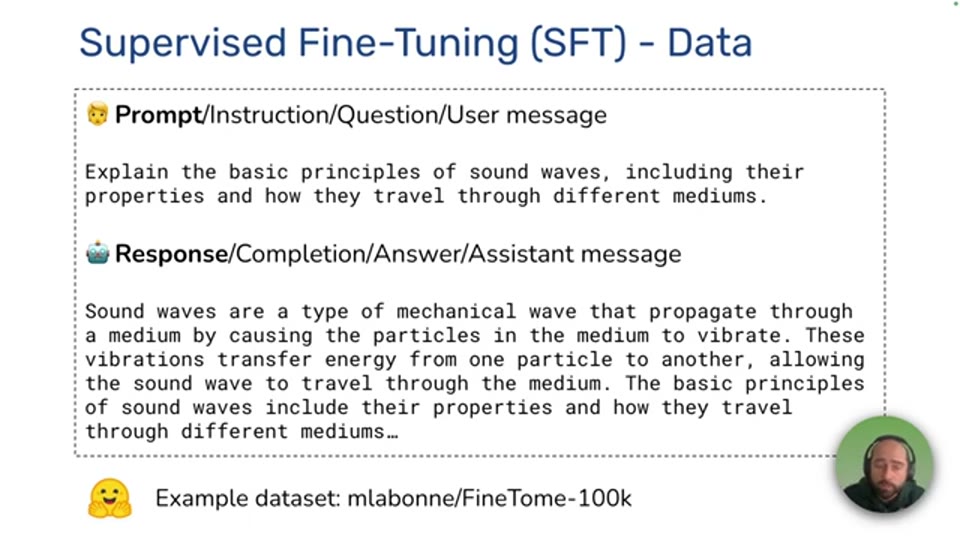
04:38 - SFT(지도 미세조정) 데이터 형식 — 프롬프트와 응답 쌍으로 구성된 예제 슬라이드
그런데 Ilya Sutskever가 NeurIPS 2024에서 지적했듯, 이 패러다임은 한계를 드러내기 시작했다. 특히 사전 학습만으로는 동일한 속도로 모델 품질을 계속 향상시키는 것이 어려워진 것이다.
이 공백을 메운 것이 OpenAI의 o1 모델 시리즈였다. OpenAI는 모델이 연쇄적 사고(chain of thought)를 효과적으로 사용하도록 RL 훈련을 적용했다고 밝혔으며, RL 훈련 시간 컴퓨트(train-time compute)와 추론 시간 컴퓨트(test-time compute)가 늘어날수록 o1의 성능이 일관되게 향상됨을 강조했다. 그러나 구체적인 훈련 방식은 공개되지 않았고, DeepSeek-R1의 출시가 그 안개를 일부 걷어냈다.
DeepSeek 팀은 추론과 연쇄적 사고가 모델 성능을 높일 수 있지만, 이 동작을 SFT로 가르치려면 대규모로 생산하기에 너무 비싼 데이터가 필요하다는 점을 인식했다. 이에 따라 그들은 검증 가능한 보상(verifiable rewards)을 이용한 강화학습을 채택했고, GRPO(Group Relative Policy Optimization)라는 새로운 RL 알고리즘을 도입했다. GRPO는 PPO보다 간단하고 가벼운 설정을 제공한다는 점에서 주목받는다.
검증 가능한 보상을 이용한 강화학습의 핵심 아이디어는 간결하다. 모델이 질문에 대한 추론 과정과 최종 답변을 생성하면, 그 답변이 정답과 대조되어 보상이 결정된다. 이때 보상의 출처가 되는 신호는 매우 다양할 수 있다. 정확한 답, 성공적인 도구 호출, 코드의 실행 결과 등 자동으로 검증 가능한 모든 결과가 훈련 신호로 기능할 수 있다. 이는 SFT와 근본적으로 다른 지점이다. SFT에서 모델의 출력은 학습 예제들의 분포에서 크게 벗어나지 못하지만, RL 방식에서 모델은 사전 학습으로부터 시작해 다양한 궤적을 탐험하고 보상을 최대화하는 것들을 선별적으로 강화해나간다. 인간이 만든 예제의 품질에 더 이상 제약받지 않고, 시행착오를 통해 더 효율적인 추론 전략을 스스로 발견할 수 있게 되는 것이다.
Verifiers: RL 환경을 소프트웨어 아티팩트로
환경을 어떻게 구축할 것인가라는 질문에 대한 실용적 답변이 Verifiers다. Prime Intellect가 개발한 이 오픈소스 라이브러리는 LLM 에이전트를 위한 RL 환경을 소프트웨어 아티팩트로 만들기 위한 모듈식 컴포넌트를 제공하며, 평가와 훈련 양쪽 모두에 활용할 수 있다.
Verifiers의 설계 철학은 환경을 Python 패키지로 쉽게 설치·배포할 수 있게 하는 것이다. 라이브러리는 단일 턴(single-turn) 환경, 멀티 턴(multi-turn) 환경, 모델이 도구를 사용하는 도구 환경(tool environment) 등 다양한 설정을 위한 기본 클래스를 제공한다. 또한 모델의 응답을 파싱하고 보상 함수를 정의하는 추상화 계층도 포함하고 있다. 중요한 것은 Verifiers가 모델 서빙을 추상화한다는 점이다. OpenAI 호환 API 엔드포인트를 기대하므로, OpenAI, OpenRouter, 혹은 vLLM을 통한 로컬 모델을 손쉽게 연결할 수 있다. 비동기 상호작용과 병렬 롤아웃을 자동으로 처리해주므로, 개발자는 인프라가 아닌 환경 로직과 보상 설계에만 집중하면 된다. 훈련을 위해서는 자체 트레이너가 포함되어 있고, PrimeRL, TinkerRL, SkyRL 등 외부 프레임워크와의 통합도 지원한다.
환경 유형별 구현 패턴
단일 턴 환경 — 가장 단순한 시작점
단일 턴 환경의 사례로 강연자는 텍스트 역순 변환(reverse text) 환경을 소개한다. 이 환경의 핵심 구조는 load_environment라는 진입점 함수로 시작된다. 이 함수 안에서 천 개의 텍스트 단락으로 구성된 기본 데이터셋이 로드되고, 각 예제는 원본 텍스트(질문)와 그 역순 문자열(정답)로 매핑된다. XML 파서가 초기화되어 모델의 응답 중 특정 태그 내부의 텍스트를 추출하고, 보상 함수는 모델 출력과 정답 사이의 최장 공통 부분 수열(Longest Common Subsequence) 비율로 계산된다. 이 구성 요소들이 루브릭(rubric, 가중치가 적용된 보상들의 묶음)으로 번들링되어 최종 환경을 이룬다.
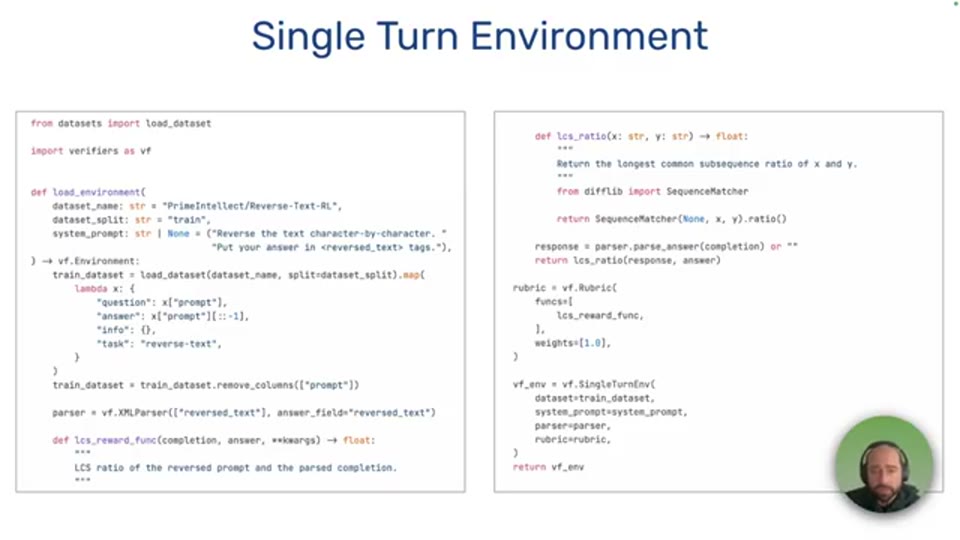
11:52 - Verifiers 단일 턴 환경(Reverse Text) 전체 Python 코드 — load_environment, 파서, 보상 함수, 루브릭
평가 실행의 내부 동작을 보면, 데이터셋에서 다섯 개의 예제가 추출되고 각 예제는 세 번의 롤아웃에 사용되어 총 15개의 롤아웃이 생성된다. 각 롤아웃은 동일한 질문을 받지만, 모델의 확률적 특성으로 인해 서로 다른 응답을 생성할 수 있다. 각 롤아웃에서 시스템 프롬프트와 질문으로 대화가 구성되고, 모델이 응답을 생성하면 파싱과 보상 계산이 이루어지며, 최종적으로 요약 통계와 보상 분포 정보가 출력된다.
멀티 턴 환경 — 상태(State)의 등장
멀티 턴 환경의 대표 예제는 수학 문제를 풀고 나서 환경이 “정말 확신하나요?(Are you sure?)”라고 되묻는 더블체크(double-check) 환경이다. 단일 턴과의 가장 큰 차이는 state의 등장이다. 상태는 롤아웃 동안 정보를 추적하는 딕셔너리로, setup_state 메서드를 통해 초기 상태를 설정할 수 있다. 또한 환경은 한 번의 상호작용으로 끝나지 않고, 상태를 기반으로 동적으로 생성된 메시지 리스트를 응답으로 돌려줄 수 있다. @yet_stop 데코레이터는 특정 메서드를 정지 조건으로 지정하며, 이 메서드가 True를 반환할 때 롤아웃이 종료된다. Verifiers는 내부적으로 모델과 환경이 메시지를 주고받고 공유 상태를 갱신하며 정지 조건이 충족될 때까지 반복하는 루프를 실행한다.
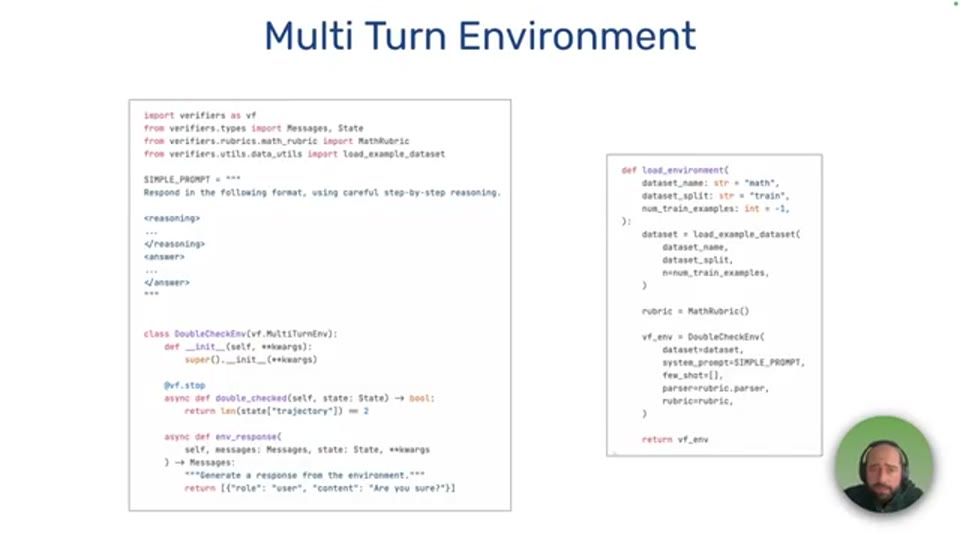
14:31 - 멀티 턴 환경(Double-Check)의 state, mResponse, yet_stop 구성 코드
도구 환경과 그 너머
도구 환경(Tool Environment)은 멀티 턴 환경을 확장해 모델에게 도구 호출 능력을 부여한다. 도구는 Python 함수로 정의되며, 롤아웃 중 모델이 도구를 호출하면 그 결과를 받아 추론을 이어갈 수 있다. 각 턴은 모델의 응답과 환경의 도구 실행이 교대로 이루어지며, 도구 호출 없는 응답이 나올 때까지 반복된다. 보다 현실적인 예제로는 WikiSearch 환경이 소개된다.
Verifiers는 이 기본 환경 유형들을 넘어 더 고급 추상화도 제공한다. MCP(Model Context Protocol) 환경은 MCP 서버에 자동으로 연결해 그 도구들을 노출시키며, 상태 보존 도구 환경(Stateful Tool Environment)은 데이터베이스 연결이나 세션 ID처럼 롤아웃 단위로 상태를 유지해야 하는 도구를 지원한다. 또한 재귀적 언어 모델(rLLM, Recursive LLM)을 구현하는 클래스도 포함되어 있는데, 이는 언어 모델이 무한한 길이의 입력 컨텍스트를 분해하고 재귀적으로 처리할 수 있는 추론 전략이다.
이 생태계의 확장을 위해 Verifiers는 Environments Hub와도 긴밀히 통합된다. Environments Hub는 RL 환경을 공유하는 커뮤니티 공간으로, 환경 파편화(fragmentation)에 맞서는 오픈 이니셔티브다. 특정 훈련 스택에 종속된 환경은 재사용이 어렵고, 클로즈드 소스 환경 시장이 성장함에 따라 오픈소스 모델이 제대로 된 훈련 환경이 없어 뒤처지는 상황을 막고자 하는 취지다.
틱택토 실험 — 소형 모델을 마스터로 만들기
왜 틱택토인가
강연자가 틱택토를 실험 대상으로 선택한 이유는 그 단순함에 있지 않다. 틱택토는 멀티 턴 상호작용이 필수적이고, 정적 데이터셋으로 그 동태를 포착하기가 매우 어렵다. 상태 공간이 작고 결정론적 해법이 존재함에도 불구하고, 많은 언어 모델이 이 게임에서 고전한다. 강화학습이 이 간극을 얼마나 메울 수 있는지를 보여주기에 이보다 적절한 사례는 없다.
환경 설계 — 점진적 개선의 여정
틱택토 환경의 초기 버전에서는 몇 가지 단순화가 이루어진다. 모델은 항상 X를 사용하고 먼저 플레이하며, <move> 태그 안에 0에서 8 사이의 숫자를 출력해야 하고, 상대방은 완전히 무작위로 플레이한다. load_environment에서는 각 게임을 시작하는 초기 사용자 메시지를 담은 데이터셋을 생성하고, setup_state는 보드 상태와 승자 등 게임 진행에 필요한 정보를 상태 딕셔너리에 채운다.
게임의 핵심 로직은 mResponse 메서드에 담겨 있다. 이 메서드는 모델의 마지막 움직임을 파싱하고, 유효하지 않은 움직임인지 확인한 뒤(초기 버전에서는 즉각적인 패배 처리), 보드에 적용하고, 무작위 상대 움직임을 적용하며, 승리 또는 무승부를 확인한다. 게임이 끝나지 않았다면 현재 보드 상태를 사용자 메시지로 돌려보내 다음 움직임을 요청한다. 보상 함수는 두 가지가 사용된다. 승리 보상 함수(가중치 1)와 XML 형식 준수를 보상하는 형식 보상 함수(가중치 0.2)다.
이 기본 환경은 훈련을 진행하며 벽에 부딪히는 경험을 통해 점진적으로 개선되었다. 첫 번째 개선은 선공/후공 랜덤화다. 모델이 항상 먼저 플레이하는 것은 비현실적이므로, 첫 번째로 플레이하는 경우와 두 번째로 플레이하는 경우를 모두 경험하도록 한다.
두 번째 개선은 상대방 강도 제어다. 항상 무작위 상대를 만나는 것은 실전성이 없기 때문에, 미니맥스(minimax) 알고리즘을 사용하는 최적 상대를 도입했다. 이 상대와는 무승부가 최선의 결과다. 그러나 훈련 초반부터 완벽한 상대를 만나면 모델이 단 한 번의 승리도 경험하지 못해 학습에 실패할 수 있다. 이를 해결하기 위해 상대가 최적 수 대신 무작위 수를 선택할 확률을 파라미터(min_random_move_prob, max_random_move_prob, 0에서 1 사이)로 제어한다. 같은 데이터셋 예제에서 파생된 서로 다른 롤아웃은 동일한 무작위 수 선택 확률을 가지므로, 공정한 비교가 가능하다.
세 번째 개선은 추론 흔적(thinking trace)의 도입이다. 최종 답변 이전에 사고 과정을 출력하도록 요구하는 것은 추론 능력 향상에 효과적이다. <think> 태그의 존재를 확인하는 새로운 형식 보상 함수를 정규 표현식으로 정의했다.
네 번째 개선은 유효하지 않은 움직임에 대한 처리 방식이다. 소형 모델들은 형식을 잘못 지키거나 이미 점유된 칸을 선택하는 실수를 자주 범한다. 이를 즉각적인 패배로 처리하면, 소형 모델이 유용한 학습 신호를 얻지 못할 수 있다. 대신 -0.1의 고정 페널티를 부과하고 게임을 계속 진행시키되, 최대 8번으로 횟수를 제한한다.
다섯 번째 개선은 GRPO 기반 학습의 노이즈 감소다. GRPO는 동일한 출발점에서 시작한 여러 롤아웃을 비교해 어떤 궤적을 강화할지 결정한다. 따라서 보상의 차이는 모델의 플레이 방식에서 비롯되어야지, 환경의 무작위성에서 비롯되어서는 안 된다. 이를 위해 각 예제에 예제 시드(seed)를 설정하고, 각 턴에서는 예제 시드와 보드 상태를 기반으로 특정 턴 시드를 도출한다. 이로써 두 롤아웃이 동일한 보드 상태에 도달하면, 상대는 항상 동일한 방식으로 응답한다.
여섯 번째 개선은 배치 간 노이즈 감소를 위한 계층화 샘플링(stratified sampling)이다. 훈련 중 배치 크기는 모델 가중치가 업데이트되기 전에 고려되는 게임 수를 의미한다. 상대 강도가 데이터셋 전반에 걸쳐 다양하게 분포할 때, 배치 크기가 작으면 어느 배치는 강한 상대만, 또 다른 배치는 약한 상대만 포함될 수 있다. 이는 평균 보상의 심한 변동을 야기해 훈련을 불안정하게 만든다. 계층화 샘플링은 모든 배치가 선택된 범위에 걸쳐 상대 난이도가 완벽하게 균형 잡히도록 강제한다.
기준선 평가 — 얼마나 큰 격차가 있는가
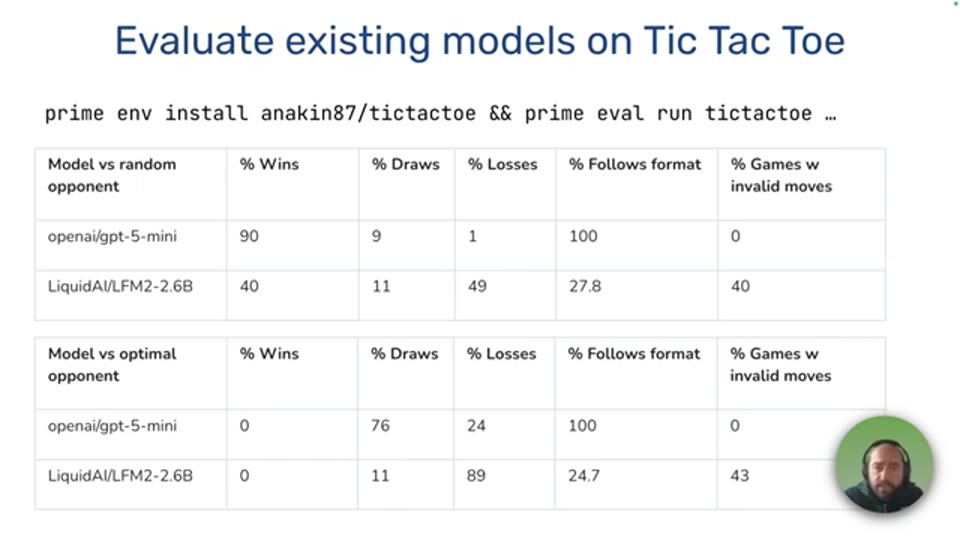
25:44 - GPT-4o mini와 LFM2의 틱택토 기준선 평가 결과 비교 지표
훈련에 앞서 강연자는 GPT-4o mini와 LiquidAI의 LFM2라는 소형·고속 오픈 모델을 Verifiers로 평가한다. 결과는 극명한 차이를 보인다. GPT-4o mini는 형식 준수가 탁월하고, 무작위 상대를 상대로는 좋은 성능을 보이지만 완벽하지는 않다. 반면 LFM2는 형식 준수에 어려움을 겪고 유효하지 않은 움직임도 빈번하며, 무작위 상대를 상대로는 간혹 이기지만 최적 상대에게는 거의 살아남지 못한다. 두 모델 사이에는 명백한 성능 격차가 존재한다.
SFT 워밍업 — 기초 능력의 주입
강연자는 LFM2를 선택해 훈련하기로 결정한다. 좋은 인스트럭트 모델을 추론 모델로 변환하기에 이상적이기 때문이다. 그러나 RL 훈련에 바로 진입하기 전에 SFT 워밍업 단계를 거친다. 이 단계에서는 모델에게 형식과 유효한 움직임 문법을 가르치는 것이 목적이다.
SFT를 위한 합성 데이터는 잘 구축된 환경이 있다면 단 하나의 명령어로 생성할 수 있다. 강연자는 형식을 완벽하게 준수하는 GPT-4o mini를 사용해 200개의 게임을 생성하고, 지는 게임은 필터링해 잘못된 전략에 대한 힌트를 주지 않도록 했다. 이렇게 생성된 합성 데이터로 PrimeRL을 활용해 몇 분 만에 SFT 훈련을 완료할 수 있었다. 96GB GPU를 사용했지만 더 작은 GPU에서도 가능하다고 한다. SFT 이후 모델은 형식 준수가 거의 완벽해지고 유효하지 않은 움직임도 줄어들었으며, 게임 성능도 개선되었다. 그러나 여전히 갈 길이 남아 있었다.
GRPO 기반 RL 훈련 — 원리와 실행
💡 [영상 참조] 강연자는 GRPO의 동작 과정을 슬라이드로 시각화하여 설명합니다. 📺 원본 영상에서 확인하세요.
GRPO를 틱택토에 적용하는 원리를 정리하면 다음과 같다. 먼저 동일한 초기 보드 상태에서 출발해 LLM 샘플링으로 여러 게임을 플레이한다(롤아웃). 각 롤아웃은 승리 보상, 형식 보상, 유효하지 않은 움직임 페널티로 구성된 결정론적 보상 함수로 평가된다. 이후 롤아웃 그룹에 걸쳐 평균 점수가 산출되고, 각 롤아웃은 이 평균과 비교된다(어드밴티지 계산). 마지막으로 모델은 그룹 기준선을 상회한 궤적을 따르도록 업데이트된다.
실제 훈련에서 강연자는 Verifiers의 RL Simple Trainer를 사용하며, 추론용 GPU와 훈련용 GPU를 각각 하나씩 할당한다. 훈련 설정에서 무작위 수 선택 확률은 20%에서 70% 사이로 설정되었는데, 이는 완전히 무작위인 상대도, 완전히 최적인 상대도 배제해 공격과 방어 모두에서 학습 신호를 얻을 수 있는 적절한 훈련장이다. GRPO의 개선 버전인 CISPO[정확한 알고리즘명은 원본 영상 참조]가 RL 알고리즘으로 사용되었다.
강연자가 가장 강조하는 훈련 파라미터 중 하나는 배치 크기다. 256 미만의 배치 크기에서는 불안정한 훈련과 모델 붕괴(model collapse)를 관찰했다. 그 이유는 직관적이다. 배치 크기가 작다는 것은 아주 적은 수의 게임과 상대 유형으로부터 학습한다는 의미이고, 이는 최적이 아닌 전략이 강화될 가능성으로 이어진다.
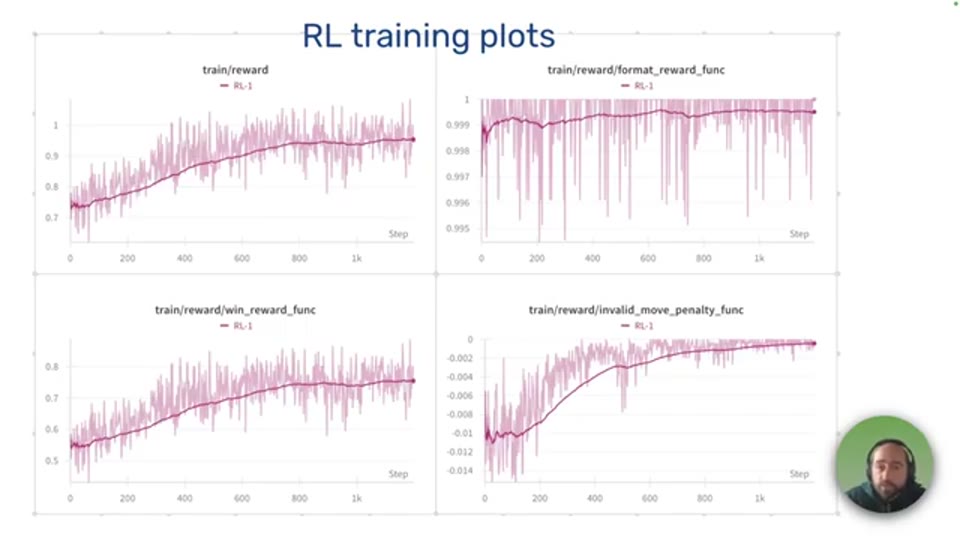
30:57 - RL 훈련 중 승리 보상, 형식 보상, 유효하지 않은 움직임 페널티의 시간에 따른 변화 학습 곡선
학습 곡선에서는 승리 보상과 총 보상이 꾸준히 향상되었고, 형식 보상은 이미 거의 완벽한 수준에서 시작해 큰 변화가 없었다. 유효하지 않은 움직임 페널티는 초반에 양호한 수준에서 시작해 훈련 말미에는 0에 수렴했다. RL 훈련 결과, 이 모델은 무작위 플레이어를 압도하고 최적 상대를 상대로도 85%의 확률로 무승부를 이끌어냈으며, 유효하지 않은 움직임은 거의 사라졌다.
완벽을 향한 추가 훈련 — 탐험의 힘
85% 무승부도 인상적이지만, 강연자는 완벽한 AI 플레이어를 목표로 심화 훈련을 시도했다. 롤아웃을 검토하던 중 포크(fork) 트랩에 빠지는 반복적인 실패 패턴을 발견했다. 이 함정은 상대방에게 두 개의 동시 승로를 허용해, 어떤 방어를 해도 막을 수 없는 상황이다.
이를 돌파하기 위해 먼저 상대 강도를 높였다. 무작위 수 선택 확률을 0%에서 25%로 좁혀 더 강한 상대를 만나도록 했다. 완전히 완벽한 상대만을 상대로 훈련하는 것도 시도했지만, 오히려 역효과였다. 모델이 지나치게 방어적으로 변해 상대가 실수를 할 때 그것을 공략하지 못했다. 다음으로 탐험을 촉진하기 위해 생성 온도(temperature)를 높였다. 온도가 너무 높으면 무의미한 출력이 나올 위험이 있지만, 적절한 수준에서는 새로운 전략을 발견하는 촉매가 된다.
학습 곡선에서는 초반에 승리 보상과 총 보상의 급격한 하락이 나타났는데, 강연자는 이를 탐험 단계로 해석했다. 모델이 새롭고 무작위적인 전략을 시도하면서 단기적으로 성능이 낮아졌지만, 시간이 지나면서 새로운 최고 수준으로 회복되고 향상되었다. 형식 보상과 유효하지 않은 움직임 페널티는 초반의 소폭 하락을 제외하면 항상 최대치 근방에 머물렀다.
이 심화 훈련의 최종 결과는 놀랍다. 최적 상대를 상대로 무승부 달성률이 더욱 높아졌고, 이 소형 모델은 자신의 합성 데이터 생성에 사용된 교사 모델인 GPT-4o mini를 최적 상대 대결에서 능가하는 수준에 이르렀다.
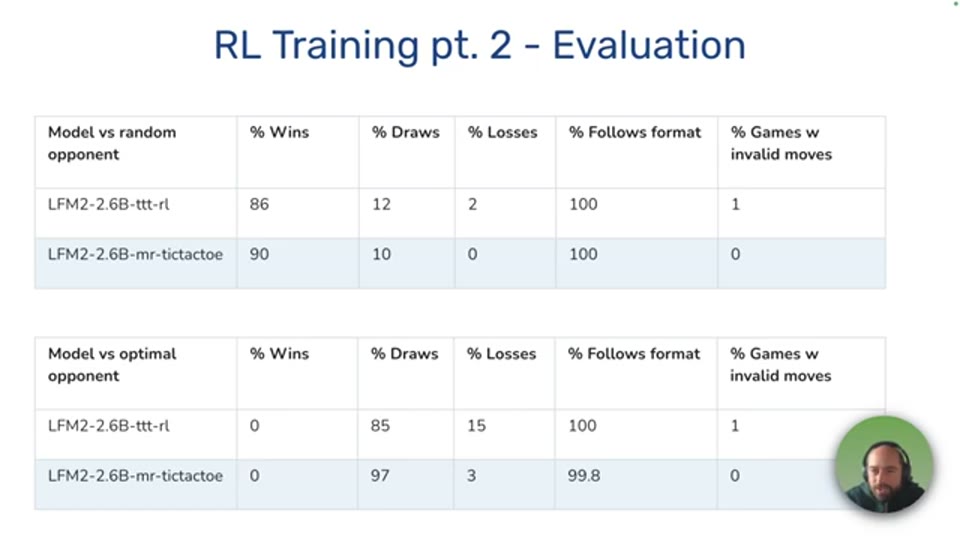
34:14 - 심화 RL 훈련 후 최종 평가 결과 — 최적 상대 대비 무승부율, GPT-4o mini와의 비교
실패에서 배운 교훈들
강연자는 이 결과를 얻기까지 여러 번의 실패 실험을 거쳤으며, 그 교훈을 솔직하게 공유한다.
배치 크기의 결정적 역할: 배치 크기가 크면 학습 속도가 느린 것처럼 보이지만, 그 대신 안정적인 훈련이 보장된다. 배치 크기가 작고 환경이 다양한 게임과 상대 강도를 만들어낸다면, 모델은 한 번에 아주 적은 수의 게임만으로 학습하게 되어 최적이 아닌 전략이 강화되거나 불안정한 훈련, 심지어 모델 붕괴가 발생할 수 있다.
환경 구현의 세부 사항이 훈련을 좌우한다: 이전 실험에서 강연자는 최적 상대를 위한 미니맥스 알고리즘의 특정 구현을 사용했는데, 이것이 편향을 만들어냈다. 여러 움직임의 점수가 동일할 때 항상 첫 번째 위치를 선택하는 방식이었는데, 오랜 훈련을 거치면서 모델은 이 알고리즘의 패턴을 통째로 암기해버렸다. 벤치마크 결과는 훌륭했지만, 실제로 플레이해보니 다른 유형의 최적 플레이어를 만나면 무력했다. 환경의 ‘구현 세부 사항’이라고 가볍게 여긴 것이 훈련 전체를 망친 사례다.
모델 선택에 대한 신중한 고려: 이미 추론을 위해 훈련된 모델에서 시작하는 것은 좋아 보이지만, 이런 모델은 긴 사고 흔적을 생성하는 경향이 있다. GPU 리소스와 시간이 제한적이라면 긴 완성물의 대부분이 잘릴 수 있고, 이는 예산 낭비와 모델 지능 손상의 위험을 낳는다. 대신 기본(base) 또는 인스트럭트 모델에서 시작해 특정 태스크에 맞는 추론 모델로 변환하는 것이 더 합리적일 수 있다. 또한 매우 소형 모델을 고도로 복잡한 태스크에 적용하는 것은 어려울 수 있으므로, 훈련 전에 기본 모델을 환경에서 평가하고 수십 개의 완성물을 직접 살펴보며 유망한 행동을 보이는 모델을 선택하는 것이 권장된다.
인내와 절제: 강화학습은 느리고 진전을 확인하는 데 시간이 걸린다. 훈련 중에 계속 플롯을 들여다보면서 조기에 개입하고 싶은 유혹이 생기지만, 천천히 진행되는 훈련 런도 충분한 시간을 주면 놀라운 결과를 낼 수 있다. 훈련이 안정적으로 시작되었다면, 로그를 닫고 산책을 다녀오라고 강연자는 조언한다.
마무리 — 탐험의 공간을 설계하는 것이 핵심이다
이 강연의 여정은 단순히 틱택토를 잘 두는 모델을 만드는 것에 그치지 않는다. 강연자가 전달하는 핵심 메시지는 우리가 모델에게 ‘어떻게 플레이할지’를 직접 가르치는 대신, 모델이 ‘플레이할 공간’을 제공하고 보상으로 안내했을 때 훨씬 강력한 결과가 나온다는 것이다. 인간의 전문 지식을 모방하는 통계적 학습(SFT)이 가진 천장을 RL이 돌파할 수 있음을 실증적으로 보여준다.
오늘날 RL은 언어 모델의 포스트 트레이닝(post-training)에서 SFT를 보완하는 핵심 도구로 자리 잡고 있다. 그리고 이것은 대형 연구소만의 전유물이 아니다. Verifiers와 같은 오픈소스 라이브러리, Environments Hub와 같은 커뮤니티 자원을 활용하면, 명확한 보상 신호만 정의할 수 있다면 누구든 집에서 소형 특화 모델을 훈련해 특정 태스크에서 대형 클로즈드 모델을 능가할 수 있다. 강연자는 2~3개의 자주 사용하는 도구에 소형 언어 모델을 훈련시켜 특정 태스크에서 대형 모델을 이기는 것을 다음 도전 과제로 제시하며, WikiSearch 환경을 출발점으로 추천한다.
📚 참고 자료 (강연 내용과 별개)
아래 자료는 강연에서 직접 소개된 것이 아니며, 리포트 독자의 이해를 돕기 위해 별도로 정리한 참고 자료입니다.
이 강연에서 언급된 핵심 개념들을 더 깊이 탐구하고 싶다면 아래 방향을 참고할 수 있다. Verifiers 라이브러리는 Prime Intellect에서 관리하는 GitHub 저장소에서 찾을 수 있으며, DeepSeek-R1의 기술 보고서는 GRPO 알고리즘과 검증 가능한 보상을 통한 RL 훈련의 세부 원리를 담고 있다. Andrej Karpathy가 언급한 “통계적 전문가 모방을 넘어서”라는 맥락은 그의 LLM에 대한 강연들에서 더 자세히 다루어진다. 미니맥스(minimax) 알고리즘은 게임 이론의 고전적 개념으로, 완전한 정보를 가진 2인 제로섬 게임에서 최적 전략을 계산하는 방법론이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Let LLMs Wander: Engineering RL Environments — Stefano Fiorucci |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-04-08 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 화면에 표시된 코드, 슬라이드, 학습 곡선 그래프 등은 STT 특성상 포함되지 않을 수 있으며, 정확한 내용은 원본 영상을 참조해 주세요.