Under 5 Minutes to a Deployed LLM Endpoint
📺 원본 영상: Under 5 minutes to a deployed LLM endpoint — Audry Hsu, RunPod 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-08 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
RunPod의 Audry Hsu가 AI Engineer 컨퍼런스에서 진행한 이 세션은, 클라우드 AI 인프라 플랫폼 RunPod를 이용해 5분 이내에 LLM 추론 엔드포인트를 배포하는 과정을 실시간 데모로 보여주는 입문 강연이다. 인프라 관리의 복잡성을 추상화해 개발자가 빌딩에만 집중할 수 있도록 돕는다는 RunPod의 핵심 철학과 함께, Serverless 기능을 통해 Hub에서 오픈소스 LLM을 선택하고 배포하기까지의 전 과정을 직접 시연한다.
RunPod란 무엇인가 — 클라우드 AI 인프라의 새로운 접근
RunPod는 GPU 하드웨어를 직접 보유하고 운영하는 클라우드 AI 인프라 기업이다. 강연자 Audry Hsu는 RunPod가 해결하려는 문제를 세 가지 축으로 압축해 설명했다. 첫 번째는 인프라 관리의 복잡성이다. AWS나 Google Cloud가 등장하기 이전, 개발자들이 온프레미스(on-premises) 서버를 직접 유지·보수해야 했던 시대를 상기시키며, GPU 인프라 역시 그 부담을 개발자가 지지 않아도 되는 방향으로 나아가야 한다고 강조했다. 두 번째는 GPU 접근성의 문제다. 강연이 이루어진 시점에서도 전 세계적으로 GPU 공급 부족이 지속되고 있었으며, 이를 코로나 시기의 화장지 사재기에 비유해 현실적인 공급망 과부하를 유머러스하게 설명했다. 다만 강연자는 기업들이 자신에게 필요한 컴퓨팅 자원을 좀 더 정교하게 예측하기 시작하면서 시장이 점차 안정될 것이라고 내다봤다. 세 번째이자 가장 본질적인 포인트는, 개발자의 가치는 인프라를 관리하는 데서가 아니라 애플리케이션을 빌드하는 데서 나온다는 것이다. RunPod의 존재 이유가 바로 이 철학에서 비롯된다.
지하실 GPU 두 대에서 ARR $120M까지 — 창업 스토리
RunPod의 창업 스토리는 실리콘밸리의 전형적인 서사와는 거리가 멀다. 공동창업자 Zen과 Pardeep은 2022년 지하실에 몇 대의 GPU 리그(rig)를 두고 크립토 마이닝을 시도했지만 결국 실패로 끝났다. 남겨진 GPU를 활용하기 위해 그들이 선택한 방법은 Reddit에 올린 짧은 글이었다. “이 GPU를 무료로 써보실 분 계세요? 피드백만 주세요.” 이 단순한 제안이 RunPod의 씨앗이 되었고, 이후 줄곧 수익을 창출해왔다. 강연자가 이 이야기를 강조하는 이유는 단순히 부트스트랩(bootstrap) 정신을 자랑하기 위해서가 아니라, RunPod의 DNA가 처음부터 커뮤니티와의 밀착에 있었음을 설명하기 위해서다. Reddit과 Discord에서의 활발한 사용자 소통은 지금도 이어지며, 강연자는 “완벽하다고 약속할 수는 없지만, 우리는 커뮤니티와 적극적으로 소통하고 있다”고 직접 밝혔다. 현재 RunPod는 50만 명 이상의 개발자, 전 세계 30개 이상의 데이터센터(EU 포함), 그리고 연간 반복 수익(Annual Recurring Revenue, ARR) $120M이라는 지표를 보유하고 있으며, 고객사 중에는 클라우드 네이티브 AI 기업들도 포함되어 있다.
RunPod의 제품 라인업 — 용도별 선택지
RunPod의 핵심 제품군은 크게 네 가지로 구성되며, 각각의 용도와 적합한 워크로드가 명확히 구분된다.
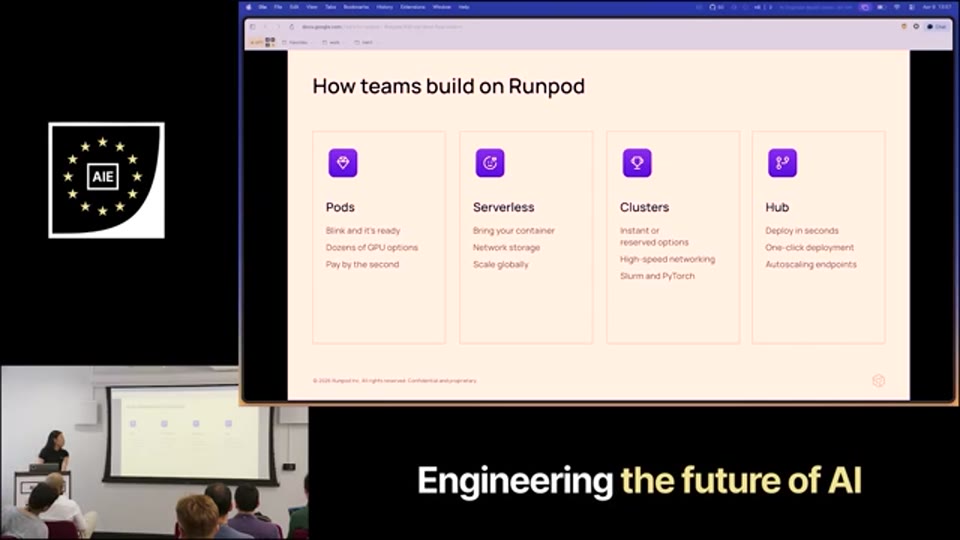
04:13 - RunPod 제품 라인업(Pods, Serverless, Clusters, Hub) 고수준 개요 슬라이드
Pods는 RunPod의 기본 환경이다. Docker 컨테이너 기반의 샌드박스 가상 환경으로, GPU가 할당된 컨테이너를 스핀업(spin up)해 제공한다. 사용자는 Dockerfile과 코드만 준비하면 되며, 나머지는 RunPod가 처리한다.
Serverless는 RunPod의 오토스케일링(auto-scaling) 제품으로, 이번 강연의 핵심 주제다. Pods가 ‘항상 켜져 있는’ 컨테이너라면, Serverless는 유휴 상태일 때 워커(worker)가 자동으로 종료되는 구조다. 따라서 요청이 없는 시간에는 비용이 발생하지 않으며, 트래픽이 일정하지 않은 버스트(burst) 워크로드나 배치(batch) 처리에 특히 적합하다.
Clusters는 멀티노드(multi-node) 고속 네트워킹이 필요한 대규모 학습(training) 워크로드를 위한 제품이다.
Hub는 RunPod의 AI 레포지토리 허브로, 사전 구성(pre-configured)되고 검증된 오픈소스 AI 리포지토리가 모여 있다. RunPod 공식 리스팅뿐 아니라 커뮤니티 기여 리포지토리도 포함되어 있으며, Fork·Star·배포가 모두 이 허브에서 이루어진다.
5분 실시간 데모 — Hub에서 서버리스 LLM 엔드포인트까지
강연의 하이라이트는 RunPod 웹 콘솔을 이용한 실시간 배포 데모였다. 강연자는 CLI(Command Line Interface) 지원도 있고, 에이전트와 연동할 수 있는 SDK도 준비되어 있다고 언급했지만, 청중이 직관적으로 따라올 수 있도록 웹 콘솔을 선택했다.
💡 [영상 참조] 이 구간부터 강연자는 RunPod 웹 콘솔 화면을 직접 시연합니다. 📺 상세 UI 흐름은 원본 영상을 확인하세요.
시연은 Hub에서 LLM 리스팅을 선택하는 것으로 시작되었다. 선택된 리포지토리는 일반적인 GitHub 레포지토리 그 자체였으며, Dockerfile이 이미 사전 구성된 상태로 포함되어 있었다.
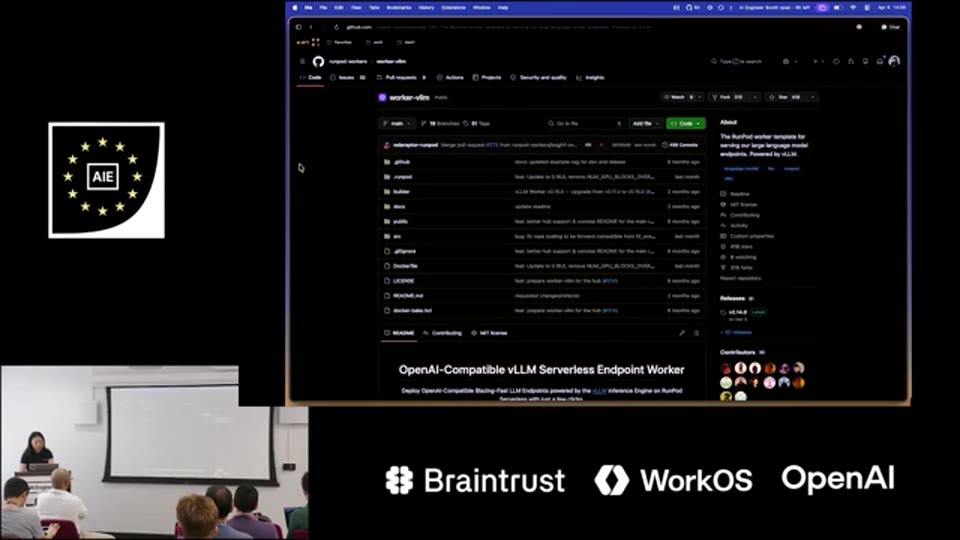
07:49 - Hub에서 선택한 LLM 리스팅의 GitHub 레포 화면 — 사전 구성된 Dockerfile 확인
환경 변수를 통해 원하는 설정을 전달할 수 있는 구조이지만, 강연자는 고급 옵션(advanced options)에서 최대 모델 길이(max model length), 즉 컨텍스트 윈도우(context window) 크기만 조정하고 나머지는 기본값을 그대로 사용했다. 이 설정들은 내부적으로 vLLM serve의 플래그(flag)로 그대로 전달되는 구조다.
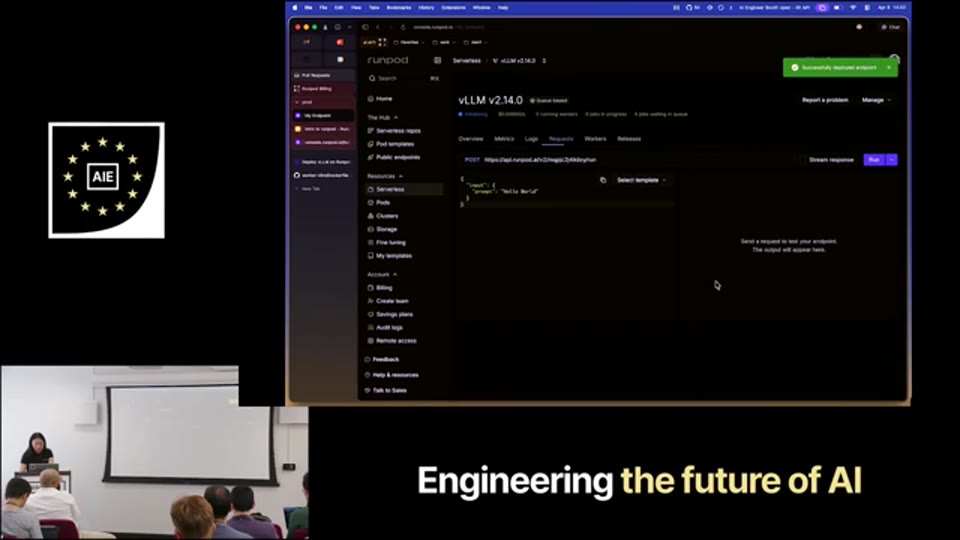
09:16 - 서버리스 엔드포인트 설정 화면 — vLLM serve 플래그 및 고급 옵션(max model length 등)
모델 가중치는 Hugging Face에서 다운로드되는 방식이었으며, 배포 버튼 클릭만으로 전 과정이 시작되었다.
배포된 엔드포인트는 기본 설정 기준으로 H100을 우선 할당하고, 여의치 않을 경우 A100을 백업으로 사용하는 방식이었다. 비용은 워커가 실제로 요청을 처리하는 동안에만 발생하며, 강연자가 보여준 단가는 초당 1센트(cent)의 일부(fraction) 수준이었다. 설정 가능한 주요 파라미터로는 최대 워커 수(max workers, 예시에서는 최대 15개까지 스케일업 가능)와 항상 켜두는 Active 워커 수가 있었고, Active 워커를 지정하면 모델이 이미 로드된 상태를 유지해 요청에 즉시 응답할 수 있다.
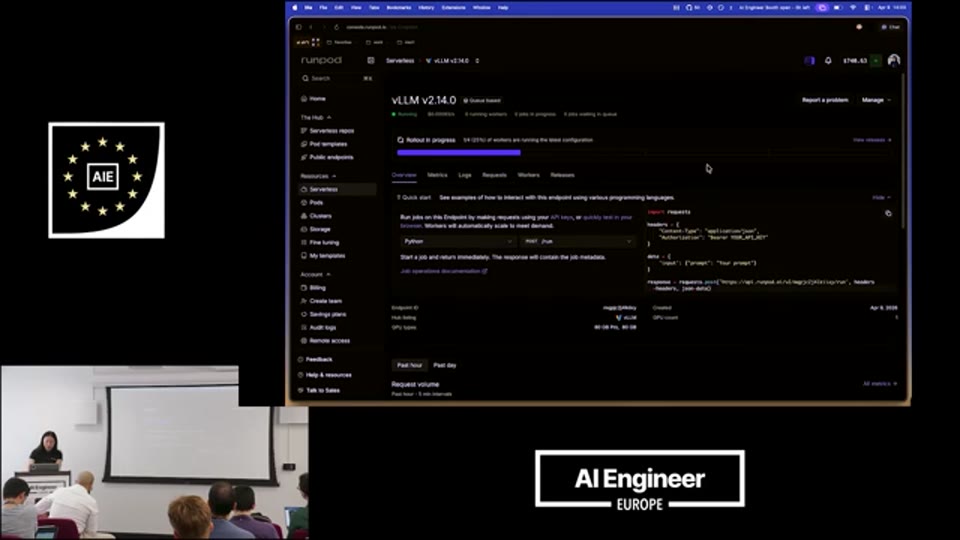
10:22 - 배포된 서버리스 엔드포인트 API HTTP 화면 및 워커 설정(max workers, active workers, 가격 정보)
요청 테스트는 콘솔 내 API HTTP 엔드포인트를 통해 직접 수행되었다. 첫 번째 요청의 큐 대기 시간은 약 41초로 다소 길었는데, 이는 초기 콜드 스타트(cold start)에 기인한 것으로 모델 다운로드와 첫 컨테이너 초기화에 걸리는 시간이 포함되었기 때문이다. 그러나 실제 추론 실행 시간(execution time)은 약 1.5초에 불과했다.
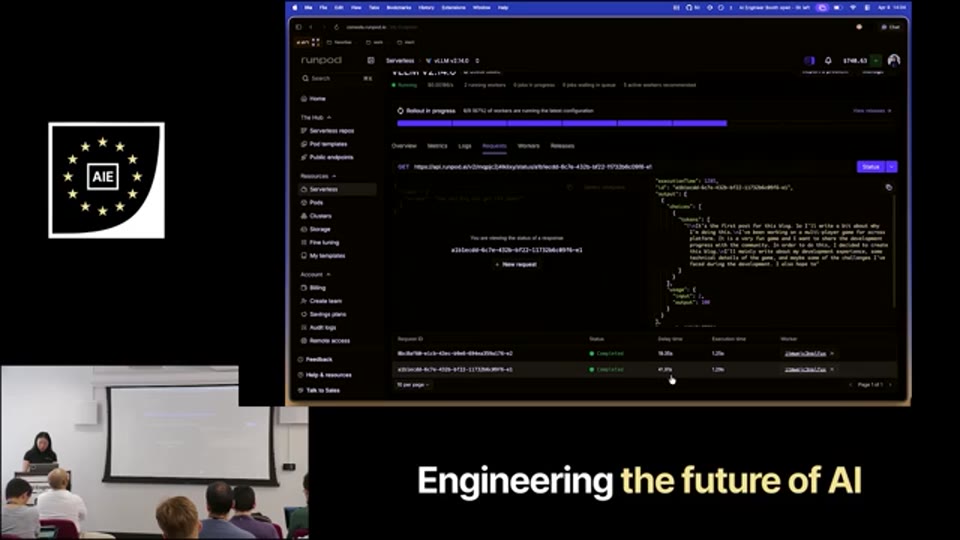
11:48 - 첫 번째 LLM 요청 완료 결과 화면 — 큐 대기 약 41초, 실행 시간 약 1.5초
강연자는 이후 요청들은 콜드 스타트 없이 훨씬 빠르게 처리될 것이라고 부연했다. 콘솔에서는 요청 수, 실행 시간, 지연 시간(latency) 등 엔드포인트 운영에 대한 관측성(observability) 텔레메트리도 실시간으로 제공되었다.
11:29 - 엔드포인트 텔레메트리 대시보드 — 요청 수, 실행 시간, 지연 시간 등 관측성 지표
Serverless를 선택해야 하는 이유
Serverless가 프로덕션 API 배포의 첫 번째 선택지로 주목받는 이유는 명확하다. 사전에 필요한 컴퓨팅 자원을 예측하고 프로비저닝(provisioning)할 필요 없이, 수요에 따라 자동으로 스케일업·다운되기 때문이다. 이는 트래픽 패턴이 일정하지 않은 초기 서비스나 스타트업 환경에서 비용 효율성을 극대화하는 핵심 요소다. 또한 스펜딩 캡(spending cap)을 설정해 예산 초과를 방지할 수 있고, 응답 지연이 허용되지 않는 서비스에는 Active 워커를 일부 유지해 콜드 스타트 문제를 실질적으로 완화할 수 있다. 결국 Serverless는 경량 추론부터 프로덕션 수준의 실시간 API까지 폭넓게 활용 가능한 유연한 인프라 레이어로, 강연자가 말한 “가장 빠르게 프로덕션 레디 API를 배포하는 방법”이라는 평가는 이 데모를 통해 직접 증명되었다.
마무리 / 핵심 정리
이번 강연은 짧고 간결했지만, RunPod의 핵심 가치 제안을 명확하게 전달했다. GPU 인프라의 복잡성을 제거하고, 개발자가 코드와 모델에만 집중할 수 있도록 하는 것이 RunPod가 추구하는 방향이다. Hub에서 리스팅을 선택하고 배포 버튼을 누르는 것만으로 vLLM 기반의 LLM 추론 엔드포인트를 5분 내에 운영 가능한 상태로 만드는 경험은, 이 플랫폼이 지향하는 바를 그 자체로 증명한다. 강연자는 같은 날 오후 4시에 진행되는 추가 세션에서 RunPod Python SDK를 활용한 터미널 기반 배포 방법과 원격 GPU 함수(remote function) 실행, 그리고 프로덕션 레디 엔드포인트 구성을 더 심층적으로 다룰 예정임을 밝히며 강연을 마무리했다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Under 5 minutes to a deployed LLM endpoint — Audry Hsu, RunPod |
| 채널 | AI Engineer |
| 영상 길이 | 약 13분 |
| 리포트 작성 | 2026-06-08 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.