What Lies Beneath the API — 파인튜닝이 선택이 아닌 필연이 되는 순간
📺 원본 영상: What Lies Beneath the API — Benjamin Cowen, Modal 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-06-03 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Modal의 Forward Deployed Machine Learning Engineer인 Benjamin Cowen은 AI 애플리케이션 개발 현장에서 반복적으로 목격하는 패턴 하나를 이 강연의 핵심 주제로 제시한다. 제품이 성숙하고 특화될수록, Frontier API에만 의존하던 기업들이 점차 파인튜닝(Fine-tuning)으로 선회한다는 흐름이다. 이 강연은 단순한 파인튜닝 홍보를 넘어, ‘언제 파인튜닝이 필요한가’라는 본질적인 질문을 던지며, 현재의 오픈소스 생태계와 서버리스 컴퓨팅 환경이 이 전환을 얼마나 현실적으로 쉽게 만들었는지를 구체적으로 설명한다.
Frontier API의 한계: 빠름과 유연함의 트레이드오프
오늘날 Frontier API(GPT, Claude 등 최전선 모델의 API)는 AI 애플리케이션 개발의 판도를 완전히 바꾸어 놓았다. 이전에는 수개월이 걸리던 기능을 수일 만에 구현할 수 있고, 누구나 강력한 AI 역량을 바탕으로 제품을 만들 수 있는 환경이 열렸다. 강연자는 이 변화를 “완전히 새로운 가속 성장의 시대를 열었다”고 표현하며 그 공로를 인정한다.
그러나 이 편리함에는 구조적 한계가 내재되어 있다. Frontier API는 프롬프트 엔지니어링 이상의 커스터마이징을 허용하지 않는다. 강연자는 “Caveman Mode”라는 사례를 든다. LLM에게 원시인처럼 짧게 말하라고 지시하면 토큰 수를 대폭 줄일 수 있지만, 스타트업이 100배, 1000배 성장하는 상황에서 이런 식의 임시방편이 통할 리 없다는 것이다. 더욱이 대형 엔터프라이즈 계약을 수주하면 특정 레이턴시(Latency)나 처리량(Throughput) 요구사항이 따라오기 마련인데, Frontier API는 이러한 조건에 맞게 최적화할 여지가 사실상 없다. 비즈니스 로직을 반영하는 커스텀 평가 지표(Custom Evaluation Metric)를 정의하고 모델을 그에 맞게 조정하는 것도 불가능하다.
모델 스펙트럼: 전부 아니면 전무의 시대는 끝났다
강연자는 AI 모델 활용 방식을 하나의 스펙트럼으로 시각화한다. 한쪽 끝에는 간편하지만 커스터마이징이 불가한 Frontier API가 있고, 반대쪽 끝에는 완전한 제어권을 갖지만 막대한 인프라 부담이 따르는 자체 학습 및 서빙 방식이 있다.
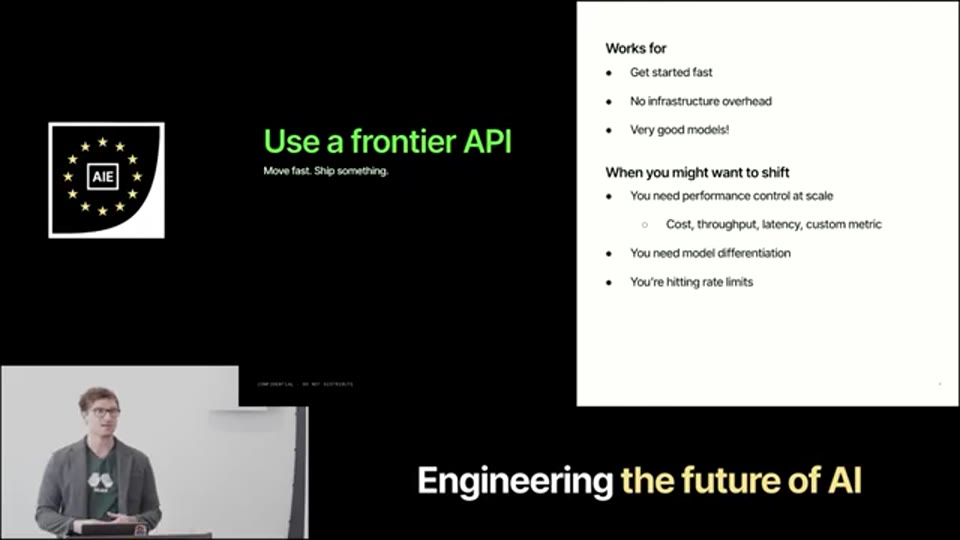
02:51 - Frontier API vs 자체 학습의 스펙트럼 시각화 슬라이드 — 양극단의 특성과 새로운 중간 지대 설명
전통적으로 파인튜닝을 선택한다는 것은 스펙트럼의 반대편 끝으로 도약하는 것을 의미했다. 프로덕션 워크로드와 완전히 분리된 대형 클러스터가 필요하고, 인프라 전문 엔지니어를 별도로 고용해야 하며, AI 과학자들조차 모델 연구 대신 인프라 관리에 시간을 쏟아야 하는 현실이 기다리고 있었다. 이 모든 책임을 감당해야 했기 때문에 많은 스타트업들이 그 선택을 무기한 미루어 왔다. 그러나 강연자는 이 양극단 사이에 새로운 중간 지대가 형성되고 있다고 말한다. Modal과 같은 새로운 유형의 클라우드 제공업체들이 이 간극을 메우고 있으며, 이것이 상황을 근본적으로 바꾸고 있다는 것이다.
파인튜닝의 비즈니스 임팩트: 숫자가 말하는 이유
이론적 논거보다 더 설득력 있는 것은 실제 기업들의 성과다. 강연자는 여러 레퍼런스 케이스를 언급한다. Intercom은 Frontier API 대비 5분의 1 비용으로 동등하거나 그 이상의 성능을 달성했다. Pinterest는 “자릿수 자체가 다른(orders of magnitude)” 수준의 개선을 이루었다고 발표했다.
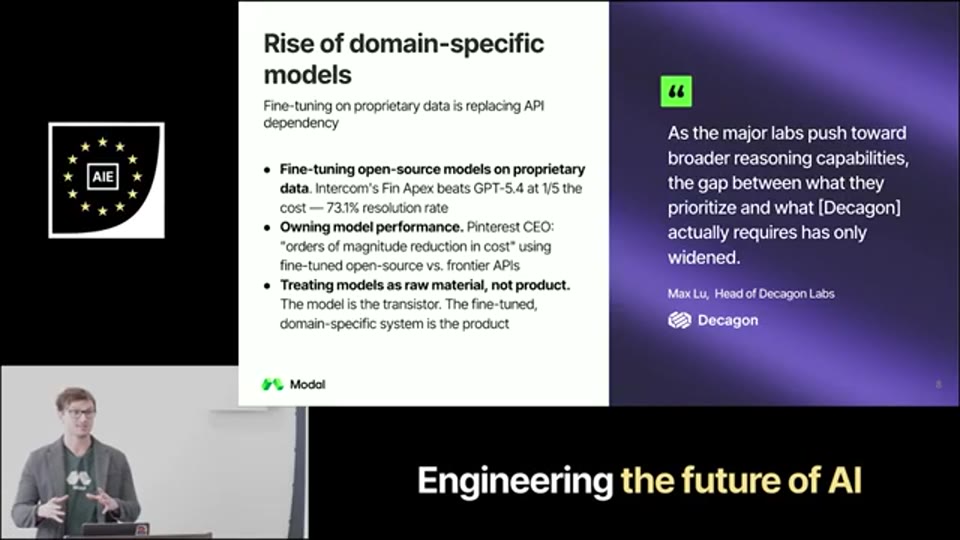
04:43 - 파인튜닝 성과 기업 사례 슬라이드 — Intercom(1/5 비용), Pinterest(orders of magnitude), Decagon 언급
이 맥락에서 강연자는 Modal의 고객사인 Decagon의 통찰을 인용한다. “Frontier 랩들은 당신과 정확히 같은 목표를 갖고 있지 않다”는 것이다. Frontier 모델을 만드는 기업들은 가능한 모든 태스크에서 최고의 성능을 내는 범용 모델을 원한다. 그러나 개별 기업이 필요한 것은 자신이 고객에게 제공하는 서비스, 즉 특정 비즈니스 로직에서만큼은 최고인 모델이다. 이 두 목표 사이의 차이가 파인튜닝의 근본적인 존재 이유이며, 범용 모델과 특화 모델 사이의 성능 갭을 설명한다.
파인튜닝을 시작해야 할 신호들
강연자는 파인튜닝을 “지금 당장 해야 할 것”이라고 강요하지 않는다. 대신 그 시점이 다가오고 있음을 알려주는 몇 가지 신호를 제시한다.
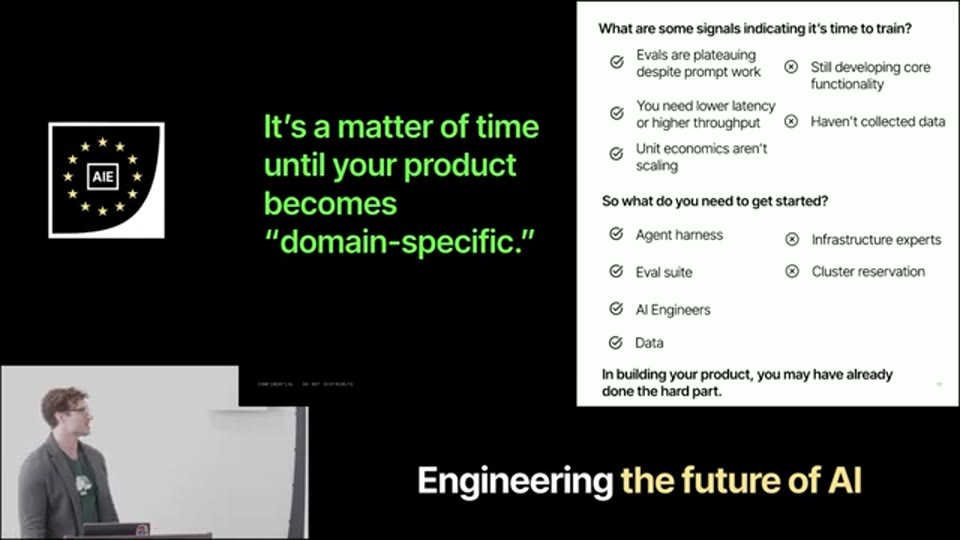
07:03 - 파인튜닝 전환 시점을 알려주는 신호(Signals) 슬라이드 — API 비용, 레이턴시, Eval 정체 등
가장 명확한 경제적 신호는 API 비용이 고객으로부터 받는 수익을 초과하는 상황이다. Caveman Mode 같은 극단적인 최적화를 이미 시도했음에도 불구하고 단가가 맞지 않는다면, 커스터마이징된 인퍼런스 엔드포인트(Inference Endpoint)가 해결책이 될 수 있다. 레이턴시나 처리량 면에서 특정 SLA(Service Level Agreement)를 충족시키지 못하고 있을 때도 마찬가지다.
기술적 신호로는 평가 지표(Eval)의 정체(Plateau)를 꼽을 수 있다. 프롬프트를 아무리 다듬어도 성능이 더 이상 나아지지 않는다면, 모델 자체를 해당 도메인에 맞게 학습시키는 것이 다음 단계다. 단, 강연자는 중요한 전제 조건을 함께 언급한다. “쓰레기를 넣으면 쓰레기가 나온다(Garbage in, garbage out)“는 오래된 격언처럼, 데이터를 수집하지 않았거나 성숙한 평가 체계가 없다면 아직 파인튜닝을 시작할 때가 아니다. 이 경우에는 먼저 데이터 수집에 집중해야 한다.
이미 가진 것들: 당신은 이미 준비되어 있다
이 강연에서 가장 중요한 메시지 중 하나는 “이미 제품을 만든 사람이라면, 파인튜닝에 필요한 재료를 이미 손에 쥐고 있을 가능성이 높다”는 것이다. 이 통찰은 파인튜닝을 먼 미래의 과제로 인식하는 개발자들에게 즉각적인 관점 전환을 요구한다.
에이전트 하네스(Agent Harness)를 구축했다면, 그 구조 자체가 강화학습(Reinforcement Learning, RL)을 통해 모델이 서비스 제공 방법을 학습하게 하는 환경이 된다. 제품을 평가하고 무엇이 잘 작동하고 무엇이 실패하는지 데이터를 수집하고 있다면, 그것이 곧 학습 데이터(Training Data)다. 강연자는 과거에 자신이 경사도(Gradient)를 손으로 계산하고 선형대수를 직접 구현해야 했던 시절을 회상하며, 그 진입 장벽이 이제는 완전히 사라졌음을 강조한다. 인프라 전문가가 없어도 된다. 그 장벽 자체가 더 이상 존재하지 않는다.
현재의 도구들: 300줄의 Python으로 시작하는 파인튜닝
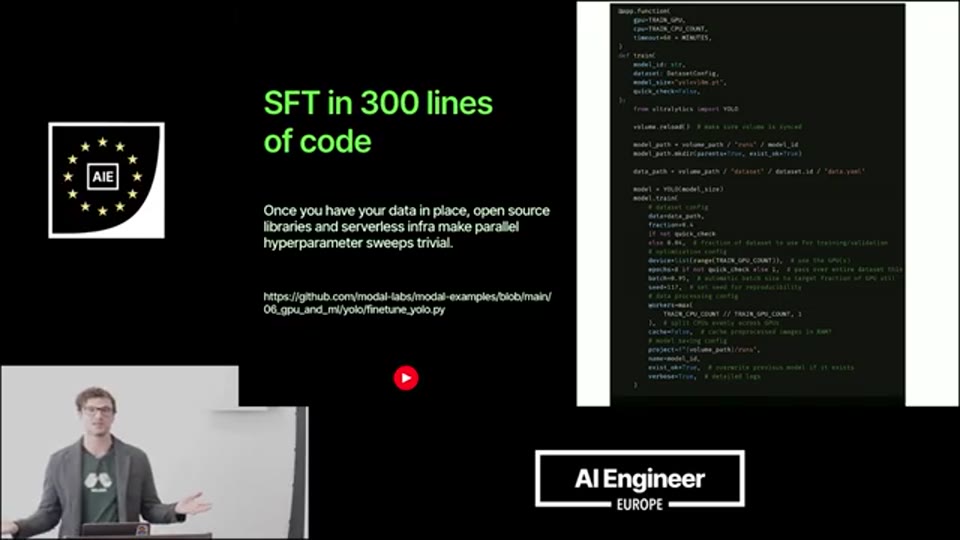
08:44 - Supervised Fine-tuning 코드 스니펫 화면 — 300줄 Python으로 구현 가능함을 보여주는 예제
오늘날의 오픈소스 생태계는 파인튜닝의 진입 장벽을 극적으로 낮추었다. 강연자에 따르면, Supervised Fine-tuning(SFT, 지도 파인튜닝)은 약 300줄의 Python 코드로 구현이 가능하다. 이 라이브러리들은 알고리즘 수준의 완전한 제어권을 제공하면서도, 클러스터 관리 같은 인프라 복잡성을 추상화해 준다. 데이터를 큐레이션하고 Modal 같은 서버리스 플랫폼에 계정을 만들면 빠르게 시작할 수 있다고 강연자는 말한다.
서버리스 컴퓨팅이 파인튜닝에 가져다 주는 이점은 인퍼런스에서와는 다른 차원에서 나타난다. 하이퍼파라미터 튜닝(Hyperparameter Tuning)이 대표적인 예다. 기존에는 클러스터 위에서 하나씩 순차적으로 실험을 돌려야 했기 때문에 매 분, 매 시간이 소중했다. 서버리스 환경에서는 수십 개의 컨테이너를 온디맨드(On-demand)로 병렬 실행해 가능성 없어 보이는 실험은 즉시 종료하고, 유망한 실험에 자원을 집중시킬 수 있다. 강연자는 이를 “거의 메타 진화 알고리즘(Meta Evolutionary Algorithm)에 가까운 탐색 방식”이라고 표현한다.
강화학습의 대중화: 50,000개의 샌드박스
강화학습(Reinforcement Learning, RL)은 최근 10년간 대학원에서 ML을 공부한 이들에게조차 다소 낯선 영역이었다. 이론적 뿌리가 수십 년 전으로 거슬러 올라가지만, 오늘날 실용적으로 활용되는 기법들은 비교적 최근에 발전했기 때문이다. 그러나 강연자는 이 영역도 SFT와 마찬가지로 약 300줄의 코드로 시작할 수 있다고 말한다.
RL 학습의 핵심 특성은 모델이 반복적인 시뮬레이션, 즉 롤아웃(Rollout)을 통해 학습한다는 점이다. 이 과정은 “당혹스러울 만큼 병렬화하기 좋은(Embarrassingly Parallel)” 구조를 갖고 있어, 서버리스 아키텍처와 궁합이 매우 잘 맞는다. Modal이 제공하는 샌드박스(Sandbox)와 GPU 컨테이너에 대한 통합 API가 여기서 강점을 발휘한다. 강연자는 최근 고객들이 RL 롤아웃 실행을 위해 50,000개에서 100,000개의 샌드박스를 동시에 띄운 사례를 소개하며, 이 코드 역시 오픈소스로 공개되어 있어 누구나 시도해 볼 수 있다고 덧붙인다.
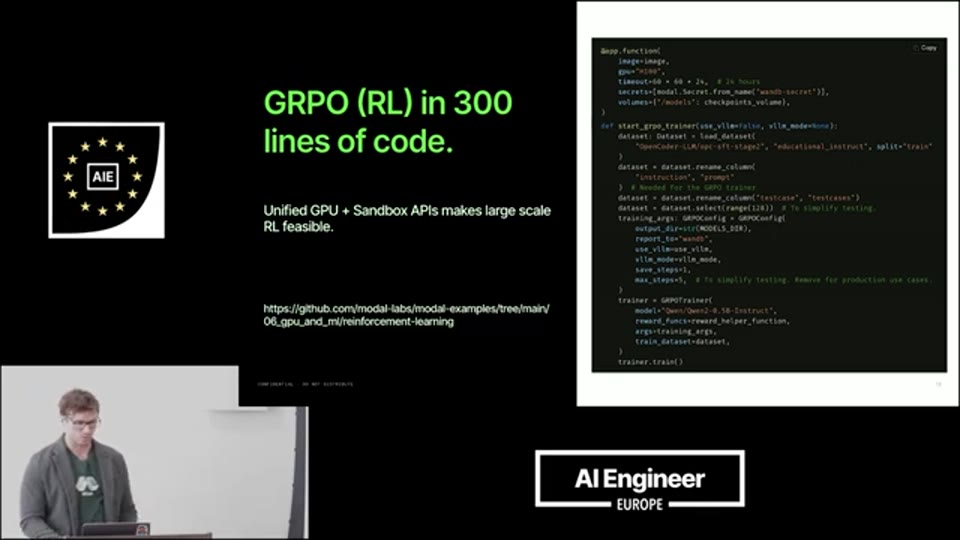
10:50 - RL 롤아웃을 위해 50,000~100,000개 샌드박스를 동시 스케일 업한 고객 사례 설명
학습 이후: 서빙 스택의 완성
모델 학습이 끝나면 그 다음은 서빙(Serving)이다. 이는 Frontier API가 블랙박스 내부에서 이미 하고 있는 일을 직접 구현하는 것과 같다. 강연자는 현재 널리 사용되는 오픈소스 서빙 도구들을 소개한다.
현재 오픈소스 LLM 서빙의 사실상 표준으로 자리 잡은 vLLM, 고성능 서빙 프레임워크인 SGLang, NVIDIA의 프로덕션급 서빙 솔루션인 Triton Inference Server(강연 내 STT 오인식으로 “Trident”로 표기되었으나 문맥상 Triton으로 교정), 그리고 Python과 Modal 등 서버리스 플랫폼을 조합한 커스텀 인퍼런스 워크플로우가 그것이다.
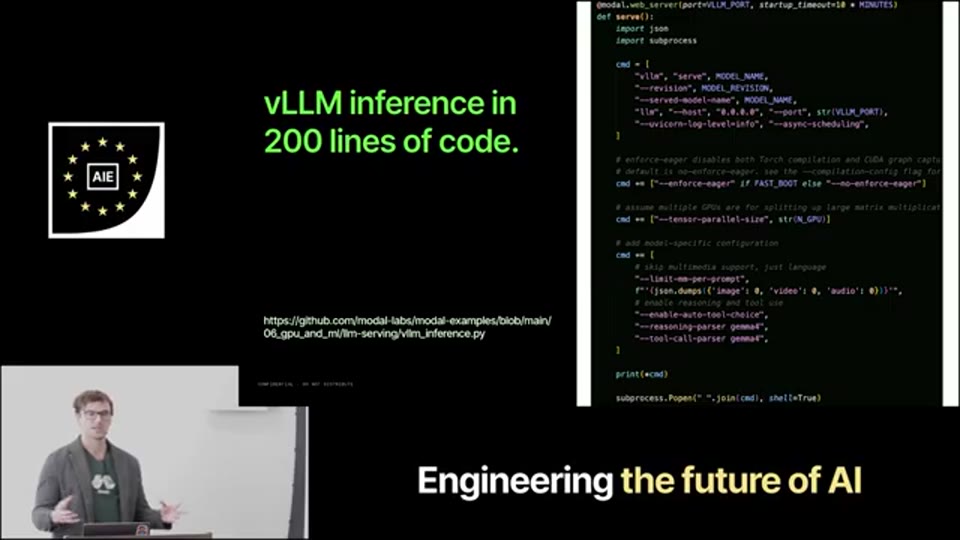
11:25 - vLLM, SGLang, Triton Inference Server 등 오픈소스 서빙 스택 소개 슬라이드
이 모든 서빙 인프라는 서버리스 플랫폼을 통해 인입 트래픽에 맞게 자동 스케일링(Auto-scaling)이 가능하다. 강연자의 핵심 주장은 Frontier API가 블랙박스로 처리하는 것들을 이제는 직접 구현하고, 원하는 방식으로 최적화하며, 비용을 직접 제어할 수 있다는 것이다.
마무리: 지금 준비하지 않으면 놓치는 것들
강연자의 결론은 도발적이지 않다. “지금 당장 모델을 학습시키라”는 촉구가 아니다. 그가 전달하고자 하는 것은 더 전략적인 시각이다. 파인튜닝은 “10년 후에나 고려할 일”이 아니라, 어쩌면 6개월이나 1년 후에 해야 할 일일 수 있다는 것이다. 그 순간이 왔을 때 준비되어 있느냐 아니냐의 차이를, 지금 이 시점에 만들어야 한다.
준비는 거창한 것이 아니다. 제품을 운영하면서 무엇이 잘 되고 무엇이 실패하는지 데이터를 꾸준히 수집하고, 평가 지표를 다듬어 나가는 것. 그것이 Frontier API라는 범용 도구에서 자신만의 특화 모델로 나아가는 출발점이 된다. 차별화된 제품을 만들고 있다면, 그 제품은 이미 도메인 특화의 길 위에 있다. 언제 그 선을 넘을 것인지는 각자가 결정해야 할 문제이지만, 선 자체는 이미 가까이 와 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | What Lies Beneath the API — Benjamin Cowen, Modal |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-06-03 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Under 5 minutes to a deployed LLM endpoint — Audry Hsu, RunPod
- Running LLMs locally - Practical LLM Performance on DGX Spark
- How We Built Zeta2 - Training an Edit Prediction Model in Production - Ben Kunkle, Zed
- Data Quality Is the Compute Multiplier - Ari Morcos, DatologyAI
- Let LLMs Wander - Engineering RL Environments — Stefano Fiorucci