Your Agent Can Now Train Models — Merve Noyan, Hugging Face
📺 원본 영상: Your Agent Can Now Train Models — Merve Noyan, Hugging Face 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-14 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드, 데모 UI 등)는 포함되지 않을 수 있으며, 일부 고유명사·모델명은 STT 오인식을 문맥 기반으로 교정하였습니다.
개요
이 강연은 Hugging Face의 오픈소스 팀 소속 Merve Noyan이 “손끝의 AI 엔지니어(Having an AI Engineer at Your Fingertips)“라는 부제 아래 발표한 세션이다. 강연자는 오픈소스 모델이 클로즈드 모델을 사실상 따라잡은 현재의 지형을 진단하는 것에서 시작해, Hugging Face Hub가 이 생태계의 핵심 인프라로 어떻게 기능하는지를 체계적으로 풀어낸다. 강연의 클라이맥스는 에이전트가 단순히 코드를 작성하는 수준을 넘어 모델 학습 자체를 오케스트레이션할 수 있게 된 현실을 직접 시연하는 부분이며, 이를 위한 구체적인 도구들인 MCP 서버, Skills, Traces, 로컬 에이전트 옵션들을 하나씩 소개한다.
오픈소스 AI의 새로운 지형: 클로즈드 모델과의 격차가 사라지다
오픈소스와 클로즈드 소스를 구분하는 기준은 생각보다 미묘하다. Merve는 먼저 이 개념을 정리하는 것에서 강연을 시작한다. “오픈 웨이트(Open Weight)” 모델은 가중치가 공개되어 있지만 비상업적 라이선스가 붙은 경우를 가리키며, 진정한 의미의 “오픈소스” 모델은 DeepSeek처럼 MIT 또는 Apache 2.0 같은 상업적으로 이용 가능한 라이선스를 가진 모델이다. 더 나아가 에이전트 하네스(harness)와 학습 코드까지 모두 공개된 모델군도 존재한다.
오픈소스의 실질적 가치는 단순히 “무료”에 있지 않다. 가중치에 접근할 수 있으면 모델을 압축(shrink)하거나 양자화(quantize)하거나 파인튜닝(fine-tune)하는 것이 가능해지고, 무엇보다 엣지(edge) 디바이스에 로컬 배포가 가능해지기 때문에 데이터가 외부로 전송되지 않는 완전한 프라이버시 보장이 실현된다. 강연자는 최근 증가하는 보안 침해 사례를 언급하며, 이 특성이 지금 시대에 더욱 중요해지고 있다고 강조한다. 또한 폐쇄 모델에서는 성능 저하가 사용자 모르게 일어날 수 있다는 점도 지적했다. 실제로 강연 직전에 특정 클로즈드 모델의 성능이 조용히 하락했다는 사실이 공개되어 논란이 됐는데, 오픈소스라면 가중치와 코드가 모두 공개되어 있으므로 이런 일이 사용자 몰래 발생할 수 없다.
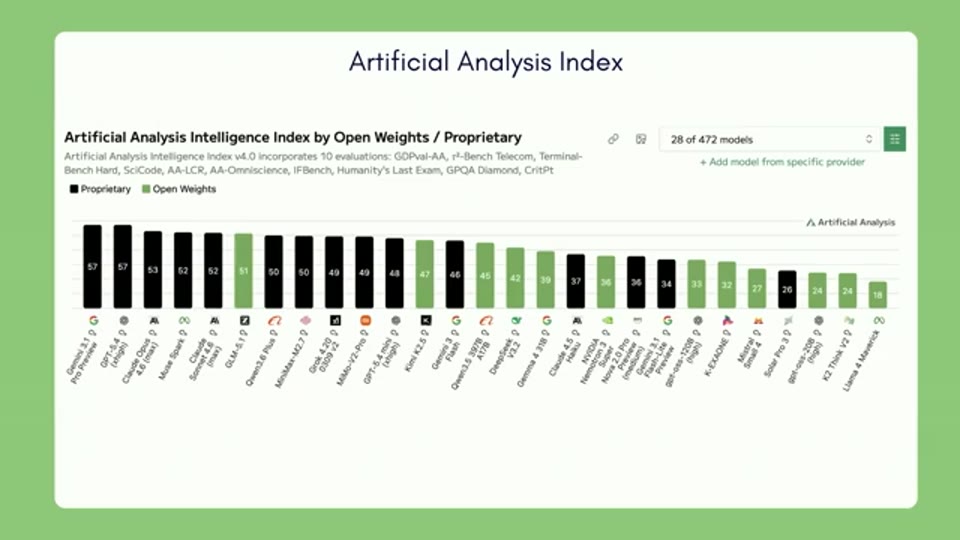
02:18 - Artificial Analysis 인텔리전스 인덱스 차트: 초록색(오픈 모델)과 검은색(클로즈드 모델)의 성능 격차가 거의 사라진 모습
강연자가 개인 코딩 환경에서 직접 사용하고 있다고 밝힌 GLM 5.1은 현재 이 인덱스에서 상위권을 차지하고 있으며, 오픈 모델들은 앞으로 출시될 모델들을 통해 클로즈드 모델과의 격차를 더욱 좁혀나갈 것이라는 것이 강연자의 전망이다.
Hugging Face Hub: 오픈 AI 생태계의 인프라 레이어
Hugging Face Hub는 모든 오픈소스 릴리스의 통로이자 인프라 레이어다. 강연 시점 기준으로 약 300만 개에 달하는 모델, 수십만 개의 데이터셋, 그리고 AI 앱 스토어 역할을 하는 “스페이스(Spaces)“가 Hub 위에 호스팅되고 있다. 그러나 강연자가 진짜 주목하는 것은 이 숫자 자체가 아니라, 이 생태계를 에이전트 워크플로우와 연결하는 최근의 신규 기능들이다.
모델을 선택하는 행위만 해도 이전에는 고된 작업이었다. 300만 개의 모델 중에서 자신의 유스케이스에 맞는 것을 고르는 것은 경험 없이는 쉽지 않았다. 이 문제를 해결하기 위해 Hugging Face는 벤치마크 데이터셋(Benchmark Datasets) 기능을 최근 출시했다. 데이터셋 탭에서 좌측 하단의 “benchmark” 버튼을 클릭하면, SWE-Bench Pro나 Humanity’s Last Exam과 같이 잘 알려진 벤치마크별로 오픈 모델들의 순위를 확인할 수 있다.
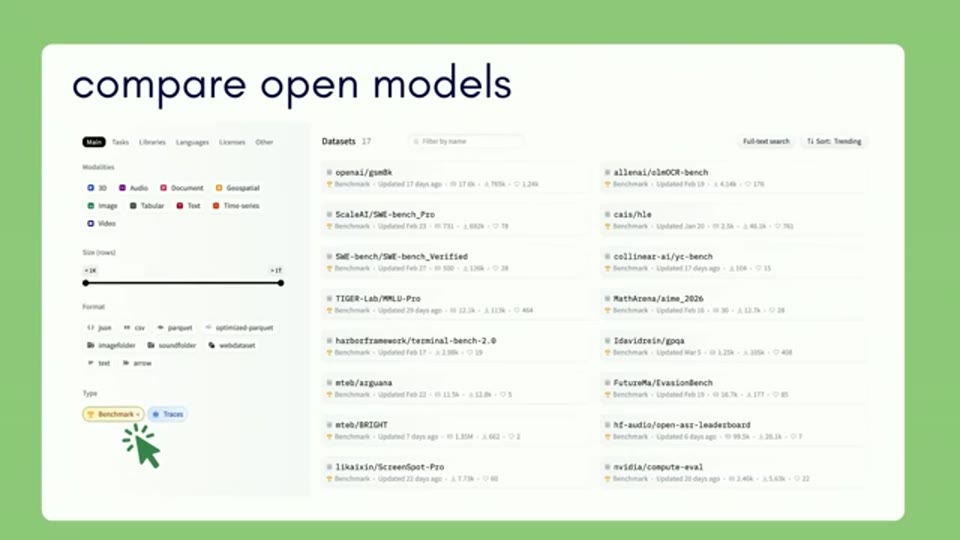
04:35 - Hugging Face Hub 벤치마크 데이터셋 UI: SWE-Bench Pro 등 주요 벤치마크별 오픈 모델 순위
모델을 고른 다음 단계, 즉 “이 모델이 실제로 얼마나 빠르고 저렴한가”를 확인하는 것도 Hub에서 가능하다. Inference Providers는 다양한 추론 제공업체—Groq, Cerebras, Novita 등—로의 라우팅을 자동으로 처리하는 서비스로, 각 제공업체의 가격과 속도를 직접 비교할 수 있으며 툴 사용(tool use) 지원 여부까지 컬럼으로 제공되어 에이전틱 유스케이스에 적합한 모델을 고르는 데에도 활용 가능하다.
에이전트 모델의 분류: Vision LM과 LLM의 수렴
Hub에서 에이전트 모델 필터를 적용하면 트렌딩 상위권의 모델들이 대거 등장한다. 강연자는 이 모델들을 크게 두 종류로 구분한다. 하나는 텍스트 전용 LLM이고, 다른 하나는 스크린샷을 통한 컴퓨터 사용 에이전트(Computer Use Agent)로도 기능할 수 있는 비전 언어 모델(VLM)이다. VLM은 화면의 어디를 클릭해야 하는지를 인식할 수 있어, UI 자동화 시나리오에서 특히 강력하다.
강연자가 최근 주목하고 있는 트렌드는 Labs들이 LLM을 처음 릴리스할 때부터 비전 능력을 탑재해 출시하는 경향이 뚜렷해지고 있다는 점이다. Gemma 4는 처음부터 옴니 모델로 공개되었고, 이 외에도 Qwen 2.5 계열의 VLM 및 Kimi K 2.5 역시 비전 기능을 기본으로 포함하고 있다. (STT 주의: 원문의 “Q1 3.5”는 Qwen 2.5 계열 모델을 지칭하는 것으로 추정되나, 정확한 버전은 원본 영상 확인 권장) 강연자는 앞으로 거의 모든 주요 모델이 출시 첫날부터 비전 기능을 포함하는 방향으로 수렴할 것이라 예측한다.
이 모델들을 실제로 구동하는 것도 이전보다 훨씬 간단해졌다. vLLM, MLX, Llama.cpp, Llama Server 중 원하는 것을 골라 몇 줄의 코드만으로 서빙을 시작할 수 있으며, 과거에 비해 진입 마찰이 크게 줄었다는 것이 강연자의 평가다.
로컬 코딩 에이전트 설정: 오픈소스 선택지들
로컬 코딩 에이전트를 구성하는 데에는 다양한 선택지가 존재한다. 강연자가 개인적으로 선호하는 도구 중 하나는 설정이 매우 간단하다는 장점을 가진 “Py”라는 툴이며 (STT 오인식 가능성 있음, 원본 영상 확인 권장), Inference Providers를 통해 원격으로도 사용할 수 있고 로컬 서빙 용도로는 Llama.cpp와 조합해 사용할 수 있다. 또 하나 주목할 만한 옵션은 Llama.cpp에 바이너리로 내장된 Llama Agent로, Hugging Face Hub의 모델 ID만 지정하면 별도의 설정 없이 바로 로컬 에이전트를 구동할 수 있다.
이와 별개로, 강연자가 현재 가장 열정적으로 추천하는 것은 Hermes 에이전트다. 이 에이전트는 메모리 관리 측면에서 다른 오픈소스 에이전트들보다 한 단계 앞서 있다는 것이 강연자의 평가다. 설정 마법사(setup wizard)가 전 과정을 안내해 주어, API 키만 입력하면 Slack이나 WhatsApp 같은 메신저와 통합하는 것도 쉽게 가능하다. 강연자는 GLM 5.1을 Hermes 에이전트와 함께 사용할 것을 강력히 권장하는데, 그 이유로 자신이 Slack 통합 과정에서 겪은 실패를 GLM 5.1이 Hermes 에이전트 내에서 자율적으로 해결해낸 실제 경험을 들었다. 강연자는 앞으로 Gemma 4, 그리고 소문으로 전해지는 Minimax 모델과의 조합도 시도해볼 계획임을 밝혔다.
Traces: 에이전트 데이터를 위한 새로운 저장소 유형
Hugging Face Hub는 최근 Traces라는 새로운 데이터셋 저장소 유형을 출시했다. 이는 Claude Code, Codex, Py 같은 코딩 에이전트들이 생성하는 실행 트레이스(trace)를 저장하고 탐색하며 나아가 모델 학습에 활용하기 위한 전용 저장소다.
Traces가 기존 데이터셋 저장소와 다른 점은 시각화 경험에 있다. 데이터셋 뷰어에서 Traces 컬럼을 클릭하면 에이전트의 행동 흐름이 구조적으로 파싱되어 표시되어, 에이전트가 어떤 판단 과정을 거쳐 작업을 수행했는지 쉽게 탐색할 수 있다. 이 데이터를 추후 모델 파인튜닝에 사용할 수도 있다는 점이 강연자에게는 특히 인상적인 부분이다. 에이전트 트레이스를 업로드하는 방법도 간단하다. 강연자에 따르면, 해당 에이전트가 세션 데이터를 저장하는 경로에서 파일을 Hub에 업로드하는 것만으로 충분하며, 추가적인 설정은 필요하지 않다. 조만간 Hermes 에이전트도 Traces와의 통합이 이루어질 예정이라고 한다.
GGUF와 로컬 서빙: 누구나 쉽게 대형 모델을 구동하는 방법
로컬에서 모델을 서빙하고 싶은 사람들을 위한 에코시스템도 Hub에 잘 통합되어 있다. Hub의 “Other” 탭 하위에 있는 앱 섹션에는 LM Studio, Jan, Llama.cpp 같이 로컬 서빙을 위한 애플리케이션들이 모여 있으며, 이 앱들로 필터링하면 해당 앱이 지원하는 모델 목록을 곧바로 확인할 수 있다.
모델 저장소 페이지에서는 GGUF 섹션이 좌우 사이드바에 제공된다. GGUF는 Llama.cpp를 비롯해 LM Studio 등 다양한 로컬 실행 도구에서 지원되는 파일 포맷으로, 양자화(quantization)를 통해 모델의 메모리 요구량을 획기적으로 낮출 수 있다. 예를 들어 Gemma 4의 대형 버전도 4비트로 양자화하면 24GB VRAM의 L4 GPU에서 구동 가능하다. 동일한 정보가 MLX 저장소에도 제공된다. 모델 저장소 페이지 우측 상단의 “Use This Model” 버튼을 클릭하면 지원 앱별 실행 명령어가 바로 표시되어, 몇 줄의 명령만으로 모델 다운로드부터 서버 구동까지 완료할 수 있다.
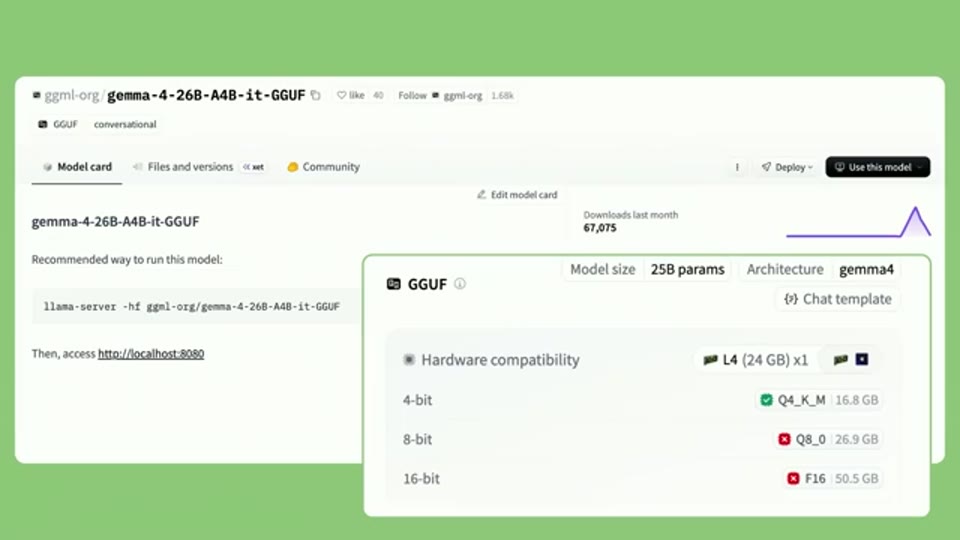
11:20 - GGUF 섹션이 포함된 모델 저장소 페이지: Gemma 4 4비트 양자화 시 L4 GPU(24GB)에서 구동 가능한 하드웨어 호환성 정보
Hugging Face Skills로 에이전트를 슈퍼차징하다
강연의 핵심 주제이자 가장 인상적인 부분은 Hugging Face Skills다. Skills는 코딩 에이전트(Claude Code, Gemini 등)에 Hugging Face Hub의 기능을 도구로 제공하는 플러그인 개념이다. hf skills를 검색하면 설치 명령어를 바로 찾을 수 있으며, 설치 후에는 에이전트가 Hub와 직접 상호작용하는 것이 가능해진다.
현재 제공되는 주요 스킬은 다음과 같다.
- Hugging Face CLI Skill: Hub 저장소 관리, 학습 잡 실행, 데모 런칭 등 CLI로 할 수 있는 거의 모든 작업을 에이전트가 수행할 수 있게 한다.
- LLM Trainer Skill: LLM뿐 아니라 Vision Language Model까지 포함한 다양한 모델의 파인튜닝을 에이전트가 직접 오케스트레이션한다. 에이전트는 주어진 배치 크기와 모델 아키텍처를 기반으로 필요한 VRAM 양을 자동 계산하고, 적절한 인스턴스를 추천하며, 검증 데이터 비율 같은 몇 가지 질문만으로 학습 잡을 원격 인프라 또는 로컬에서 킥오프한다.
- Gradio Skill: 오픈 모델을 활용한 데모 앱을 에이전트가 직접 빌드하고 배포하도록 돕는다.
- Hugging Face Dataset Skill: 데이터셋 뷰어 API를 통해 Hub의 데이터셋을 탐색하는 기능을 에이전트에 부여한다.
강연자는 Claude Code에게 “Qwen2-VL을 LLaVA Instruct Mix 데이터셋으로 파인튜닝해줘”라고 요청한 실제 시연을 소개했다. (STT 교정: “QN2VL” → Qwen2-VL, “lava instruct mix” → LLaVA Instruct Mix) 에이전트는 어떤 인스턴스를 사용할지 확인하고, 배치 사이즈 기준의 VRAM 요구량을 계산한 뒤, 검증 데이터 분할 비율을 묻고 나서 잡을 자동으로 실행했다. 학습이 끝나면 결과 모델이 Hub에 업로드되어 있다. 강연자는 모델 학습 커리어를 6년 전부터 시작한 사람으로서, 이 경험이 아직도 SF처럼 느껴진다고 말했다.
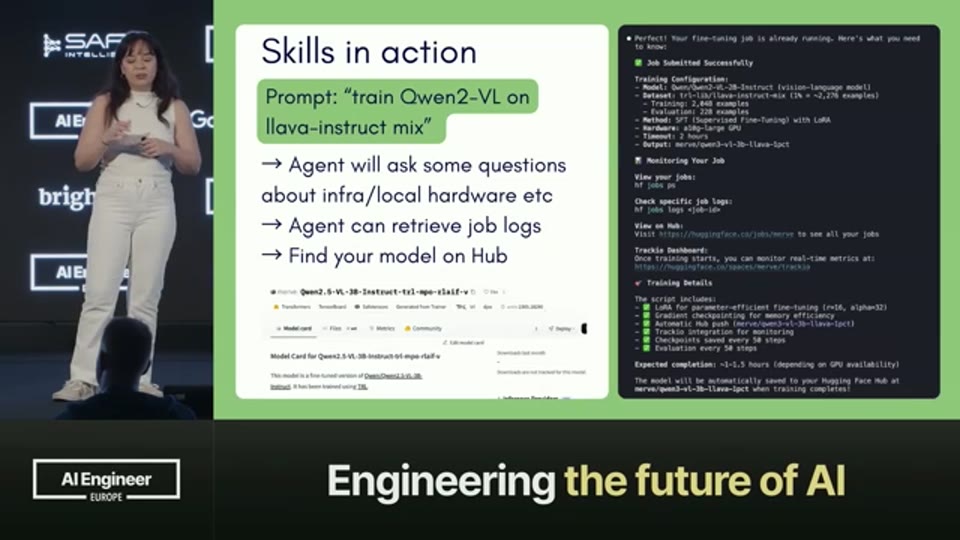
13:57 - Claude Code가 Qwen2-VL 파인튜닝 잡을 에이전트를 통해 설정·실행하는 시연 화면
이 기능은 LLM과 VLM에 국한되지 않는다. 최근에는 객체 탐지(object detection) 모델이나 세그멘테이션(segmentation) 모델 학습을 위한 스킬도 추가되었으며, 다양한 바운딩 박스 포맷 처리까지 에이전트가 자동으로 핸들링한다.
MCP 서버: Hub를 에이전트의 도구로
MCP(Model Context Protocol) 서버를 통해 Hugging Face Hub 전체를 LLM의 도구로 연결할 수 있다. 현재 MCP를 통해 접근 가능한 기능은 모델 검색, 데이터셋 검색, 스페이스(Spaces) 시맨틱 검색, 그리고 Jobs이다. Jobs는 완료 혹은 실패 시 자동으로 종료되는 일회성 컴퓨팅 잡으로, 실행 시간만큼만 비용이 청구된다.
특히 스페이스 기능은 MCP와 결합했을 때 강력하다. 강연자는 “yarn으로 만든 바클라바(baklava) 이미지 생성”을 에이전트에 요청하는 시연을 보여줬는데, 에이전트는 이를 처리하기 위해 원격으로 호스팅된 이미지 생성 스페이스를 자동으로 호출하고 결과를 반환했다. MCP 설정에서 “dynamic spaces” 옵션을 활성화하면 Hub에 있는 더 넓은 범위의 스페이스를 에이전트가 동적으로 활용할 수 있다.
15:47 - MCP를 통한 이미지 생성 데모: 에이전트가 Hub 스페이스를 호출해 바클라바 이미지를 생성한 결과
실전 사례: 30,000편의 논문을 에이전트로 처리하다
강연 말미에 강연자는 동료 Nils가 구현한 흥미로운 사례를 소개했다. Hugging Face Hub에는 AI 관련 논문 페이퍼 섹션이 존재하는데, 모든 논문이 인덱싱 가능한 Markdown 형식으로 제공되지는 않았다. 이 문제를 해결하기 위해 팀은 30,000편의 논문을 오픈 OCR 모델과 Jobs를 활용해 프롬프트만으로 처리하는 파이프라인을 구축했다.
이 파이프라인의 단계는 다음과 같이 진행된다. 먼저 OCR 벤치마크 데이터셋을 통해 성능 대비 비용이 좋은 모델을 선택하고 (강연자는 “almost here bench”라는 표현을 썼으나 STT 오인식 가능성이 높음—정확한 벤치마크명은 원본 영상 참조), 에이전트가 처리 스크립트를 직접 작성하도록 요청한다. 그런 다음 에이전트는 인스턴스 비용과 예상 실행 시간에 대한 “냅킨 수학(napkin math)“을 수행하고, Hugging Face 인프라에서 잡을 킥오프한다. 처리된 결과물은 Hugging Face가 새로 출시한 스토리지 인프라 제품인 Buckets—S3 버킷과 유사하지만 더 저렴하고 빠른 서비스—에 저장된다.
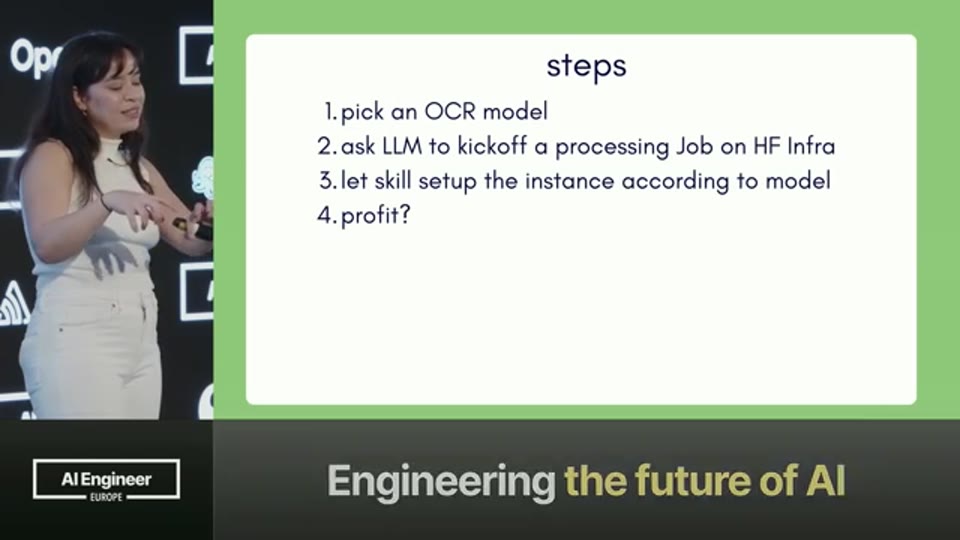
17:14 - 30,000편 논문 OCR 처리 파이프라인 개요: 모델 선택 → 스크립트 작성 → 잡 킥오프의 전체 흐름
강연자는 이 사례를 통해 강조하고 싶었던 핵심 메시지를 분명히 했다. 과거에는 이런 대규모 배치 처리를 위해 개발자가 인프라 설정, 비용 추산, 스크립트 작성, 잡 모니터링을 모두 직접 처리해야 했다. 지금은 에이전트가 그 전 과정을 처리한다. 해당 플로우는 조만간 Traces 통합도 지원할 예정이다.
마무리: 에이전트는 이제 모델을 학습시킨다
이 강연의 메시지는 간결하지만 그 함의는 크다. 오픈소스 AI 생태계는 이미 클로즈드 모델과 경쟁할 수 있는 성능에 도달했고, Hugging Face Hub는 이 생태계를 에이전트 워크플로우에 연결하는 인프라 레이어로 성숙했다. 모델을 선택하고, 비교하고, 로컬에서 서빙하고, 에이전트에 도구로 연결하고, 심지어 모델을 학습시키는 일까지—이 모든 것이 이제 에이전트에게 몇 문장의 자연어 명령으로 위임될 수 있다.
강연자가 “손끝의 AI 엔지니어”라는 표현을 쓴 이유가 여기 있다. 인프라 전문 지식 없이도 에이전트를 통해 ML 엔지니어링 작업을 실행할 수 있는 시대가 열린 것이며, 이 경향은 Skills와 MCP 생태계가 확장됨에 따라 더욱 가속화될 것이다. 강연자 본인도 이 기술의 완성도에 여전히 놀라움을 느끼고 있다고 솔직하게 고백했는데, 그것이 오히려 이 분야의 발전 속도를 실감하게 해주는 장면이었다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Your Agent Can Now Train Models — Merve Noyan, Hugging Face |
| 채널 | AI Engineer |
| 발표자 | Merve Noyan (Hugging Face, Open Source Team) |
| 리포트 작성 | 2026-05-14 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.