의 경쟁력을 결정하게 된다는 것이 교수의 주장이다.
GPU 성능을 높이는 방법은 GPU끼리 광통신으로 연결해 병렬 처리 능력을 확장하는 것이 사실상 유일한 경로다. 반면 메모리는 용량, 밴드위스, 다층 버스 등 여러 변수를 개선할 수 있는 여지가 더 많다. NVIDIA가 Blackwell → Rubin → Feynman으로 새 GPU를 출시할 때마다 “성능이 두 배 향상”되었다고 발표하는데, 교수는 이 성능 향상의 실질적인 원천이 GPU 자체보다 GPU에 탑재되는 HBM의 용량 증가와 밴드위스 향상에서 온다고 분석한다. 이는 AMD의 Lisa Su나 다른 AI 칩 경쟁자들에게도 동일하게 적용되며, GPU 알고리즘의 차이보다 메모리 구성의 차이가 경쟁력을 결정하는 시대로 진입했다는 의미다.
광통신과 ICMS: 새로운 메모리 아키텍처의 등장
메모리 수요가 폭발적으로 증가하는 상황에서 GPU 바로 옆에 HBM을 쌓는 전통적인 방식만으로는 한계가 있다. 이를 해결하기 위한 새로운 접근법 중 하나가 ICMS(Inference Context Memory Storage) 아키텍처다. 이름에서 볼 수 있듯 추론(Inference), 컨텍스트(Context), 메모리(Memory), 스토리지(Storage)를 통합한 개념으로, NAND Flash 기반의 대용량 스토리지를 광통신으로 GPU에 연결하는 방식이다. GPU와 물리적으로 멀리 떨어진 NAND Flash 메모리를 마치 비행기를 타고 이동하듯 빠르게 접근할 수 있다는 논리다.
11:37 - 단기 메모리(HBM/HBF)와 장기 메모리(NAND Flash)의 역할 차이 도식화
이 방식의 핵심 장점은 HBM보다 훨씬 저렴한 NAND Flash로 대용량 메모리를 확보할 수 있다는 것이다. SanDisk, Micron, Samsung 등 NAND Flash 전문 제조사들이 이 구조에서 새로운 수혜자로 떠오를 수 있는 이유도 여기에 있다. 현재 InfiniBand와 같은 기술을 통해 GPU와 GPU 사이, 혹은 모듈과 모듈 사이를 연결하는 데에는 이미 광통신이 사용되고 있다.
그러나 교수는 GPU에 직접 인접한 메모리 계층에서 광통신을 사용하는 방식에 현실적인 한계가 있다고 지적한다. 전기 신호를 광신호로 변환하고 다시 수신 측에서 광신호를 전기 신호로 변환하는 과정에서 상당한 전력 소모가 발생한다. 또한 광통신으로 연결 가능한 채널 수가 전기 기반의 PCB 배선에 비해 훨씬 적고(16~8개 수준), 물리적으로 3차원 공간을 차지하는 복잡한 광섬유 케이블링이 필요해 시스템 설계를 크게 복잡하게 만든다. 교수의 관점에서는 이러한 이유로 GPU 바로 옆에 HBM/HBF를 물리적으로 붙이는 방식이 여전히 근본적인 해결책이며, 광통신 기반의 원격 NAND Flash 연결은 HBM만으로 용량이 부족할 때 선택하는 차선책에 가깝다. 한편, 교수가 제목에서 언급한 “구글은 틀렸습니다”는 이 맥락과 연결된다. 일부 거대 AI 기업들이 메모리 수요의 규모를 과소평가하거나, 광통신 기반 원격 스토리지로 이를 대체하려 한다는 접근 방식에 대해 교수는 근본적인 물리적 한계 때문에 HBM·HBF를 GPU에 최대한 가깝게 붙이는 방식이 대체 불가능하다고 주장하는 것이다.
반도체 산업의 지각 변동: 메모리 게임으로의 전환
교수의 분석이 맞다면 반도체 산업의 게임 규칙이 근본적으로 바뀌게 된다. 지금까지 AI 산업의 가치 사슬이 GPU(NVIDIA) → 메모리(SK Hynix, Samsung, Micron) 순이었다면, Agentic AI 시대에는 이 순서가 역전되거나 최소한 동등해질 수 있다. 교수는 더 나아가 “메모리 공장이 운동장 하나라면 메모리 창고는 운동장 100개”가 될 수도 있다고 표현하며, 현재 생산 체계로는 미래의 AI 메모리 수요를 감당하기 택도 없다고 진단한다.
Elon Musk가 “Tera Fab”이라는 반도체 패키징 공장을 텍사스에 짓겠다고 나선 것도 이 맥락에서 이해할 수 있다. 외부 공급업체인 Samsung, SK Hynix, Micron에 메모리를 계속 요청하기보다 직접 생산 체계를 구축하겠다는 의지다. 교수는 Musk의 이 결정이 SpaceX를 시작할 때와 유사하게 업계의 회의적인 시선을 받고 있지만, 로켓을 집게로 잡아채는 장면을 실제로 해낸 전례를 보면 가능성을 완전히 배제하기 어렵다고 말한다.
AI 산업 전체의 흐름을 보면, 게임의 핵심 자원이 GPU 경쟁 → 전력(Electricity) 경쟁 → 메모리 경쟁으로 이동하고 있다. 100년 만기 채권을 발행하며 자금을 조달하는 AI 기업들의 행태는 이 게임이 단기 승부가 아님을 보여준다. 누가 먼저 충분한 메모리 인프라를 구축하느냐가 향후 AI 경쟁의 핵심이 될 것이며, 이는 쿠팡이 새벽 배송 인프라를 선점해 시장을 장악한 것처럼 선점 효과가 막대한 승자독식 게임이 될 수 있다. 현재 Samsung, SK Hynix, Micron이 생산하는 메모리 물량은 수요 대비 대폭 부족하며, 새로운 공장을 건설해도 완공과 양산까지 약 3년이 필요하고 HBM과 같은 고급 패키징 기술을 숙달하는 데는 오랜 기술 축적이 필요하다는 점에서, 이 공급 부족 상황은 상당 기간 지속될 가능성이 높다.
마무리: 폰 노이만 구조와 메모리의 불가피성
이 모든 논의의 밑바닥에는 Von Neumann 구조(폰 노이만 구조)라는 컴퓨터의 근본 설계 원리가 있다. 현재의 모든 컴퓨터와 AI 칩은 연산 장치와 메모리가 분리되어 있고, 연산 장치가 메모리에서 데이터를 가져와 처리하는 구조로 되어 있다. 이 구조에서는 처리해야 할 데이터가 늘어나면 그만큼 더 많은 메모리가 필요하고, 더 빠른 처리를 위해서는 메모리와 연산 장치 사이의 데이터 전송 속도가 빨라야 한다는 물리적 제약이 존재한다. 양자 컴퓨팅이나 뇌-컴퓨터 인터페이스 같은 근본적으로 다른 아키텍처가 등장하지 않는 한, 이 제약은 피할 수 없다.
교수가 제시한 세 가지 수학 공식은 복잡한 공식이 아니다. 중학생도 이해할 수 있는 곱하기의 연속이다. 그런데 바로 그 단순함이 이 공식의 무서움이기도 하다.
35:45 - 공식 1: KV Cache 메모리 용량 = Sequence Length × Batch × Precision × Num Heads × 2 × Num Layers × Head Dimension
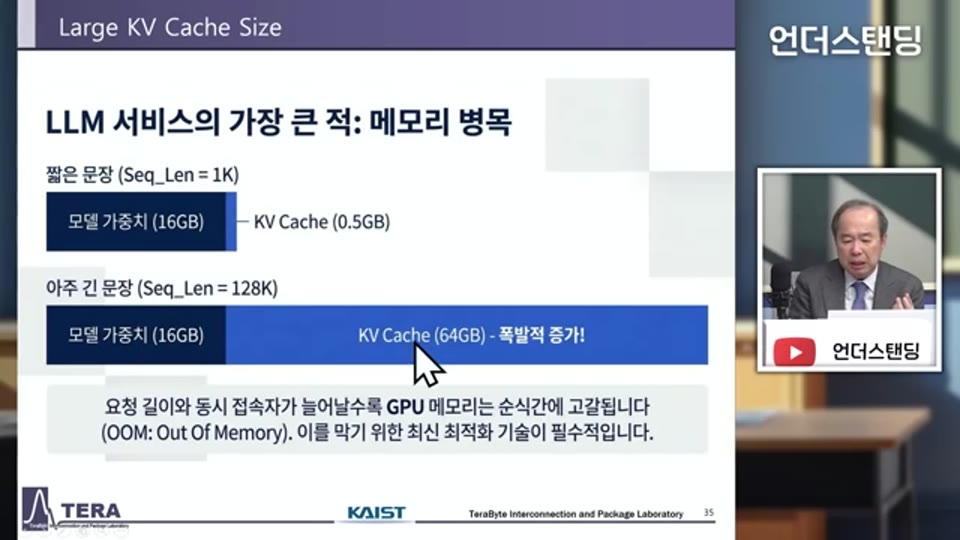
46:06 - 수치 대입 시 1인 사용 약 64GB, 100명 동시 사용 시 6.4TB 산출 과정
Sequence Length, Batch Size, Precision 같은 변수들이 각각 10배씩 증가하면 메모리 수요는 1,000배가 된다. AI 에이전트 서비스가 보편화되고, 개인화 수준이 높아지고, 처리 데이터에 동영상과 이미지가 포함되는 것이 당연해지는 세상이 되면, 이 공식의 변수들은 하나씩 계속해서 올라갈 수밖에 없다.
49:09 - 컨텍스트 입력 처리(Prefill)와 토큰 출력(Decode) 단계별 병목 요인 비교
결국 교수의 메시지는 단순하고 명확하다. AI의 성능 경쟁은 메모리 게임으로 전환되었으며, 메모리의 용량과 밴드위스가 AI 서비스의 질과 속도를 결정하는 시대가 왔다.
57:41 - Time per Output Token = max(Computing Load / GPU FLOPS, KV Cache Size / Memory Bandwidth): 메모리 밴드위스가 도미넌트 항임을 설명
무료 사용자는 메모리가 빨리 지워져 맞춤형 서비스를 받지 못하고, 돈을 더 내는 사용자에게는 비싼 메모리가 항상 할당되어 더 빠르고 더 정확한 응답이 제공되는 구조가 될 것이다. 미래에는 집의 메모리 용량이나 AI 구독 서비스의 토큰 한도가 경제적 지위를 나타내는 지표가 될 수도 있다는 교수의 상상은, 단순한 농담이 아니라 이 공식들이 가리키는 필연적 미래를 유머러스하게 표현한 것일지 모른다. 학생들이 학교에 메모리를 사오고, AI 에이전트 가입비가 하숙비·식비처럼 매달 나가는 세상, 그 세상을 만드는 수학이 바로 이 단순한 곱하기 공식 세 개다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | [진짜 수학,AI 4편] 구글은 틀렸습니다, 메모리 수만배 필요합니다 |
| 채널 | 언더스탠딩 : 세상의 모든 지식 |
| 강연자 | 김정호 교수 (KAIST 전자및전기공학부) |
| 리포트 작성 | 2026-04-05 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.