Benchmarking Coding Agents on New vs Legacy Codebases — Denys Linkov, Wisedocs
📺 원본 영상: Benchmarking Coding Agents on New vs Legacy Codebases — Denys Linkov, Wisedocs
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-08-09
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료, 차트, 코드, 슬라이드 등은 포함되지 않을 수 있습니다.
개요
이 강연은 Wisedocs가 복잡한 의료 청구 PDF를 처리하는 AI 파이프라인을 리팩터링하면서 얻은 경험을 바탕으로, 코딩 에이전트가 새 코드베이스와 레거시 코드베이스에서 실제로 얼마나 유용한지를 다룬다. 발표자인 Denys Linkov는 단순히 “AI가 코드를 더 빨리 쓴다”는 관찰에 머물지 않고, 기술 부채(Technical Debt), 모노레포 전환, 모델 성능 향상, 검증 체계, 개발자 생산성이라는 여러 층위를 함께 분석한다.
강연의 중심 질문은 명확하다. AI 코딩 도구와 에이전트가 빠르게 발전하고 있는 상황에서, 오래된 코드베이스를 지금 리팩터링하는 것이 맞았는가, 아니면 더 강력한 모델이 나올 때까지 기다렸어야 했는가이다. 발표자는 Wisedocs의 실제 사례를 통해 “모델은 계속 좋아지지만, 비즈니스와 개발 조직이 감당하는 복잡도는 기다려주지 않는다”는 현실적인 결론에 도달한다.
기술 부채는 AI 시대에도 사라지지 않는다
강연은 Wisedocs가 2025년에 겪은 확장 문제에서 출발한다. 회사는 고객을 빠르게 늘리고 있었지만, 기존 AI 파이프라인은 고객 수요를 따라가기에는 너무 느렸고, 업데이트하기에는 지나치게 복잡했으며, 10개가 넘는 레거시 저장소로 흩어져 있어 개발자들이 손대기를 꺼리는 상태였다. 이 문제는 단순한 코드 정리의 문제가 아니라, 고객 증가와 처리량 부족이 직접 충돌하는 비즈니스 문제였다.
Wisedocs의 제품 맥락도 중요하다. 이 회사는 10,000페이지가 넘는 복잡한 의료 청구 PDF를 처리하며, 일부 파일은 비디오 파일보다 클 정도로 크다고 설명한다. 이처럼 대용량 문서와 여러 ML 모델이 결합된 파이프라인에서는 성능, 확장성, 운영 안정성, 모델 서빙, 오케스트레이션이 서로 얽혀 있기 때문에, 특정 부분만 고쳐서 전체 문제가 해결되기 어렵다. 발표자가 리팩터링을 단순한 개발자 편의가 아니라 운영 구조를 다시 설계하는 일로 다루는 이유가 여기에 있다.
기술 부채에 대한 발표자의 관점은 금융 부채와 유사하다. 기술 부채는 당장의 기능 출시나 고객 확보라는 ROI를 만들기 위해 의도적으로 감수될 수 있지만, 그 복잡도가 일정 수준을 넘어서면 처음에 얻은 ROI를 빠르게 잠식한다. 특히 AI 엔지니어링에서는 실험 속도와 제품 요구사항 변화가 빠르기 때문에, 부채가 누적된 파이프라인은 새 기능을 붙이는 속도뿐 아니라 검증 가능성과 신뢰성까지 떨어뜨린다.
더 빨라진 개발 속도와 낮아진 제품 품질 사이의 긴장
발표자는 Anthropic이 공개한 Spotify와 Stripe 사례를 언급하며, AI 코딩 도구가 코드 작성과 리팩터링 속도를 크게 끌어올리고 있다는 점을 인정한다. 실제로 많은 팀이 이전보다 훨씬 빠르게 변경사항을 만들고 배포할 수 있게 되었고, 코딩 에이전트는 단순한 자동완성을 넘어 점점 더 긴 작업 단위를 수행하는 방향으로 발전하고 있다. 그러나 발표자는 이 속도 향상이 곧 제품 품질 향상으로 이어진 것은 아니라고 지적한다.
그는 지난 20년 동안 제품이 전반적으로 좋아졌는지 청중에게 질문한 뒤, 최근 개발 생애주기가 빨라지는 과정에서 잃어버린 것이 있다고 말한다. 고객 중심의 제품 품질, 코드 유지보수성, 신뢰성이 반드시 함께 개선된 것은 아니라는 것이다. 화면에는 두 주요 기업의 업타임 사례가 제시된 것으로 보인다. 발표자는 “three nines 또는 four nines reliability”, 즉 99.9%나 99.99% 수준의 신뢰성에도 미치지 못하는 사례를 언급하며, 빠른 출시와 높은 신뢰성이 자동으로 같이 오지 않는다는 점을 강조한다.
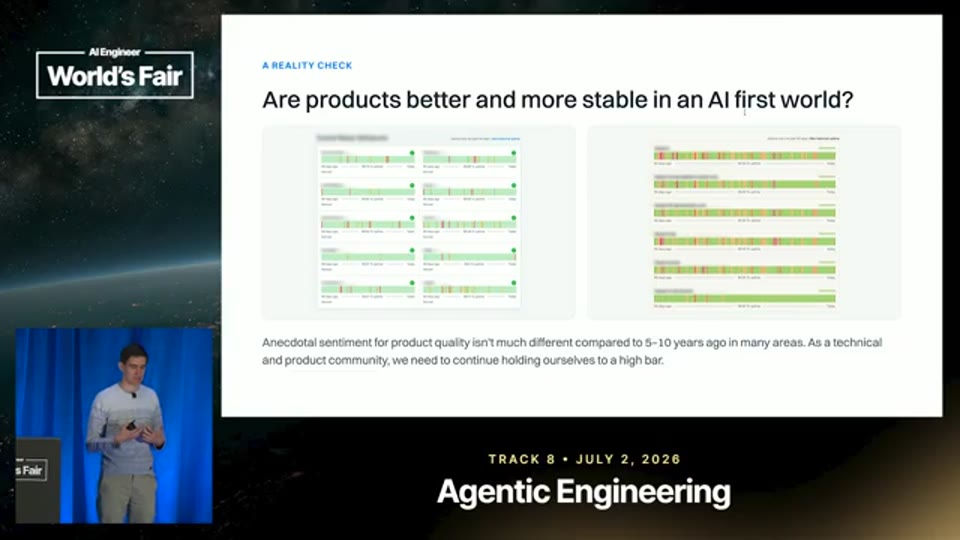
03:16 - 제품 출시 속도와 신뢰성 저하를 비교하며 업타임 또는 reliability 지표를 설명하는 구간
이 대목은 AI 코딩 시대의 중요한 역설을 보여준다. 코드 생산량과 커밋 속도가 증가하면 조직은 표면적으로 더 많은 일을 하는 것처럼 보이지만, 그 코드가 실제로 이해 가능하고 운영 가능한지는 별개의 문제다. 발표자는 이 차이를 분명히 구분하며, AI를 이용한 개발 속도 향상이 품질 관리, 검증, 아키텍처 판단을 대체하지 못한다고 본다.
Wisedocs의 리팩터링 접근법과 오케스트레이터 평가
Wisedocs는 본격적인 코드 구현을 4월에 시작했고, 그 전에는 리팩터링을 위한 사전 검토를 진행했다. 발표자는 전체 리팩터링 과정에서 다섯 가지 주요 작업을 수행했다고 설명하지만, STT에는 각 작업이 모두 상세히 분리되어 나오지는 않는다. 그중 핵심적으로 언급된 것은 AI 파이프라인 오케스트레이터 평가와 모델 서빙 관련 검토, 기존 레거시 코드의 기능 재현, 모노레포 기반 재구성, 그리고 이후의 생산성 측정이다.
오케스트레이터 평가는 약 두 달 동안 진행되었고, 팀은 다섯 개의 오픈소스 프로젝트를 검토했다. 당시에는 Google과 OpenAI의 Deep Research류 기능이 본격적으로 등장하기 전이어서, 지금처럼 웹 검색 기반으로 긴 분석 보고서를 자동 생성하고 비교하는 방식은 사용할 수 없었다. 팀은 세 명이 직접 요구사항을 수집하고, 17개 기준으로 후보를 평가했으며, Confluence 문서에 결과를 정리하고 Proof of Concept(POC)을 만들어 검증했다.
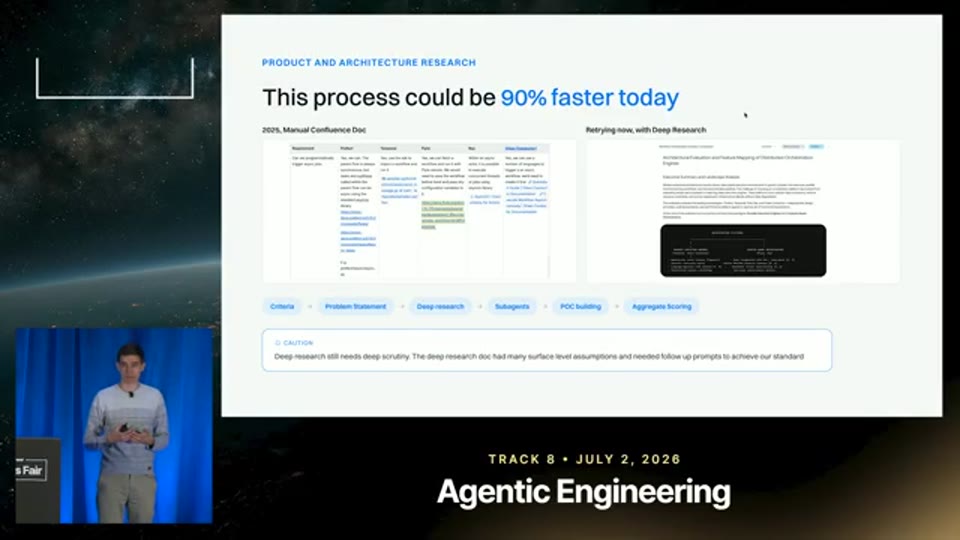
04:21 - 오케스트레이터 평가 기준과 기존 Confluence 기반 분석 과정을 설명하는 구간
발표자는 지금 같은 도구 환경이라면 이 작업을 약 90% 더 빠르게 할 수 있을 것이라고 말한다. 현대적인 에이전트 워크플로에서는 Deep Research로 후보를 넓게 조사하고, 문제 정의와 요구사항에 맞추어 결과를 대조한 뒤, 각 기준과 제품별로 서브에이전트를 만들어 더 세밀한 검토를 수행할 수 있기 때문이다. 그러나 그는 긴 AI 리서치 보고서가 그럴듯해 보인다고 해서 실제 제품에 해당 기능이 존재한다고 믿어서는 안 된다고 경고한다. “AI psychosis”라는 표현을 사용하며, AI가 만들어낸 설득력 있는 보고서가 현실 검증을 대체할 때 프로젝트가 오히려 뒤로 밀릴 수 있다고 지적한다.
코딩 에이전트 벤치마크: o3에서 Sonnet, Opus까지
리팩터링 초기 단계에서 발표자는 Temporal을 활용해 기존 레거시 코드베이스의 동작을 재현할 수 있는 activity와 workflow 코드를 실험했다. 이후 이 작업을 당시의 o3 모델에 맡겨 구현을 시도했는데, 결과는 흥미로웠다. 모델은 인간보다 훨씬 빠르게 작업을 진행했지만, Cursor 안에서 3시간 동안 여러 번 주고받으며 수정해야 했고, 그 과정에서 10개의 주요 실수를 만들었다고 설명한다.
이 사례는 당시 코딩 에이전트가 이미 생산성을 높여주고 있었지만, 아직 완전히 자율적인 개발자로 보기에는 부족했음을 보여준다. 사용자는 모델의 출력에 계속 개입해야 했고, 잘못된 코드를 직접 수정하거나 삭제하며 방향을 잡아줘야 했다. 즉, 모델은 구현 속도를 높이는 도구였지만, 문제 이해와 검증 책임은 여전히 인간에게 강하게 남아 있었다.
이후 발표자는 같은 벤치마크를 더 현대적인 모델로 다시 실행했다. 발표자의 설명에 따르면 Sonnet 계열 모델은 한 번의 추가 반복만으로 작업을 해결했고, Opus 계열 모델은 사실상 one-shot으로 문제를 해결했다. 또한 최신 harness에서는 서브에이전트, plan call, shell command, 검증 단계가 더 자연스럽게 사용되면서, 모델 실행 비용은 다소 높아졌지만 인간의 수동 개입은 크게 줄었다.
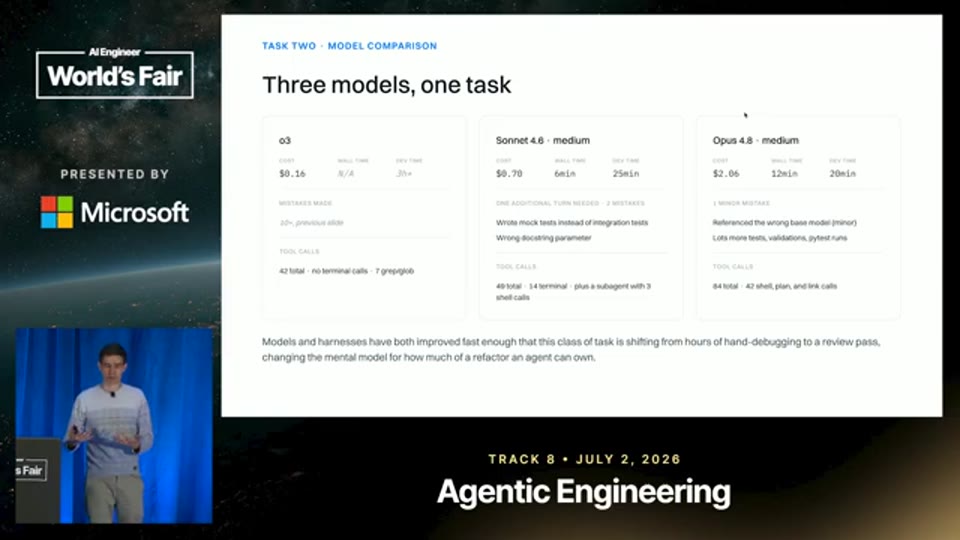
05:52 - o3, Sonnet, Opus 계열 모델의 리팩터링 벤치마크 결과와 도구 사용 차이를 설명하는 구간
발표자가 도출한 실무적 결론은 명확하다. 같은 리팩터링 작업을 지금 다시 한다면 약 5분의 1 시간으로 수행할 수 있을 정도로 모델과 도구 체계가 발전했다. 그러나 이 말은 “이제 모델에게 모든 것을 맡겨도 된다”는 뜻이 아니라, 더 나은 명세와 검증 구조를 갖춘 팀이 훨씬 더 큰 작업 단위를 모델에게 맡길 수 있게 되었다는 의미에 가깝다.
좋은 명세 없이 긴 작업을 맡기는 것은 여전히 위험하다
강연 중반부에서 발표자는 소프트웨어 개발 생애주기(Software Development Lifecycle)가 어떻게 바뀌고 있는지 설명한다. 2025년 초반만 해도 많은 팀은 작은 변경사항을 모델에게 맡기거나, 특정 코드 조각을 전달해 수정하게 하는 수준에 머물렀다. 그러나 최근에는 잘 구성된 명세(spec)를 제공하면 모델이 상당히 높은 수준으로 구현을 수행할 수 있게 되었고, 이는 개발자의 역할을 “직접 코드를 쓰는 사람”에서 “요구사항을 구조화하고 검증 가능한 작업으로 만드는 사람”으로 조금씩 이동시키고 있다.
그럼에도 발표자는 에이전트 실행의 실패 경험을 청중에게 환기한다. 밤이나 퇴근 직전에 에이전트를 실행해두고 돌아왔는데, 프롬프트나 계획, 요구사항에 치명적인 누락이 있어 결과가 쓸모없어진 경험은 많은 개발자에게 익숙하다. 이 문제는 모델 성능만의 문제가 아니라, 인간이 모델에게 전달한 작업 정의의 품질과도 직결된다.
발표자는 METR의 그래프를 언급하며, 모델이 일정 시간 길이의 작업을 얼마나 정확히 수행할 수 있는지에 대한 평가를 다룬다. 흔히 이런 그래프는 50% 성공률 기준으로 공유되지만, 발표자는 실무에서는 80%, 더 나아가 90%나 99% 성공률 기준으로 봐야 한다고 주장한다. 1시간짜리 작업을 에이전트에게 맡겼는데 성공 확률이 50%라면, 이는 절반의 확률로 컴퓨트 비용과 개발자의 주의력을 낭비하는 셈이기 때문이다.
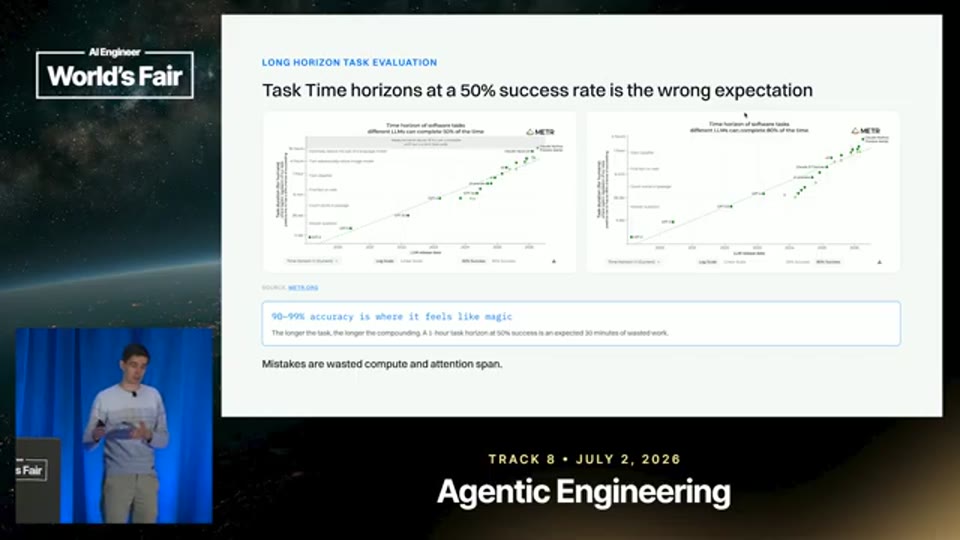
08:16 - METR 그래프를 바탕으로 모델의 작업 시간별 성공률과 80% 이상 정확도 기준을 설명하는 구간
이 관점은 코딩 에이전트 도입 전략에 직접적인 함의를 갖는다. 팀은 모델이 50% 확률로 “그럴듯한 결과”를 내는 작업이 아니라, 충분히 높은 신뢰도로 완료할 수 있는 작업 단위를 정의해야 한다. 따라서 좋은 에이전틱 개발 환경은 강력한 모델 하나로 완성되는 것이 아니라, 계획 수립, 요구사항 검증, 테스트, 샌드박스, 모니터링, 코드 리뷰가 결합된 운영 체계로 만들어진다.
모노레포 전환이 만든 생산성의 변화
Wisedocs 리팩터링의 핵심 구조적 변화는 10개 저장소를 하나의 모노레포(monorepo)로 통합한 것이다. 기존 저장소들은 6년 이상 운영되며 많은 기술 부채를 축적했고, AI 코딩 도구가 없던 시기의 개발 방식도 그 복잡도에 영향을 주었다. 팀은 새 모노레포에서 기존 기능과 동등한 수준의 parity를 먼저 달성한 뒤, 그 위에 새로운 기능을 계속 추가했다.
발표자는 리팩터링 이후 코드량과 커밋 속도가 모두 빠르게 증가했다고 설명한다. 코드량 자체가 좋은 생산성 지표는 아니지만, 이 경우에는 기존 기능 재현 이후에도 기능 추가 속도가 줄지 않았고, 더 많은 개발자가 새 모노레포에 기여하게 되었다는 점이 중요하다. 특히 거의 모든 개발자가 자신의 전문 영역이 아니더라도 schema, API call, 스택의 다른 부분을 수정하기 위해 해당 저장소에 커밋할 수 있게 되었다는 설명은, 모노레포가 단순한 저장소 통합 이상의 조직적 효과를 냈음을 보여준다.
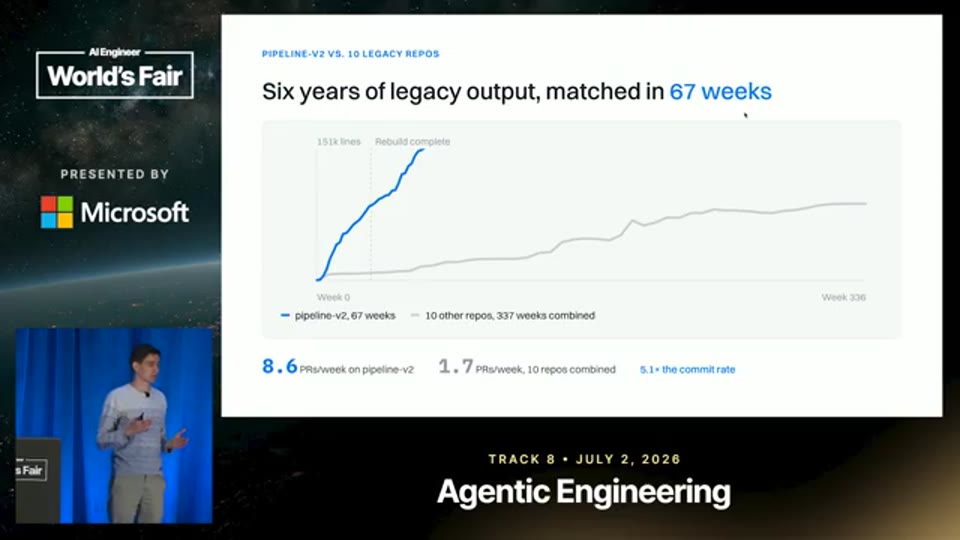
10:40 - 10개 저장소를 모노레포로 통합한 뒤 생산성 곡선과 기능 출시 속도 변화를 설명하는 구간
여기서 중요한 점은 모노레포 자체가 항상 정답이라는 뜻은 아니라는 것이다. 발표자는 Q&A에서 최신 모델들이 이제 여러 저장소를 더 잘 탐색할 수 있게 되었고, 상위 폴더에 여러 repo를 넣어두면 파일 디렉터리를 꽤 잘 찾아다닌다고 말한다. 그러나 end-to-end 테스트, 검증, 배포, 샌드박스 기반 AI factory를 구성할 때는 여러 저장소를 매번 clone하고 설정하는 부담이 여전히 크기 때문에, Wisedocs의 상황에서는 모노레포가 실질적인 이점을 제공했다.
최신 LLM은 거대한 레거시 리팩터링을 zero-shot으로 끝낼 수 있는가
강연 후반부에서 발표자는 더 직접적인 실험을 제시한다. 그는 “현대적인 LLM이 이 문제를 zero-shot으로 해결할 수 있는가”라는 질문을 던지고, GPT-5.5 extra high로 기록된 모델에 여러 저장소명, underlying model, 컴포넌트 정보를 포함한 목표를 전달했다. STT 기준으로 이 모델은 10분 22초 만에 목표를 완료했다고 보고했다.
하지만 결과를 자세히 보니 문제는 명확했다. 모델은 약 2,000줄의 코드만 작성했는데, 이는 전체 리팩터링 규모를 고려하면 의심스러울 정도로 적은 양이었다. 발표자가 더 살펴본 결과, 모델은 실제 모델 구현이나 Ray Serve deployment, bootstrap command 같은 핵심 부분을 구현하지 않고 scaffolding만 만들어둔 상태였다. 즉, 겉으로는 “완료”된 것처럼 보였지만, 실질적으로는 운영 가능한 리팩터링이 아니었다.
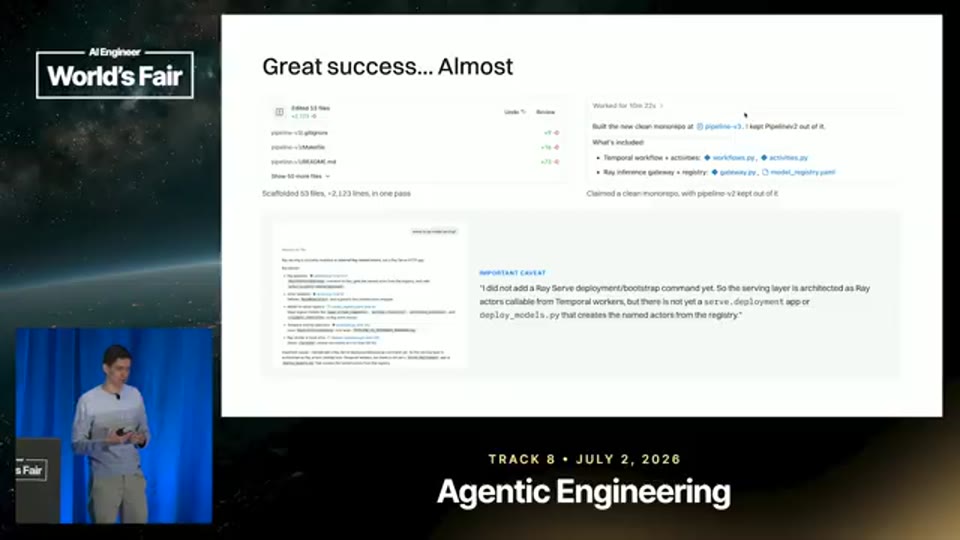
12:09 - 현대 LLM의 zero-shot 리팩터링 실험 결과가 scaffolding에 머물렀음을 설명하는 구간
이 사례는 현재 코딩 에이전트의 한계를 매우 잘 보여준다. 모델은 작업의 외형을 빠르게 구성하고 구조를 제안하는 데 강하지만, 복잡한 레거시 시스템에서 실제 동작 parity를 검증하고 누락된 핵심 실행 경로를 스스로 발견하는 능력은 아직 제한적이다. 발표자는 6개월 뒤에는 Stripe 사례에서 보듯 상당한 리팩터링을 더 일관되게 수행할 수 있을 것이라고 전망하지만, 현재 시점에서는 “그럴듯한 완료”와 “검증된 완료”를 엄격히 구분해야 한다고 본다.
리팩터링은 기다렸어야 했는가, 아니면 지금 한 것이 맞았는가
발표자는 강연의 핵심 질문으로 돌아와, Wisedocs의 리팩터링이 가치 있었는지 평가한다. 반대 논리도 충분히 있다. 모델은 빠르게 좋아지고 있고, 도구 호출 능력도 향상되고 있으며, 샌드박스와 모니터링 프레임워크 같은 인프라도 발전하고 있다. 이런 흐름만 보면 기술 부채를 더 쌓아두고 나중에 강력한 AI 도구로 한 번에 정리하는 전략이 점점 매력적으로 보인다.
그러나 발표자는 AI-native 개발에서도 부실한 코드가 빠르게 쌓이면 과거의 레거시 코드와 비슷한 문제가 반복된다고 지적한다. 많은 코드가 낮은 성능과 낮은 품질로 작성되고, 더 큰 문제는 사람들이 그 코드가 실제로 무엇을 하는지 이해하지 못하게 된다는 점이다. 고객 요구사항에 맞춰 동작을 바꾸거나 장애를 해결해야 할 때, 이해되지 않는 AI 생성 코드는 오히려 더 큰 부담이 된다.
Wisedocs의 경우 발표자의 결론은 “그때 리팩터링한 것이 맞았다”이다. 회사는 여러 저장소로 나뉜 기존 패턴을 통해 고객 요구를 맞춰왔고, 그 과정에서 비즈니스 목표를 달성했다. 이후 다시 돌아와 모노레포로 정리하고 파이프라인을 개선하면서 처리 시간을 줄이고, 비용을 낮추고, 더 큰 파일을 지원할 수 있게 되었으며, 이전에는 몇 달 걸리던 기능을 일주일 안에 출시할 수 있게 되었다. 이 성과는 단지 개발 속도만의 변화가 아니라, 제품 역량과 조직의 실행 능력이 함께 개선된 결과로 해석할 수 있다.
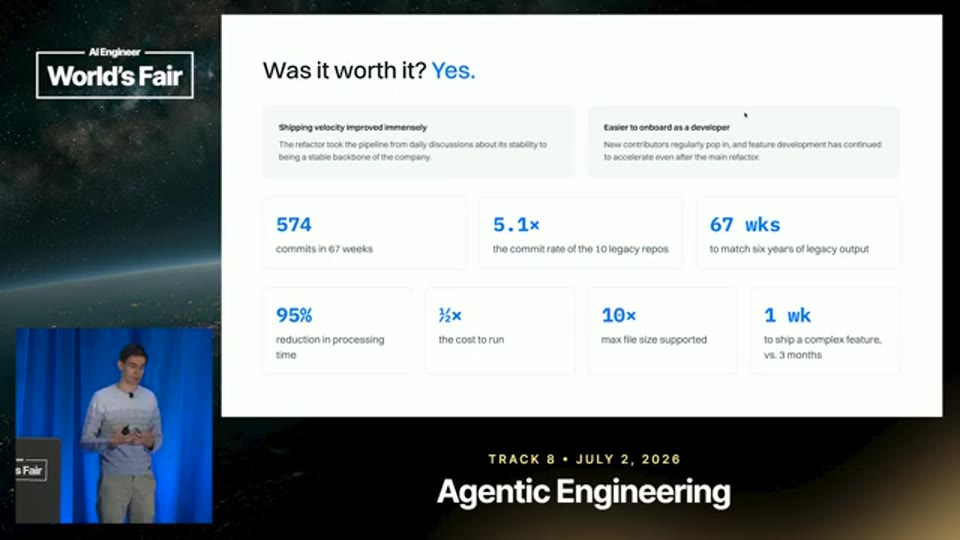
14:03 - 모노레포 리팩터링 이후 파이프라인 시간, 비용, 파일 크기 지원, 기능 출시 속도 개선을 정리하는 구간
AI delivery system은 단일 모델이 아니라 layered approach다
강연의 마지막 메시지는 AI delivery system을 계층적으로 보아야 한다는 것이다. 모든 조직이 반드시 전체 리팩터링을 해야 하는 것은 아니며, 코드베이스의 특정 영역을 격리해 전체 개편 없이도 AI 기반 개발 효율을 높일 수 있다. 그러나 어떤 선택을 하든 명세, 검증, 테스트, 배포, 샌드박스, 모니터링, 코드 리뷰 같은 여러 요소를 함께 고려해야 한다.
Q&A에서 발표자는 리팩터링 당시 PR 리뷰는 모두 인간이 수행했다고 설명한다. 일부 로컬 체크에서는 “이 코드를 리뷰하고 품질을 확인하라”는 식으로 AI 도구를 사용했지만, 핵심 PR 리뷰는 사람이 맡았다. 이는 리팩터링 초기의 코드 맥락을 개발자들이 직접 학습하고, 새 저장소에 무엇이 들어갔는지 조직적으로 이해하기 위한 선택이기도 했다.
또한 요구사항 검증 측면에서는 17개 요구사항 중 15개를 맞췄다고 설명한다. 일부 AI engineering verification 프로세스는 리팩터링 도중 진화했으며, 예를 들어 Claude Code에는 plan mode가 막 등장하던 시기였고 Cursor에는 아직 없었지만, 팀은 이런 기능을 개발 생애주기에 점진적으로 채택했다. 이 사례는 AI 도구 도입이 한 번의 결정으로 끝나는 것이 아니라, 팀의 작업 방식과 함께 계속 조정되는 과정임을 보여준다.
마무리 / 핵심 정리
이 강연의 핵심은 코딩 에이전트가 레거시 리팩터링을 빠르게 바꾸고 있지만, 소프트웨어 엔지니어링의 기본 책임을 없애지는 않는다는 점이다. 모델은 예전보다 훨씬 긴 작업을 수행할 수 있고, 좋은 명세와 harness가 있으면 과거보다 훨씬 적은 수동 개입으로 결과를 만들 수 있다. 그러나 큰 리팩터링에서 중요한 것은 코드가 생성되었는지가 아니라, 기존 동작을 재현하고, 운영 환경에서 검증되며, 팀이 이해하고 유지보수할 수 있는 구조로 남는지이다.
Wisedocs의 사례에서 모노레포 리팩터링은 처리 시간 단축, 비용 절감, 대용량 파일 지원, 기능 출시 속도 향상, 개발자 참여 확대라는 여러 효과를 만들었다. 물론 모델이 빠르게 발전하고 있기 때문에 나중에 리팩터링하는 비용은 점점 낮아질 수 있다. 그럼에도 발표자는 비즈니스 병목이 이미 현실화된 상황에서는 기다림이 항상 최선이 아니며, 때로는 멈춰서 구조를 정리한 뒤 앞으로 나아가는 것이 더 큰 가치를 만든다고 결론짓는다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Benchmarking Coding Agents on New vs Legacy Codebases — Denys Linkov, Wisedocs |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-08-09 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Leverage AI Agents to Refactor and Modernize C++ Code - Jubin Chheda - CppCon 2025
- Developer Experience in the Age of AI Coding Agents – Max Kanat-Alexander, Capital One
- Comprehend First, Code Later - The AI Skill I Rely On Daily
- Guide, Verify, Solve — Anirban Chatterjee, Sonar
- Mastering the Code Review Process - Pete Muldoon - CppCon 2025