GenAI는 데이터 과학자의 것인가
📺 원본 영상: Does GenAI “belong” to data scientists? — Phil Hetzel, Braintrust 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-26 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Braintrust의 솔루션 엔지니어링 팀을 이끄는 Phil Hetzel은 이 강연에서 “AI 에이전트 개발은 과연 데이터 과학자(Data Scientist)나 머신러닝 엔지니어(ML Engineer)의 것인가?”라는 도발적인 질문을 출발점으로 삼는다. 그는 전통적 ML과 GenAI의 구조적 차이를 명확히 짚으면서, 에이전트 개발에 데이터 과학자가 기여할 수 있는 방식과 동시에 그 한계도 솔직하게 드러낸다. 결론적으로 강연자는 어느 한 직군이 에이전트를 “소유”하는 방식 자체에 문제를 제기하며, 다양한 배경을 가진 팀이 협력하는 구조가 필수적이라는 주장을 펼친다.
강연자 소개 및 Braintrust
Phil Hetzel은 컨설팅과 시스템 구현 분야에서 12년을 보낸 경력자로, 직전 역할은 Slalom Consulting에서 글로벌 Databricks 비즈니스 유닛을 이끄는 것이었다. 그 시절 그가 목격한 공통적인 문제는, 고객사들이 생성형 AI(Generative AI)의 개념 검증(Proof of Concept)을 만드는 데는 능숙하지만, 그것을 실제 프로덕션으로 가져오는 데는 현저히 취약하다는 점이었다. 그 문제의식이 결국 그를 Braintrust의 사용자에서 직원으로 이끌었다.
Braintrust는 강연자가 정의하는 “에이전트 품질 플랫폼(Agent Quality Platform)“이다. 이 플랫폼은 두 가지 축으로 구성되는데, 하나는 에이전트를 프로덕션에 배포하기 전 실험과 튜닝 단계에서 수행하는 평가(Evals)이고, 다른 하나는 실제 사용자와 마주친 이후에도 에이전트가 의도한 대로 작동하는지를 지속적으로 추적하는 관측 가능성(Observability)이다. 강연자는 이 두 축이 맞물려야 비로소 에이전트의 신뢰성이 확보된다고 강조하며, 플랫폼 소개는 간략히 마무리하고 본론으로 넘어간다.
두 종류의 조직: 전통 기업 vs AI 네이티브
강연자는 자신이 지난 1년간 다양한 산업에 걸쳐 에이전트를 구축하는 최전선 팀들을 관찰하면서 두 가지 뚜렷이 다른 유형의 조직을 발견했다고 말한다. 하나는 전통적 대기업(Traditional Enterprise)이고, 다른 하나는 AI 네이티브(AI Native) 기업이다.
전통적 대기업의 경우, 에이전트 개발의 출발점이 현장 기술자가 아니라 경영진의 지시에서 비롯되는 경우가 많다. CEO나 CIO가 어느 잡지에서 “에이전트를 구축해야 한다”는 기사를 읽고, 담당자에게 지시를 내리며, 이 지시는 다시 기존의 ML 또는 데이터 과학 플랫폼 팀으로 위임된다. 이 과정이 자연스럽게 반복되는 이유는, 생성형 AI에 “AI”라는 단어가 들어있기 때문에 이미 AI를 다루던 팀에 맡기는 것이 논리적으로 보이기 때문이다. 강연자는 이를 가리켜 “맥락 없이 넘겨지는 역할(delegation without context)“이라고 암묵적으로 비판한다.
반면 AI 네이티브 기업들은 출발점 자체가 다르다. 이들은 생성형 AI가 본격화되기 이전에는 딱히 ML 플랫폼 팀 같은 것이 존재하지 않았던 경우가 많으며, 처음부터 에이전트를 제품의 핵심 축으로 삼고 조직을 구성했다. 그 결과 이들은 제품 엔지니어링과 AI 엔지니어링을 따로 구분하지 않고, 소수의 엔지니어가 양쪽을 모두 담당하는 크로스펑셔널(Cross-functional) 구조로 운영된다. 강연자가 특히 주목하는 차이점은, 이처럼 팀이 작을수록 각 구성원이 “에이전트가 실제로 무엇을 해결해야 하는가”라는 문제에 더 가까이 있다는 점이다. 이 근접성(Proximity to the Problem)은 이후 에이전트 품질을 결정하는 핵심 변수로 반복적으로 등장한다.
전통적 ML과 GenAI의 구조적 차이
강연자는 두 패러다임의 차이를 두 가지 핵심 축에서 정리한다. 첫 번째 차이는 “모델을 누가 만드는가”의 문제다.
전통적인 ML 워크플로에서 데이터 과학자와 ML 엔지니어가 하는 일의 본질은, 데이터를 수집하고 파이프라인을 설계하며, 모델을 학습시키고, 과적합(Overfitting)을 방지하기 위한 검증을 거친 뒤, 최종적으로 다운스트림 제품 팀이 사용할 수 있도록 모델을 배포하는 것이다.
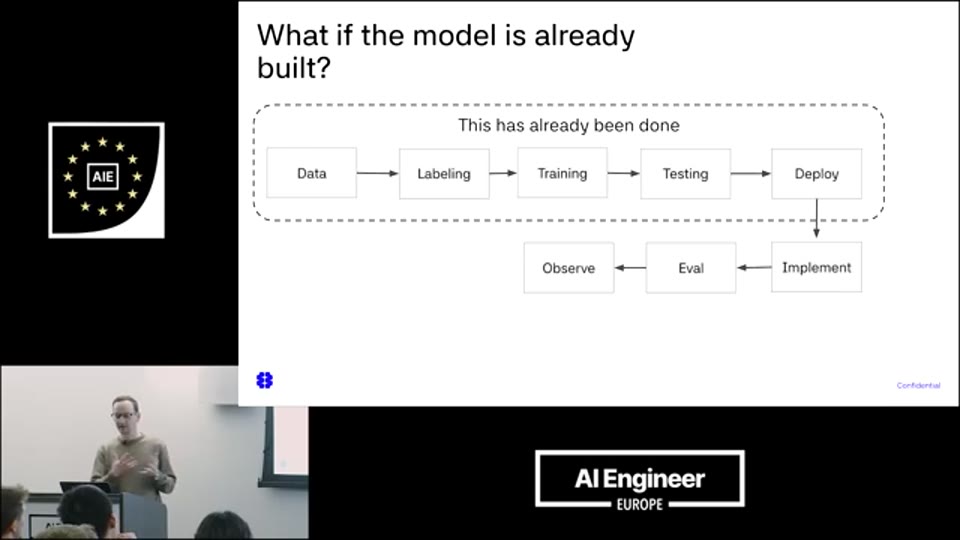
06:14 - Anthropic, OpenAI, Mistral 등이 이미 완료한 LLM 학습 파이프라인 도식. 전통적 ML 파이프라인과 비교하여 GenAI에서는 모델 학습 과정이 생략됨
그런데 GenAI의 세계에서는 이 파이프라인 전체가 이미 완료된 상태다. Anthropic, OpenAI, Mistral 같은 회사들이 대규모 데이터를 수집하고, 학습 파이프라인을 돌리고, 기반 LLM(Large Language Model)을 학습시킨 뒤 API 엔드포인트(Endpoint)를 통해 소비자에게 제공하는 과정을 이미 마쳤다는 것이다. 단, 강연자는 여기서 중요한 단서를 하나 붙인다. Anthropic이나 OpenAI가 자체적인 테스트를 수행하더라도, 그 API를 자신의 제품에 통합한 AI 팀 역시 반드시 자체적인 평가(Evals)를 수행해야 한다는 점이다. 이는 두 이미지 사이의 유일하지만 결코 가볍지 않은 차이이며, 이 지점이 Braintrust 같은 플랫폼이 존재하는 이유이기도 하다.
두 번째 차이는 “어떻게 모델의 동작을 바꾸는가”다. 전통적 ML에서 모델을 개선하려면 더 많은 데이터를 추가하거나 특성 공학(Feature Engineering)을 통해 입력을 조정하고, A/B 테스트로 변화의 효과를 측정해야 한다. 하지만 GenAI에서는 모델이 이미 학습된 상태이므로, 파인튜닝(Fine-tuning)을 제외하면 동작을 바꾸는 핵심 수단은 “입력을 바꾸는 것”, 즉 프롬프트(Prompt)와 컨텍스트(Context)를 조정하는 컨텍스트 엔지니어링(Context Engineering)이다. 강연자는 이 점을 강조하며, 컨텍스트 엔지니어링을 잘 수행할 수 있는 사람이 반드시 ML 배경을 가진 사람이 아닐 수도 있다고 암시한다.
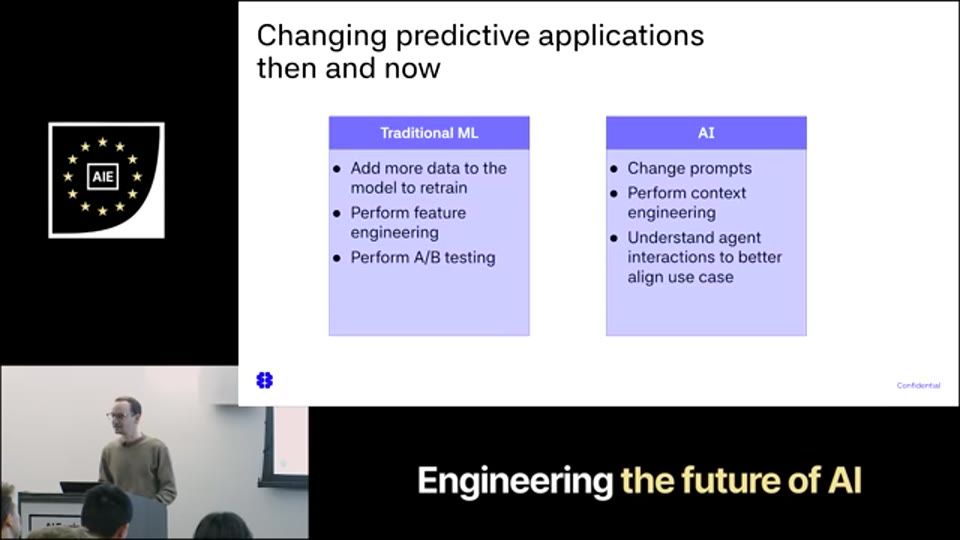
07:15 - 전통적 ML의 A/B 테스트 방식과 GenAI의 프롬프트/컨텍스트 변경 방식을 비교하는 슬라이드
찬반 논증: 에이전트는 데이터 과학자의 것인가
찬성측 논거: 데이터 과학자가 적합하다
강연자는 먼저 데이터 과학자가 에이전트 개발을 주도해야 한다는 입장을 공정하게 대변한다. 첫째, 에이전트는 모델을 사용하며, 많은 조직에서 모델은 이미 데이터 과학자의 관할이다. 데이터 과학자는 신경망(Neural Network)이 어떻게 작동하는지에 대한 심층적인 이해를 바탕으로 LLM이 어떻게 동작하는지도 이해할 수 있으며, 이 지식 덕분에 이 기술이 내포하는 위험성을 더 잘 인식할 수 있다. 둘째, 데이터 과학자들은 모델과 모델 자산을 프로덕션으로 밀어 넣는 엄격한 프로세스를 이미 갖추고 있다. 셋째, 이와 맞닿아 있는 덕목으로, 데이터 과학자들은 테스팅에 대한 강한 규율을 체화하고 있다는 점이다.
반대측 논거: 데이터 과학자만으로는 부족하다
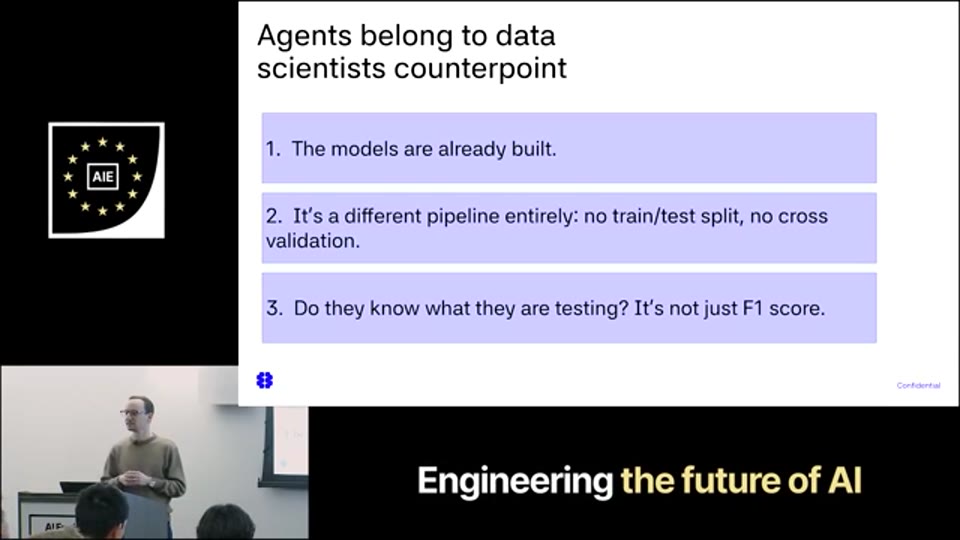
그러나 강연자는 더 강력한 반론을 제시한다. 우선, 모델을 직접 학습시킬 필요가 없으므로 크로스 밸리데이션(Cross-validation) 같은 전통적 ML 절차는 아무런 의미가 없다.
그가 제시하는 가장 강력한 반론은 “ML 엔지니어나 데이터 과학자는 자신이 무엇을 테스트해야 하는지 실제로 알고 있는가?”라는 질문이다. 강연자가 관찰한 바에 따르면, 일부 팀은 정밀도(Precision), 재현율(Recall), F1 점수 같은 전통적인 ML 지표에 집착하는 경향이 있다. 이 지표들은 그들을 지금까지 성공으로 이끌어 온 것들이기 때문이다. 그러나 에이전트를 평가할 때는 기술적 성능(Technical Performance)이라는 이중 박스를 넘어서, 에이전트의 기능적 성능(Functional Performance)이라는 훨씬 넓은 평가 표면(Surface Area)을 다뤄야 한다. 기존의 지표만으로 에이전트를 판단하는 것은, 마치 자동차를 평가할 때 엔진 스펙만 보고 실제 도로 주행 경험을 무시하는 것과 같다.
09:22 - 데이터 과학자들이 집착하는 Precision, Recall, F1 지표와 에이전트 평가에 필요한 더 넓은 Functional Performance 평가 표면 비교
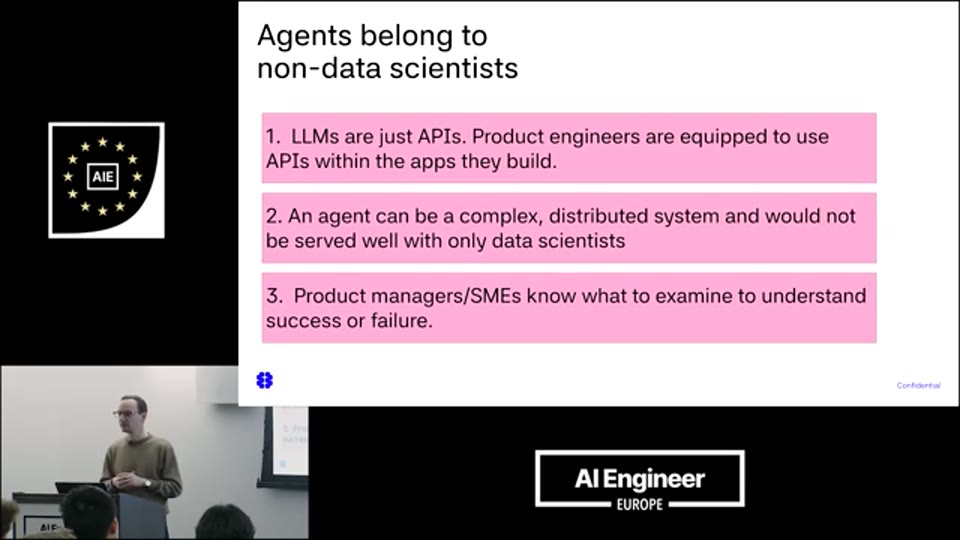
또 다른 반론은 인프라 복잡성에 관한 것이다. 복잡한 에이전트 시스템은 슈퍼바이저 에이전트(Supervisor Agent)가 여러 자식 에이전트(Sub-agent)를 호출하는 분산 구조를 가지며, 각 서브 에이전트는 서로 다른 인프라에서 실행되면서 각기 다른 외부 시스템과 연동될 수 있다. 이는 순수한 시스템 엔지니어링 문제로, 통계나 수학 배경을 가진 사람이 반드시 강점을 보이는 영역은 아니다.
10:34 - 슈퍼바이저 에이전트가 여러 서브 에이전트를 호출하는 분산 에이전트 아키텍처 다이어그램
마지막으로, 비기술적 전문가의 역할을 강조한다. 에이전트에게 주어지는 실제 프롬프트(Prompt)를 설계하는 데 있어 해당 도메인의 문제를 가장 잘 이해하는 사람, 즉 주제 전문가(Subject Matter Expert)나 프로덕트 매니저(Product Manager)의 참여가 결정적이다. 뿐만 아니라, 에이전트가 올바르게 작동하는지 여부를 사람이 직접 판단하는 인간 어노테이션(Human Annotation) 워크플로에서도, 도메인 지식을 가진 비기술자가 에이전트 추적(Trace)을 보고 “이 결과가 올바른가, 아닌가, 그 이유는 무엇인가”를 판단할 수 있다는 점에서 큰 가치를 발휘한다.
데이터 과학자가 실제로 기여할 수 있는 방법
강연자는 “데이터 과학자는 제품 자체를 만드는 일에 기여하는 것은 당연하다”는 전제를 깔고, 그 위에 추가적으로 기여할 수 있는 고유한 역할 세 가지를 제시한다.
첫째는 “방의 어른(Adult in the Room)” 역할이다. 많은 팀이 LLM을 과도하게 신뢰하면서 공격적으로 도입하는데, 이 기술의 기반 원리를 이해하지 못한 채로 그렇게 한다. 데이터 과학자는 “LLM은 결국 토큰을 하나씩 예측하는 통계 문제의 집합일 뿐이며, 그 자체로 무언가를 ‘알고 있는’ 것이 아니다”라는 사실을 상기시켜 줌으로써, 조직이 기술에 대한 과도한 기대로 실패하지 않도록 하는 브레이크 역할을 할 수 있다.
둘째는 LLM-as-Judge 평가의 검증이다. 에이전트 평가 과정에서 LLM을 심판으로 사용하는 것(LLM-as-Judge)은 매력적인 접근이지만, 이 역시 프롬프트와 모델의 조합일 뿐이다. 강연자는 레이블이 달린 데이터셋(Labeled Dataset)을 구성한 뒤, 그 위에서 전통적인 정밀도, 재현율, F1 지표를 적용하여 LLM-as-Judge가 실제로 신뢰할 만한지를 검증하는 과정에 데이터 과학자의 전문성이 핵심적으로 활용된다고 말한다.
셋째는 오픈소스 모델 파인튜닝이다. 특정 사용 사례에 최적화된 오픈소스 모델을 파인튜닝해야 하는 상황이 발생할 때, 이는 가장 기술적으로 깊은 작업이며 데이터 과학자와 ML 엔지니어가 가장 큰 가치를 발휘할 수 있는 영역이다. 강연자는 이를 “가장 재미있고 기술적인 기여”라고 표현했다.
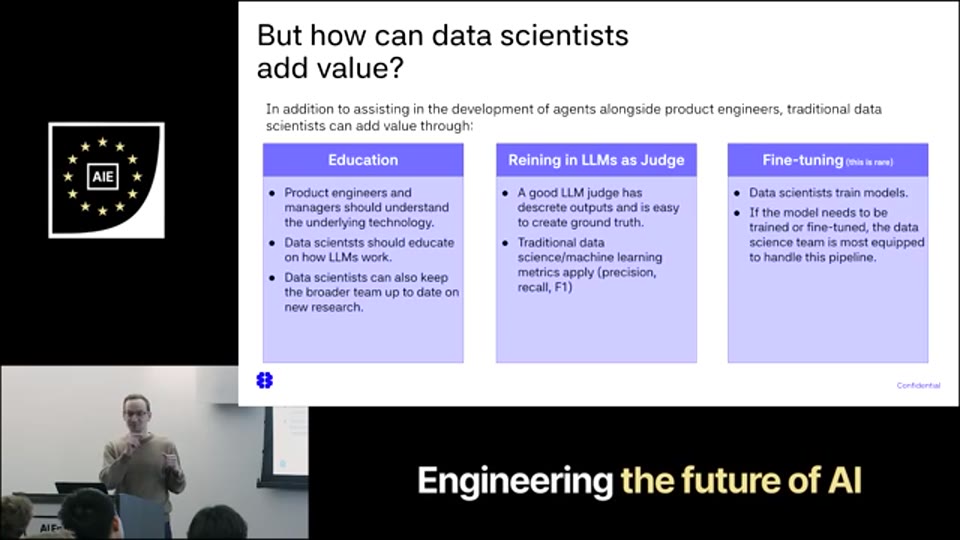
13:19 - 데이터 과학자가 GenAI 팀에서 수행할 수 있는 역할 목록 - 가드레일 설계, LLM-as-Judge 검증, 파인튜닝
이상적인 팀 구성
강연자가 제시하는 이상적인 팀은 세 종류의 기여자로 구성된다. 데이터 과학자와 ML 엔지니어는 앞서 언급한 방식으로 기여하며, 제품 엔지니어와 시스템 엔지니어는 비기술 전문가들로부터 받은 요구사항을 실제 제품에 구현하고 에이전트가 실행되는 시스템의 품질을 보장한다. 그리고 비기술 도메인 전문가들은 인간 어노테이션과 프롬프트 및 컨텍스트 엔지니어링을 주도한다. 이들이 에이전트가 해결하려는 문제에 가장 가깝기 때문에, 이들을 팀 안으로 끌어들이지 않으면 에이전트가 실제 사용 케이스와 동떨어지는 결과를 낳는다.
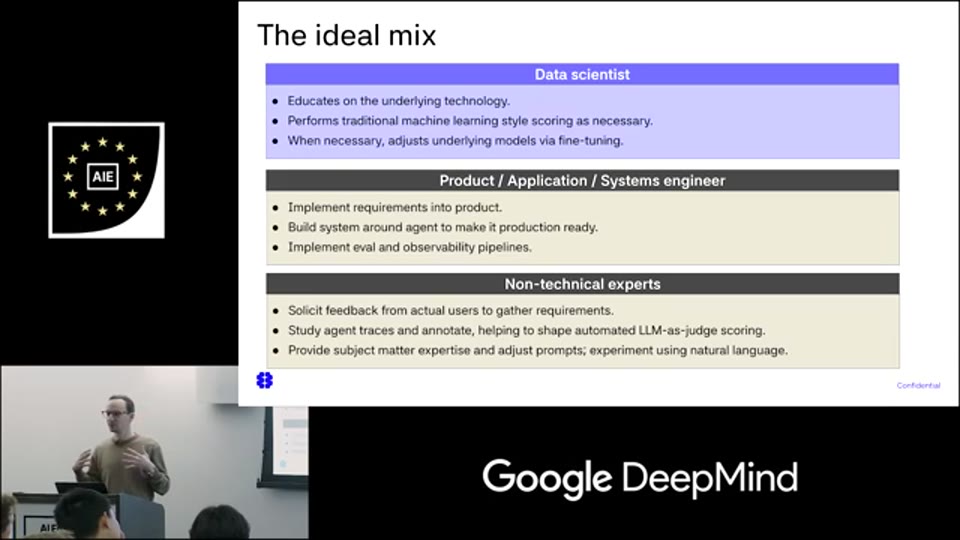
14:19 - 이상적인 팀 구성 - 데이터 과학자/ML 엔지니어, 제품/시스템 엔지니어, 비기술 도메인 전문가의 역할 분담
강연자는 또한 평가(Evals)와 관측 가능성(Observability) 파이프라인을 구현하여, 프로덕션에서 벌어지는 일과 실험 단계에서 벌어지는 일 사이의 피드백 루프(Feedback Loop)를 만드는 것이 팀 전체의 공통 목표가 되어야 한다고 강조한다. 이 루프가 없으면 팀은 자신들이 구축한 에이전트가 실제 세계에서 어떻게 작동하는지 영구적으로 알 수 없는 상태가 된다.
Q&A: 핵심 질문과 강연자의 답변
청중 질문 중 가장 인상적인 것은, “에이전트를 특정 팀의 ‘도구’로 보기보다, 풀어야 할 문제를 중심으로 놓고 에이전트를 그 도구로 보면 어떻겠느냐”는 관점의 제안이었다. 강연자는 이에 대해 “우리는 사실 같은 방식으로 생각하고 있다”고 동의하면서, 전통적인 기업에서 흔히 저지르는 실수가 바로 에이전트를 “또 다른 예측 모델”처럼 취급하여 ML 팀에게만 고립시키는 것이라고 재차 강조했다. 에이전트는 다양한 배경을 가진 팀이 함께 만드는 제품이라는 것이 그의 핵심 주장이다.
두 번째 질문은 도메인 전문가가 시스템에 진입하기 위한 도구가 부족하다는 현실적인 문제를 지적했다. 강연자는 Braintrust가 인간 레이블링(Human Labeling) 컴포넌트와 에이전트 및 프롬프트 플레이그라운드(Playground)를 통해 비기술자가 직접 프롬프트를 실험하고 에이전트에 전달할 수 있는 환경을 제공하고 있다고 답했다. 또한 프로덕션에서 수집한 실제 데이터를 지속적으로 오프라인 평가 데이터셋에 추가하여, 평가 체계가 인간의 판단과 점점 더 정합하는지 아니면 멀어지는지를 스스로 점검할 수 있는 구조를 구축하는 것이 핵심이라고 덧붙였다.
마무리 / 핵심 정리
이 강연의 결론은 “정답은 항상 중간에 있다”는 한 문장으로 요약된다. 강연자는 데이터 과학자나 ML 엔지니어에게 “당신의 스킬셋을 전부 버려야 한다”고 말하지 않는다. 오히려 그들의 역할은 여전히 유효하며, 특히 기술적 위험의 관리자, 평가 체계의 설계자, 그리고 필요시 파인튜닝을 수행하는 전문가로서 에이전트 개발 생태계에서 중요한 자리를 차지한다.
그러나 에이전트 개발을 데이터 과학자 혼자, 혹은 ML 팀만의 책임으로 고립시키는 것은 이 기술이 가진 복합적인 성격을 무시하는 처사다. 에이전트는 기술적 문제인 동시에 도메인 지식의 문제이고, 시스템 설계의 문제이며, 사용자 경험의 문제다. 이 모든 차원을 아우르려면, 서로 다른 배경과 근접성(Proximity)을 가진 사람들이 같은 방 안에 앉아야 한다. 강연자가 반복해서 강조하는 “문제에 대한 근접성”이야말로, 어떤 팀 구성을 선택하든 반드시 확보해야 할 단 하나의 조건이다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Does GenAI “belong” to data scientists? — Phil Hetzel, Braintrust |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-05-26 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- The maturity phases of running evals — Phil Hetzel, Braintrust
- How agent o11y differs from traditional o11y — Phil Hetzel, Braintrust
- Stop Burning Tokens - Why self-improvement needs domain expertise first - Annabell Schafer, Langfuse
- Hierarchical Memory - Context Management in Agents — Sally-Ann Delucia
- Skills are the New SDKs - Elvin Aghammadzada, DataRobot