Gemma 4 — 구글 딥마인드의 오픈 모델 패밀리 완전 해부
📺 원본 영상: Gemma, DeepMind’s Family of Open Models — Omar Sanseviero, Google DeepMind 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-04-21 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 Google DeepMind의 Developer Relations 엔지니어 Omar Sanseviero가 Gemma 4 출시 불과 7일 후 AI Engineer 컨퍼런스에서 직접 발표한 내용이다. Gemma는 Google이 공개한 오픈 모델(Open Model) 패밀리로, 누구나 다운로드하여 자신의 인프라나 디바이스에서 직접 실행하고 파인튜닝할 수 있는 모델군을 의미한다. 이번 강연에서는 Gemma 4의 모델 구성, 혁신적인 Per-Layer Embeddings 아키텍처, 멀티모달·다국어 역량, 생태계 현황, 그리고 온디바이스 AI의 미래 방향성을 폭넓게 다루었다.
Gemma 4 패밀리 — 20억에서 310억 파라미터까지
Gemma 4는 Google이 지금까지 공개한 오픈 모델 중 가장 강력한 패밀리로, 파라미터 수 기준 약 20억(E2B)에서 310억(31B)에 이르는 다양한 규모의 모델로 구성되어 있다. 각 모델은 용도와 실행 환경에 따라 뚜렷이 구분되는 포지셔닝을 갖는다.
가장 작은 모델군은 Android 스마트폰, iPhone, 심지어 Raspberry Pi에서도 실행될 만큼 극소형(Edge) 환경에 최적화되어 있다. 이 소형 모델들도 멀티모달 이해 능력과 추론(Reasoning) 기능을 갖추고 있어, 단순한 텍스트 처리를 넘어 에이전틱(Agentic) 작업을 온디바이스에서 처리할 수 있다. 그 위 계층에는 MoE(Mixture of Experts) 아키텍처를 채택한 약 27B 규모의 모델이 위치하는데, 빠른 속도와 낮은 지연(Low Latency)에 강점을 가진 모델로 고처리량 추론 시나리오에 적합하다. 최상위에는 31B 규모의 고성능 모델이 있으며, 이 모델조차 소비자용 GPU 한 대에서 실행 가능하다는 점이 Gemma 패밀리의 철학을 잘 보여준다. 강연자는 이를 “개발자 친화적 크기(Developer-friendly sizes)“라고 표현하며 패밀리 전체에 일관되게 적용된 원칙이라고 강조했다.
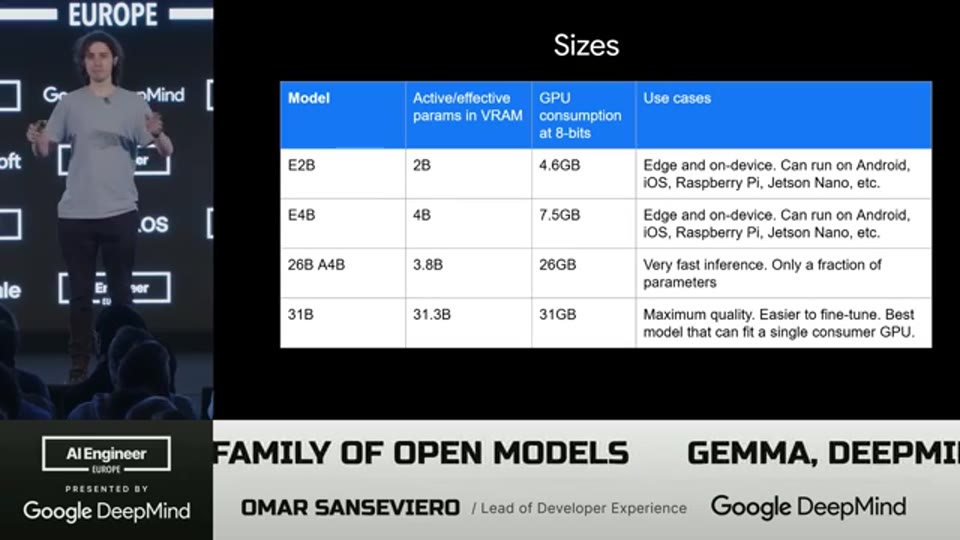
01:35 - Gemma 4 전체 패밀리 라인업 슬라이드 — E2B부터 31B까지 모델 구성 및 ‘E’ 표기 의미 설명
핵심 아키텍처 혁신 — Per-Layer Embeddings와 “E” 시리즈의 비밀
Gemma 4 패밀리에서 가장 주목할 만한 기술적 혁신은 모델명의 “E”가 의미하는 Per-Layer Embeddings(층별 임베딩) 아키텍처다. 예를 들어 E2B는 “Effectively 2 Billion(실효적 20억 파라미터)“을 의미하는데, 실제 총 파라미터 수는 약 40억(4B) 수준이지만 GPU에 로드해야 하는 파라미터는 20억에 불과하다. 이 차이를 만드는 것이 바로 Per-Layer Embeddings 기법이다. 강연자는 이 아키텍처가 지난해 연구를 통해 도입된 비교적 새로운 설계라고 밝혔다.
전통적인 Transformer 아키텍처에서는 모든 파라미터가 행렬 곱셈(Matrix Multiplication) 연산에 참여하기 때문에 고속 GPU 메모리(VRAM)에 올라가 있어야 한다. 반면 Per-Layer Embeddings는 각 레이어마다 별도의 임베딩 블록을 갖는 구조로, 이 임베딩 부분은 행렬 곱셈이 아닌 룩업 테이블(Lookup Table) 방식으로 동작한다. 룩업 테이블은 연산 비용이 극히 낮기 때문에 GPU가 아닌 CPU, 심지어 디스크에 저장해두어도 전체 추론 성능에 미치는 영향이 미미하다. 결과적으로 총 파라미터 규모 대비 훨씬 적은 GPU 메모리만으로도 모델을 실행할 수 있게 되는 것이다.
이 아키텍처는 실용적인 접근성도 높다. llama.cpp에서는 --override-tensor 플래그 하나만으로 Per-Layer Embeddings를 CPU나 디스크로 오프로드할 수 있어, 기존 워크플로우에서 별도의 복잡한 설정 없이 혜택을 누릴 수 있다. 강연자는 이 아키텍처 결정이 모바일·온디바이스 사용 시나리오를 위해 근본적으로 최적화된 설계라고 강조했다. 이것이 바로 E2B와 E4B 모델이 스마트폰 및 초저전력 디바이스용 소형 모델에 채택된 이유다.
온디바이스 실시간 데모 — 가능성의 생생한 증명
강연 현장에서 Omar는 세 가지 라이브 데모를 선보였다. 첫 번째는 Android 스마트폰에서 Gemma가 인터넷 연결 없이 완전히 로컬로 실행되는 데모였다. 사용자가 다양한 “스킬”을 선택할 수 있는 애플리케이션으로, 모델이 스스로 피아노 연주 같은 스킬을 선택하고 수행하는 완전한 에이전틱 파이프라인이 단말 내에서 동작했다. 두 번째 데모도 스마트폰에서 이루어졌는데, 비행기 모드(Airplane Mode) 상태에서 Gemma가 라이브 코딩을 수행하는 것이었다. API 호출이 전혀 없는 순수 로컬 실행임을 강조하며, 클라우드 의존 없이도 실질적인 코딩 보조가 가능함을 보여주었다.
세 번째 데모는 규모면에서 인상적이었다. 노트북 컴퓨터에서 llama.cpp를 활용해 Gemma 인스턴스 10개를 병렬로 실행하는 것이었는데, 각 에이전트가 서로 다른 SVG(Scalable Vector Graphics) 파일을 생성하는 코딩 작업을 동시에 수행했다. 초당 약 100 토큰의 속도를 유지하면서 수 초 만에 10개의 SVG가 완성되는 장면은, 온디바이스 병렬 에이전시가 이미 현실적인 수준에 도달했음을 체감하게 해주었다.
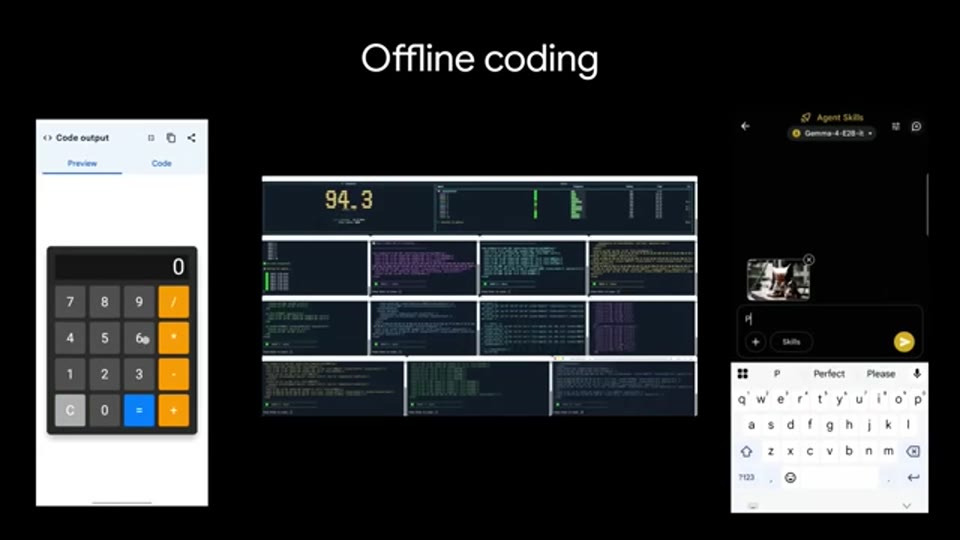
03:16 - 10개 Gemma 인스턴스가 병렬로 SVG를 생성하는 온디바이스 데모 — 결과물 10개가 화면에 표시되는 시점
LM Arena 성능 — 작은 크기로 높은 역량을 증명하다
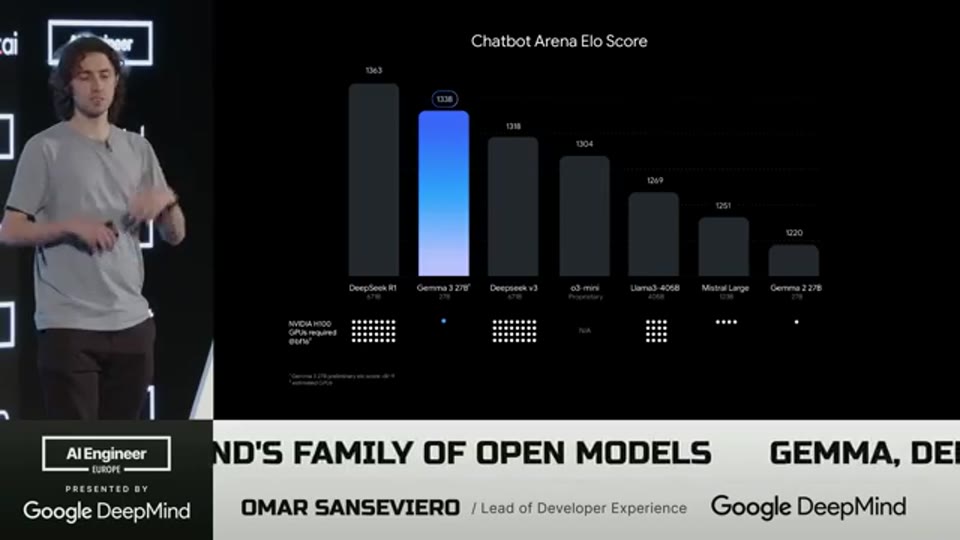
01:02 - Gemma 3의 LM Arena 점수 산점도 — 다양한 오픈 모델 비교 및 H100/A100 필요 대수 시각화
강연자는 LM Arena(커뮤니티 기반 LLM 선호도 평가 플랫폼)의 점수를 근거로 Gemma 4의 위상을 설명했다. X축은 모델 파라미터 수(규모), Y축은 LM Arena 점수를 나타내는 산점도에서, Gemma 4 모델들은 “좌측 상단 코너”, 즉 작은 규모임에도 높은 성능을 보여주는 영역에 집중 분포했다. 강연자는 LM Arena가 완벽한 벤치마크는 아니지만, 일반 대화나 실용적 사용 시나리오에서 커뮤니티가 모델을 얼마나 선호하는지를 측정하는 유효한 지표라고 설명했다.
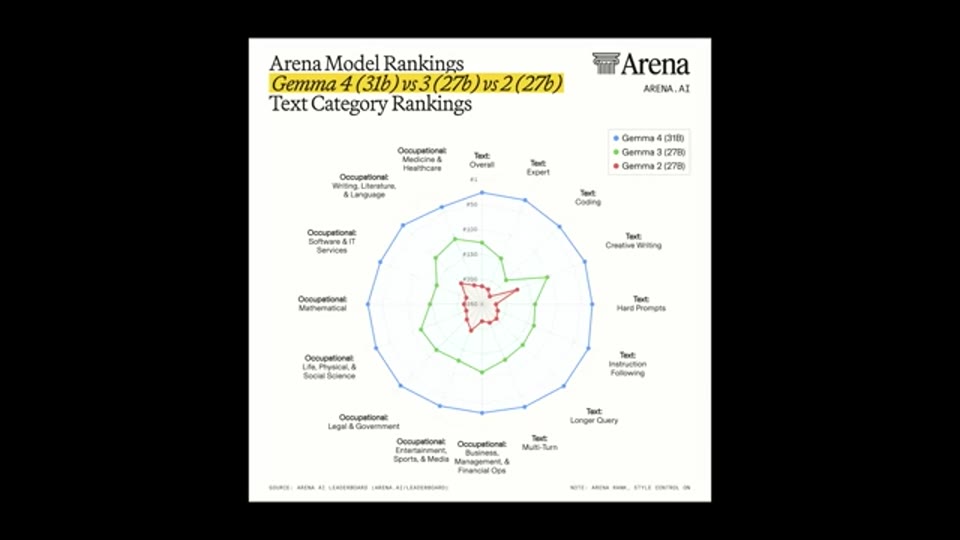
04:16 - LM Arena 산점도 — X축 파라미터 수, Y축 Arena 점수, 좌상단 코너에 위치한 Gemma 4 모델군
2년 전 Gemma 2, 1년 전 Gemma 3, 그리고 현재의 Gemma 4로 이어지는 세대별 진화를 보면, 모델 규모를 키우지 않고도 성능이 꾸준히 향상되어 왔다는 점이 두드러진다. 강연자는 이 추세를 근거로, 1~2년 내에 현재보다 훨씬 강력한 모델이 우리 손안의 디바이스에서 직접 실행될 것이라는 전망을 자신 있게 내놓았다.
멀티모달과 다국어 역량 — 140개 언어와 시각·청각 이해
Gemma 4의 소형 모델들도 이미지, 동영상, 오디오에 걸친 멀티모달 이해 능력을 갖추고 있다. 음성 인식(Speech Recognition)은 물론, 한 언어로 말한 내용을 다른 언어의 텍스트로 직접 변환하는 음성-번역 기능(예: 스페인어 음성 → 프랑스어 텍스트)도 소형 모델에서 온디바이스로 처리 가능하다. 대형 모델인 31B는 이보다 훨씬 정밀한 멀티모달 이해를 제공하며, 이미지 내 특정 물체의 위치를 지정하는 포인팅(Pointing)이나 다중 객체 탐지(Object Detection) 같은 세밀한 시각 작업도 수행한다.
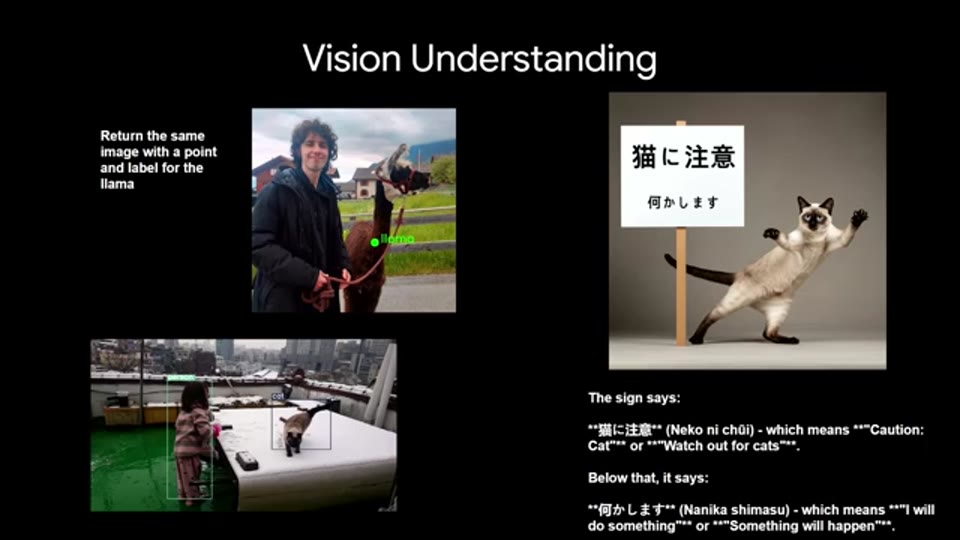
07:30 - 이미지 내 라마(동물) 위치 포인팅 및 객체 탐지 멀티모달 데모 화면
다국어 측면에서 Gemma 4는 140개 이상의 언어로 학습되었으며, Gemini 모델과 동일한 토크나이저(Tokenizer)를 사용한다. 이는 단순한 언어 커버리지 확장 이상의 의미를 가진다. Gemini에 투입된 방대한 다국어 연구 성과가 고스란히 Gemma에도 적용된 것이기 때문이다. 강연자가 특히 강조한 점은 저자원 언어(Low-Resource Language)에서의 실용성이었다. 페루의 케추아어(Quechua)나 인도의 공식 언어처럼 디지털 데이터가 부족한 언어라도, 해당 언어 데이터로 파인튜닝하면 토크나이저 설계 덕분에 기대 이상의 성능이 나온다는 것이다. 멀티모달과 다국어 역량이 결합되면 더욱 흥미로운 결과가 나온다. 일본어 텍스트가 포함된 이미지의 내용을 설명하는 데모가 이를 잘 보여주었다.
08:36 - 일본어 텍스트가 포함된 이미지를 설명하는 멀티모달+다국어 조합 데모
Apache 2.0 라이선스로의 전환 — 진정한 오픈소스로
이전 Gemma 버전들에 대한 커뮤니티의 주요 불만 중 하나는 라이선스 문제였다. 커스텀 라이선스는 상업적 활용이나 재배포에 제약을 두어, 기업과 연구자 모두에게 법적 불확실성을 안겨주었다. Gemma 4에서 Google은 이 문제를 정면으로 해결하여 Apache 2.0 라이선스를 채택했다. Apache 2.0은 수정, 재배포, 상업적 이용 모두를 폭넓게 허용하는 표준적인 오픈소스 라이선스로, 이 변경은 Gemma가 명실상부한 오픈소스 생태계의 일원으로 자리 잡게 해주는 중요한 전환점이다.
Gemmaverse — 10만 개 파생 모델과 5억 다운로드의 생태계
Gemma 4가 출시된 지 불과 일주일 만에 기반 모델 다운로드 수가 1,000만 건을 돌파했고, 커뮤니티가 만들어낸 파생 모델(양자화, 파인튜닝 버전 등)이 1,000개 이상 등장했다. Gemma 전체 패밀리의 누적 다운로드는 5억 건을 넘었으며, 파생 모델 수도 총 10만 개 이상이다. 이 숫자들은 단순한 다운로드 통계를 넘어, Gemma가 하나의 독립적인 생태계를 형성했음을 보여주는 지표다.
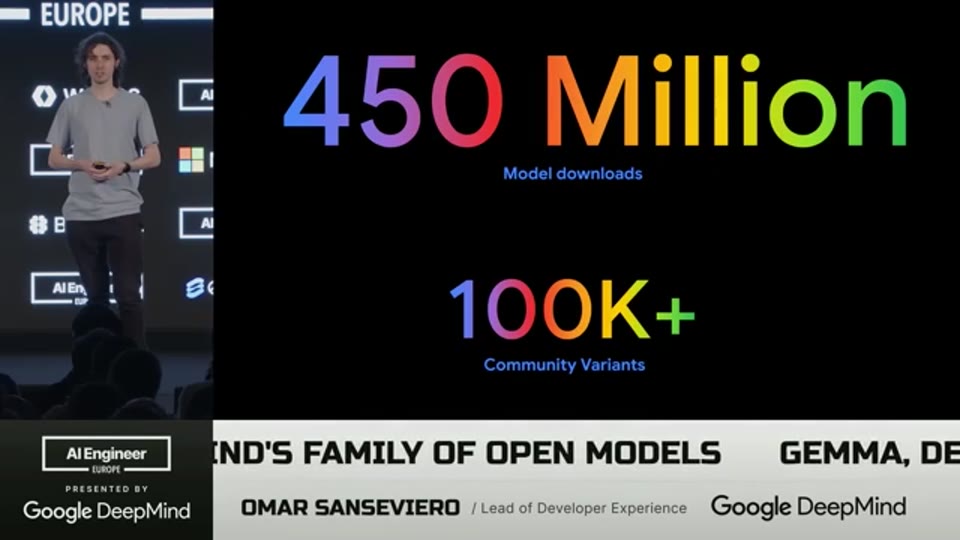
10:54 - Gemmaverse 통계 슬라이드 — 5억 다운로드, Gemma 4 파생 모델 1,000개 이상, 전체 Gemma 기반 모델 10만 개 현황
Google은 Gemma가 단순히 “사용되는 모델”이 아니라 “그 위에 무언가를 만드는 토대”가 되기를 원한다고 강조한다. 이러한 철학은 생태계 파트너십에 그대로 반영되어, 출시와 동시에 Unsloth, MLX, Ollama, Hugging Face, vLLM 등 주요 오픈소스 LLM 도구들과 긴밀하게 협력해 즉시 활용 가능한 상태로 만든다. 강연자는 “Hugging Face Transformers로 파인튜닝하는 사람이 Keras로 도구를 바꿀 필요가 없어야 한다”고 말하며, 커뮤니티가 있는 곳에서 Gemma를 만나도록 하는 것이 핵심 원칙이라고 밝혔다. 실제로 출시 직후 Hugging Face 인기 순위 상위권을 석권했으며, 개발자들이 저장소 전체를 Gemma로 감사(Audit)하거나 다양한 디바이스에 Gemma를 올리는 실험이 폭발적으로 이루어졌다. 누군가 Nintendo Switch에 llama.cpp를 올려 Gemma를 실행하는 시도도 있었다고 강연자는 소개했다.
제품 통합 측면에서는 Android Studio가 주목할 만한 사례다. Android Studio에는 코드 작성을 보조하는 에이전트 모드가 탑재되어 있는데, 이제 llama.cpp나 vLLM 기반의 오프라인 모드를 지원하여 클라우드 없이 Gemma가 Android 개발 코딩을 도와준다. Google은 Android 관련 데이터셋과 벤치마크를 Gemma 학습에 포함시켜 Android 개발 특화 성능도 끌어올렸다.
공식 변형 모델 — ShieldGemma와 MedGemma
Google은 Gemma를 기반으로 특수 목적의 공식 변형 모델을 직접 출시하기도 했다. ShieldGemma는 콘텐츠 안전성 분류를 위한 모델 패밀리로, 프로덕션 환경에서 사용자가 설정한 정책에 위배되는 유해 텍스트나 이미지를 필터링하는 독립적인 안전 레이어 역할을 한다. MedGemma는 의료 분야에 특화된 멀티모달 Gemma 3 기반 모델로, 방사선 이미지 판독이나 흉부 X-ray 이해 등 다양한 의료 작업을 지원한다. 두 모델 모두 오픈 모델로 공개되어 있어, 더욱 특수한 세부 분야에 맞게 추가 파인튜닝이 가능하다.
커뮤니티 차원의 특화 모델 사례도 인상적이다. 동남아시아 언어 지원을 목표로 하는 AI Singapore 그룹은 오픈 모델을 기반으로 멀티링구얼 연구를 지속적으로 진행하고 있다. 인도에서는 Sarvam 프로젝트를 중심으로 인도의 다양한 공식 언어를 위한 국가 AI 모델을 개발하는 소버린 AI(Sovereign AI) 시도가 정부 투자와 함께 이루어지고 있다. 강연자는 이러한 움직임들이 멀티링구얼 분야에서 매우 흥미로운 연구를 만들어내고 있다고 평가했다.
실제 과학 응용 — 암 치료 경로 제안으로 실험실 검증까지
강연자가 소개한 사례 중 가장 인상적인 것은 의과학 분야의 실제 응용이었다. 2024년 12월 Google DeepMind 연구진이 Gemma 3를 활용해 암 치료 경로(Cancer Therapy Pathways)를 제안하는 연구를 발표했는데, 이 모델이 제안한 경로들이 실제 실험실로 가져가 검증된 결과, 유효한 실험적 결과가 도출되었다. 이는 AI 모델이 단순한 대화 보조 도구나 역할극 파트너를 넘어, 실제 과학적 발견의 단서를 제공하는 수단으로 기능할 수 있음을 보여주는 사례다. 강연자는 이를 통해 오픈 모델이 금융, 법률 검토, 오프라인 에이전시, 의과학 등 다양한 실질적 분야에서 의미 있는 기여를 이미 하고 있음을 강조했다.
마무리 — 온디바이스 AI의 미래, 지금 시작되다
Omar Sanseviero는 강연을 마무리하며 청중에게 직접적인 도전을 던졌다. 앞으로 2주 안에 한 시간만 투자해 최신 오픈 모델을 직접 실행해보고 그 역량을 체감해보라는 것이다. 최고의 원초적 지능(Raw Intelligence)이 필요할 때는 Gemini나 다른 클라우드 API 모델을 선택하는 것이 맞지만, 온디바이스 시나리오에서도 이미 충분히 놀라운 일들이 가능하다는 사실을 직접 확인해보길 권장했다.
강연자의 전망은 명확하다. 1~2년 전과 지금을 비교했을 때 오픈 모델의 발전 속도는 이미 놀라운 수준이며, 6~12개월 후에는 사용자 맞춤형 데이터로 커스터마이징된 극도로 강력한 오픈 모델이 개인 디바이스에서 실행되는 세상이 올 것이라는 것이다. Gemma 4는 그 여정의 현재 이정표이자, 오픈 모델 생태계 전체가 나아가는 방향을 가리키고 있다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Gemma, DeepMind’s Family of Open Models — Omar Sanseviero, Google DeepMind |
| 채널 | AI Engineer |
| 강연자 | Omar Sanseviero, Google DeepMind |
| 리포트 작성 | 2026-04-21 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Sovereign Escape Velocity - Ownership with Open Models - Gus Martins and Ian Ballantyne, Google DeepMind
- API 비용을 0으로 만들어줄 역대급 On Device AI! Gemma 4!
- Build & deploy AI-powered apps — Paige Bailey, Google DeepMind
- Robotics — Cormac Brick, Google
- From 46% to 90% - Fine-Tuning Tiny LLMs for On-Device Agents - Cormac Brick, Google