AI 에이전트가 스스로 필요한 것을 말하게 하라
📺 원본 영상: Let AI Agents Tell You What They Need — Raj Navakoti, IKEA 🎙️ 채널: AI Engineer 📅 정리 일자: 2026-05-06 ⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
이 강연은 IKEA의 스태프 소프트웨어 엔지니어 Raj Navakoti가 AI 에이전트의 가장 근본적인 병목 지점—기관 지식(Institutional Knowledge)의 부재—을 해소하기 위해 고안한 ‘수요 주도 컨텍스트(Demand-Driven Context)’ 접근법을 소개한다. 강연자는 88%의 기업이 AI를 도입했음에도 단 6%만이 실질적인 가치를 창출하고 있다는 McKinsey 보고서를 인용하며, 그 핵심 원인이 에이전트의 역량 부족이 아닌 기업 내부 지식 베이스의 품질 문제에 있다고 주장한다. 이를 해결하기 위해 그는 지식을 에이전트에게 ‘밀어 넣는(Push)’ 전통적 접근 대신, 에이전트가 스스로 필요한 정보를 ‘끌어당기게(Pull)’ 만드는 방법론을 제시하며 Claude Code 기반 실제 데모를 통해 그 실효성을 검증해 보인다.
영화 〈메멘토〉가 설명하는 AI의 본질적 한계
강연자는 영화 〈메멘토(Memento)〉를 도입부에 인용하는 것으로 강연을 시작한다. 이 영화의 주인공은 고도로 유능한 인물이지만, 15분 이상 기억을 유지하지 못하는 치명적 약점을 가지고 있다. 그는 매 15분마다 수첩을 꺼내고 몸에 새긴 문신을 확인하면서 15분 전 자신이 무엇을 하고 있었는지를 재구성하는 과정을 끝없이 반복한다. 강연자에 따르면, 이 장면이 현재 AI 에이전트의 처지를 정확히 묘사한다고 한다. 에이전트는 추론(Reasoning), 연산(Computation), 코드 생성(Code Generation) 등 거의 모든 벤치마크에서 인간을 상회하는 성능을 보이지만, ‘기관 지식(Institutional Knowledge)‘이라는 단 하나의 결핍이 그 모든 역량을 무력화시킨다.
이 비유는 단순한 수사적 장치가 아니라 문제의 본질을 정확히 짚는다. AI는 범용 지식으로 훈련되어 있기 때문에, 특정 기업이 수년간 축적해 온 내부 도메인 지식—어떤 팀이 어떤 서비스를 운영하고, 어떤 API가 어떤 비즈니스 프로세스와 연결되며, 어떤 인시던트가 어떤 이유로 반복적으로 발생하는지—은 전혀 알지 못한다. 따라서 AI 에이전트에게 업무를 맡길 때 발생하는 실패는 에이전트의 무능이 아니라, 기억을 잃은 메멘토의 주인공처럼 컨텍스트가 없는 상태에서 작업을 수행해야 하는 구조적 문제에서 기인한다. 강연자는 이 영화 한 편이 AI 에이전트와 MCP에 대해 알아야 할 모든 것을 담고 있다고 말할 정도로, 이 비유를 중심축으로 강연 전체를 구성한다.
엔터프라이즈 AI의 역설: 88%가 도입했지만 6%만 가치를 창출
강연자는 현장의 현실을 냉철하게 짚는다. 많은 기업들이 “3분이면 풀스택 앱이 완성된다”, “코드 리뷰를 AI가 한다”, “인시던트 관리도 자동화된다”고 이야기하지만, 정작 JIRA 대시보드의 에픽(Epic)은 좀처럼 이동하지 않는다는 것이다. McKinsey 보고서에 따르면, 전체 기업의 88%가 AI를 사용하고 있으나 실제로 가치를 창출하고 있는 비율은 고작 6%에 불과하다. 강연자는 이 격차가 LLM 모델의 품질 문제도 아니고, 에이전트 프레임워크의 완성도 문제도 아니라고 주장한다. 문제는 그 사이에 있는 ‘컨텍스트’의 품질이다.
강연자는 JIRA 티켓을 색깔로 분류하는 비유를 사용해 이를 설명한다.
💡 [영상 참조] 강연자는 이 시점에서 초록·주황·빨간색으로 분류된 JIRA 티켓 예시를 화면에 표시합니다. 📺 원본 영상을 확인하세요.
초록색(Green) 작업은 LLM이 이미 학습된 범용 지식으로 처리할 수 있는 태스크다. 주황색(Orange) 작업은 별도의 스킬(Skill)이나 에이전트 익스텐션을 통해 가르칠 수 있는 태스크다. 그러나 빨간색(Red) 작업은 오직 기업 내부에, 혹은 직원들의 머릿속에만 존재하는 기관 지식에 의존하는 태스크로, 에이전트가 가장 고전하는 영역이다. 에이전트는 초록색과 주황색 작업은 능숙하게 처리하지만, 빨간색 작업 앞에서는 계속해서 실패한다. 강연자 스스로도 이 문제를 해결하려 수십 개의 MCP 서버를 구축해 봤지만, 결국 자신이 에이전트를 위해 데이터를 입력하는 ‘데이터 입력 담당자’가 되어버렸다고 고백한다. 에이전트를 위해 더 많은 노력을 쏟을수록, 오히려 자신이 더 많은 일을 하게 되는 역설에 빠진 것이다.
기관 지식 모놀리스의 해부학
강연자는 일반적인 기업의 기관 지식 구조를 파이 차트로 시각화하여 설명한다.
💡 [영상 참조] 강연자는 이 시점에서 기관 지식의 구성 비율을 나타낸 파이 차트를 화면에 표시합니다. 📺 원본 영상을 확인하세요.
음성으로 설명된 내용에 따르면, 약 20%는 이미 오래되어 신뢰하기 어려운 ‘구식(Outdated)’ 문서이며, 또 다른 20%는 여러 이유로 ‘신뢰할 수 없는(Unreliable)’ 정보다. 10%는 서로 다른 곳에 ‘중복(Duplicated)‘된 내용이고, 가장 심각한 40%는 ‘부족 지식(Tribal Knowledge)‘으로, 아예 문서화가 된 적이 없으며 사람들의 머릿속에만 존재한다. 이 상황에서 MCP 서버를 100개 구축해 에이전트에 연결한다 해도 근본적인 문제는 해결되지 않는다.
강연자는 이를 레거시 모놀리스 시스템의 문제에 정확히 비유한다. 마이크로서비스 전환 없이 모놀리스 위에 API를 아무리 쌓아봐야 근본적인 아키텍처 문제는 남아 있는 것처럼, 기관 지식이라는 ‘지식 모놀리스(Knowledge Monolith)‘를 에이전트가 활용할 수 있는 ‘컨텍스트 블록(Context Block)’ 단위로 분해하지 않는 한, 어떤 리트리벌 레이어(Retrieval Layer)도 만족스러운 결과를 내지 못한다. 분명 RAG(Retrieval-Augmented Generation)를 잘 구축하면 최대 40%의 사실 정확도를 개선할 수 있다는 산업계의 주장도 있지만, 그것은 문서화된 지식 베이스를 전제로 한다. 40%가 애초에 문서 어디에도 없다면 아무리 정교한 리트리벌도 그것을 찾아낼 수 없다.
수요 주도 컨텍스트(Demand-Driven Context) 접근법의 철학
강연자가 제안하는 해법은 ‘수요 주도 컨텍스트(Demand-Driven Context)‘라는 접근법이다. 이 방법론의 핵심은 지식을 에이전트에게 미리 ‘밀어 넣는(Push)’ 전략을 버리고, 에이전트가 작업을 수행하면서 스스로 필요한 지식을 ‘끌어당기게(Pull)’ 만드는 것이다. 개념적으로는 레거시 모놀리스를 마이크로서비스로 전환하는 것, 혹은 워터폴(Waterfall) 방법론을 애자일(Agile)로 바꾸는 것과 동일한 패러다임 전환이다.
강연자는 이를 신입 직원의 온보딩(Onboarding) 과정에 비유한다. 신입 직원에게 모든 회사 지식을 마스터하게 한 뒤에야 업무를 맡기는 조직은 없다. 대신, 처음 이틀 정도의 오리엔테이션과 함께 Confluence 링크, GitHub 레포지토리, 관련 문서들을 건네주고 바로 업무를 할당한다. 신입 직원은 업무를 수행하면서 스스로 질문하고 정보를 찾아가며 점차 기관 지식을 내재화한다. 그 과정에서 좋은 직원은 자신이 발견한 내용을 문서로 남기기도 한다. 수요 주도 컨텍스트는 이 과정을 에이전트에게 그대로 적용한다.
이 접근법은 TDD(Test-Driven Development, 테스트 주도 개발)와도 유사한 구조를 가진다. TDD에서는 먼저 실패할 테스트 케이스를 작성하고, 그 테스트를 통과시키기 위한 최소한의 코드를 작성하면서 제품을 완성해 나간다. 마찬가지로 수요 주도 컨텍스트에서는 에이전트가 반드시 실패할 것으로 예상되는 문제를 먼저 던져준다. 에이전트는 그 문제를 해결하려 시도하면서 무엇이 부족한지를 스스로 파악하고, 인간 도메인 전문가가 그 공백을 채워준다. 이 과정을 반복하면서 에이전트는 점차 반자율적으로(Semi-Autonomously) 업무를 처리할 수 있게 된다.
하나의 사이클이 작동하는 방식
이 접근법의 핵심 사이클은 단계적으로 순환한다. 먼저, 에이전트에게 작업 항목(Work Item)을 할당한다. 에이전트는 기존 지식 베이스를 탐색하지만, 결국 부족한 정보를 발견하고 실패를 선언한다. 그 시점에서 에이전트는 단순히 “모르겠다”고 답하는 것이 아니라, “이 태스크를 완료하기 위해 필요한 정보의 체크리스트”를 생성한다. 이것이 이 접근법의 가장 강력한 부분이다—에이전트가 자신에게 무엇이 없는지를 능동적으로 표면화(Surface)하기 때문이다. 이를 통해 그동안 아무도 명시적으로 몰랐던 ‘문서화 공백(Documentation Gap)‘이 구체적인 항목으로 처음 드러난다.
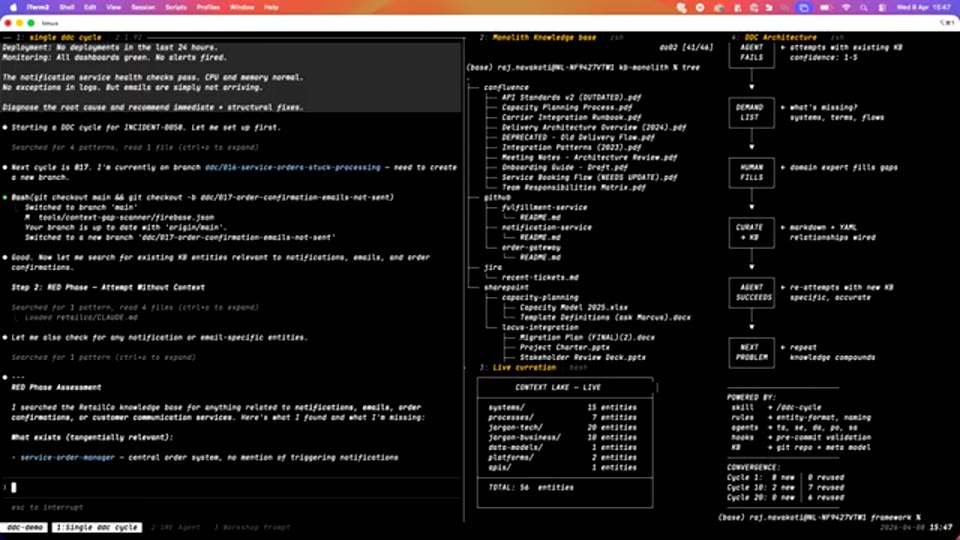
20:07 - 에이전트가 인시던트 분석 후 생성한 신뢰도 점수(1~5 스케일)와 이해 불가 용어/비즈니스 로직 목록 - 문서화되지 않은 항목들이 표면화된 결과 화면
인간 도메인 전문가는 그 체크리스트를 바탕으로 필요한 정보를 제공한다. 에이전트는 제공된 정보로 문제를 해결하고, 동시에 그 새로운 지식을 정제된 형태로 지식 베이스에 저장한다. 이렇게 쌓인 지식은 이후 동일한 에이전트뿐만 아니라 다른 에이전트도 재사용할 수 있다. 강연자가 직접 시연한 결과, 기존에 56개의 엔티티(Entity)로 구성된 지식 베이스에서 단 하나의 인시던트 문제를 해결하는 과정 중 새로운 6개의 엔티티가 발견되고, 이후 추가로 5~6개의 새로운 엔티티가 연쇄적으로 발굴 및 문서화되었다.
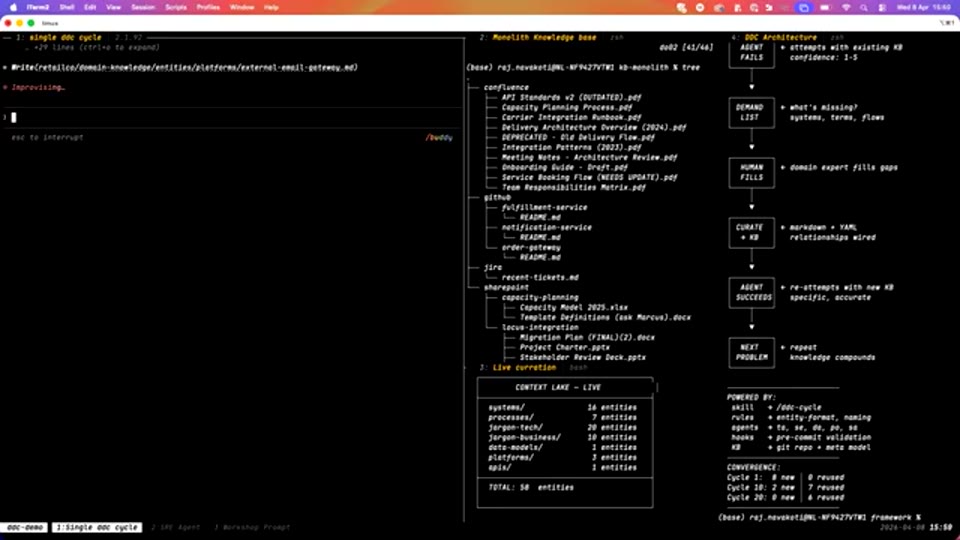
22:35 - 에이전트가 전문가 제공 정보를 바탕으로 지식 베이스에 새 엔티티를 실시간으로 추가하는 장면 - 56개 기존 엔티티에서 새 엔티티가 생성되는 과정
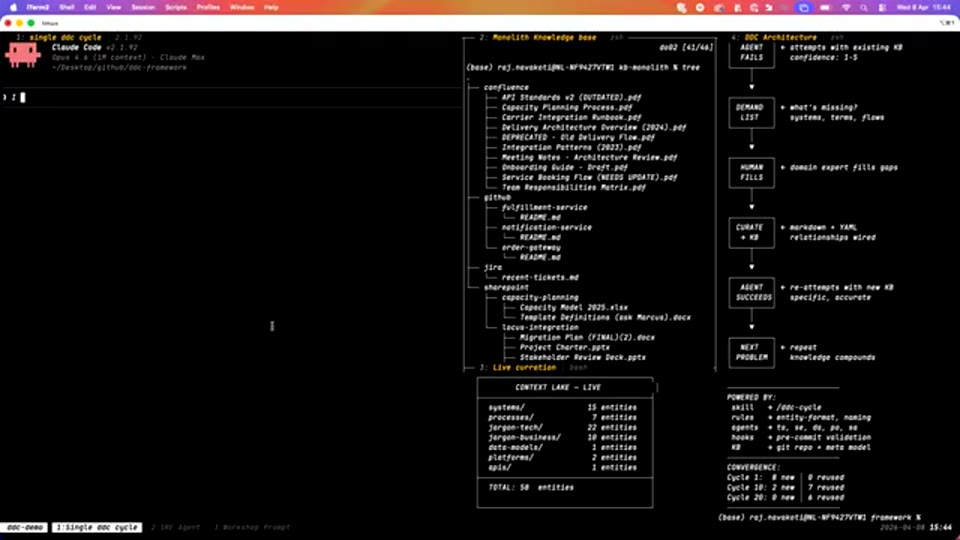
17:11 - 터미널 기반 데모 전체 화면 - 좌측 패널: 에이전트 내부 작동 원리, 중간 상단: 모놀리스 지식 베이스(Confluence/Slack/GitHub 대체 플랫 파일), 중간 하단: 실시간으로 업데이트되는 새 컨텍스트 블록
이 데모는 Claude Code의 스킬(Skills), 규칙(Rules), 에이전트(Agents), 훅(Hooks) 조합으로 구현되었다. 강연자는 직장에서는 GitHub Copilot을 사용하여 동일한 접근법을 구현하고 있다고 밝혔으며, 이 접근법이 특정 에이전트 도구에 종속되지 않는다는 점을 강조했다.
14사이클의 효과: 신뢰도 1.5에서 4.4로
단일 사이클의 효과를 보여준 뒤, 강연자는 14번의 인시던트에 걸쳐 이 사이클을 반복했을 때의 결과를 제시한다.
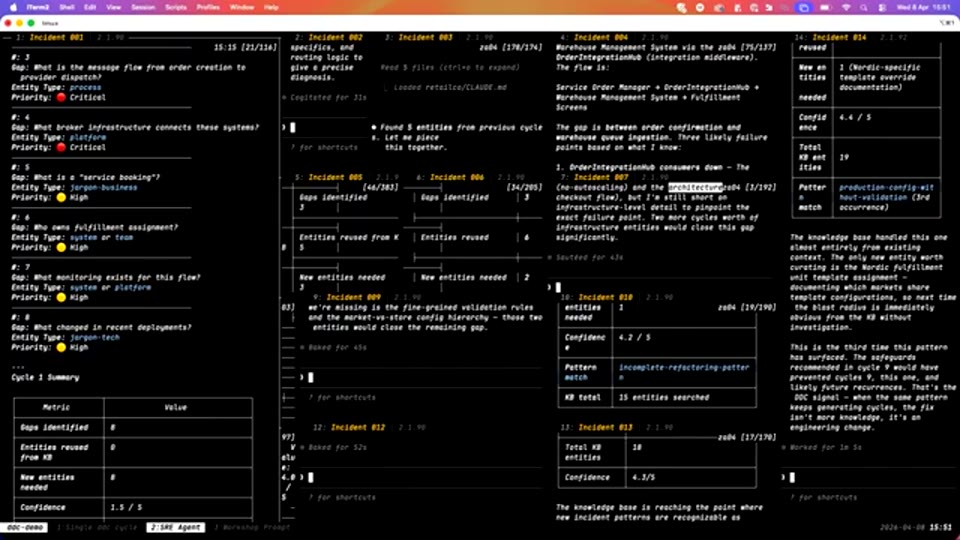
24:05 - 14개 인시던트 반복 사이클 결과 멀티-윈도우 화면 - 첫 인시던트 신뢰도 1.5(전 항목 Critical)에서 14번째 인시던트 후 신뢰도 4.4로 개선된 비교 데이터
강연자에 따르면, 첫 번째 인시던트에서 지식 베이스의 신뢰도 점수(Confidence Score)는 1.5에 불과했으며 거의 모든 항목이 ‘Critical’ 또는 ‘High’ 우선순위의 공백 상태였다. 즉, 아무것도 문서화되어 있지 않은 것이나 마찬가지였다. 그러나 각 인시던트마다 에이전트가 공백을 발견하고, 전문가가 정보를 제공하며, 에이전트가 그 정보를 문서화하는 과정을 14번 반복하자 신뢰도 점수는 4.4까지 상승했다. 이것이 수요 주도 컨텍스트의 핵심 가치 제안이다—에이전트를 단순한 지식 소비자(Consumer)가 아니라 지식 관리자(Knowledge Manager)로 전환시키는 것. 기존 방식에서는 인간이 모든 컨텍스트 문제를 해결한 뒤에 에이전트에게 넘겼다면, 이 접근법에서는 지식 관리 자체를 에이전트의 업무 영역으로 포함시킨다.
자동화: 컨텍스트 갭 스캐너(Context Gap Scanner)
물론 14번의 사이클을 수동으로 수행하는 것도 상당한 인내를 요구하는 작업이다. 강연자 스스로도 15회 이상의 수동 사이클은 매우 고통스럽다고 인정한다. 이 문제를 해결하기 위해 강연자는 과정을 완전히 자동화하는 ‘컨텍스트 갭 스캐너(Context Gap Scanner)‘를 개발했다.
이 도구의 작동 방식은 다음과 같다. 조직에는 이미 수년치의 JIRA 티켓, 인시던트 기록, 고객 지원 티켓 등 방대한 과거 작업 항목이 아카이브로 존재한다. 스캐너는 이 항목들을 일괄로 가져와 기관 지식 베이스에 대해 자동으로 검증을 실행한다.
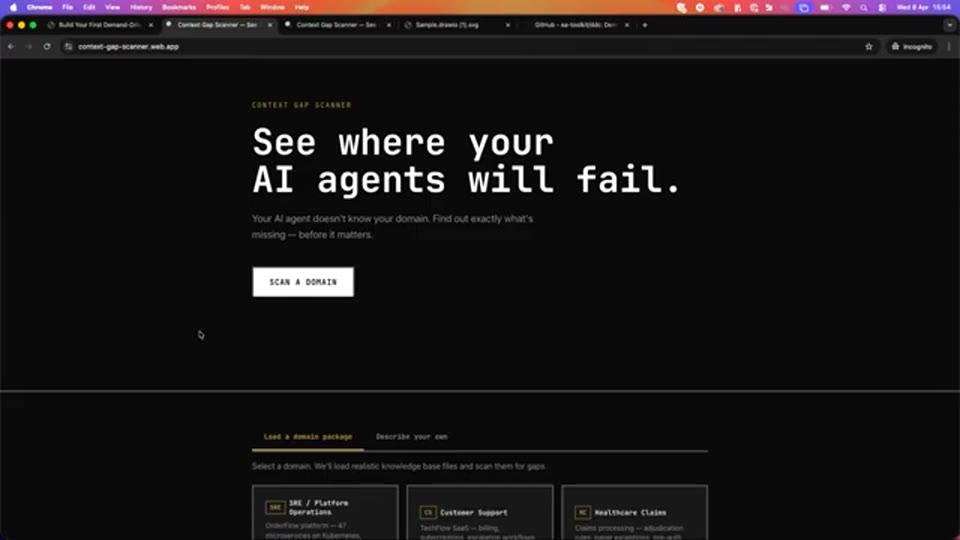
27:07 - 컨텍스트 갭 스캐너 자동화 데모 - 20개 과거 인시던트를 일괄 처리하여 프로브 생성·검증·갭 분석 3단계를 자동 실행하는 과정
구체적으로, 스캐너는 세 단계를 거친다. 첫째, 각 인시던트에 대해 지식 베이스를 테스트하는 ‘프로브(Probe)‘를 생성한다. 둘째, 그 프로브를 실행하여 지식 베이스를 검증한다. 셋째, 무엇이 부족한지를 분석하고 우선순위를 분류한다. 이 분석의 결과물은 Kanban 보드 형태로 시각화된다. 각 공백 항목은 ‘Critical’, ‘High’, ‘Medium’ 우선순위로 분류되며, 이를 통해 팀이 어떤 기관 지식부터 문서화해야 할지 명확한 로드맵을 얻을 수 있다.
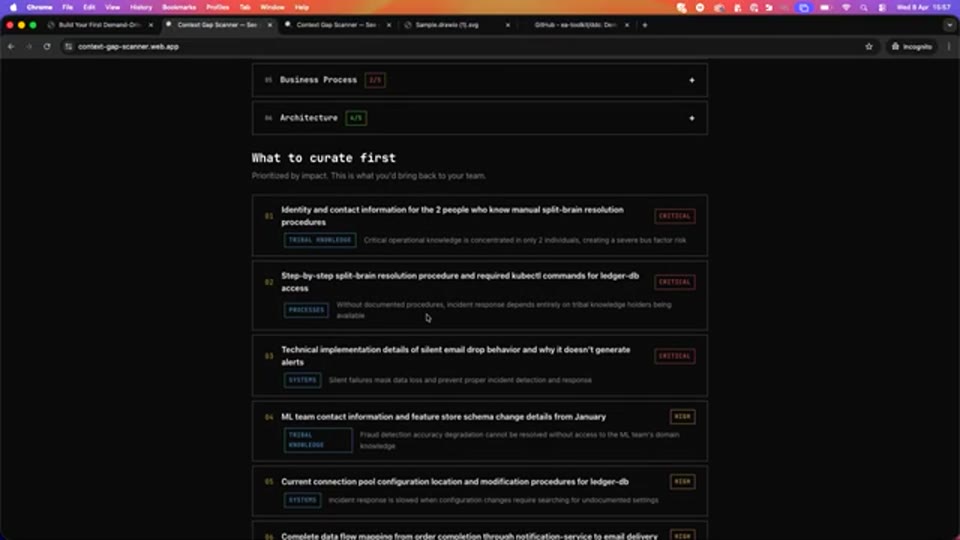
30:22 - 갭 분석 최종 결과 화면 - Critical/High/Medium으로 분류된 미문서화 항목 목록, 부족 지식 유형 분류(Tribal Knowledge, 시스템 정보, 비즈니스 프로세스 등)
예를 들어, 알림 서비스(Notification Service)가 20개의 인시던트 중 반복적으로 등장한다면, 해당 서비스의 문서화가 가장 시급한 과제임을 즉각적으로 파악할 수 있다. 강연자는 이 과정을 통해 단순히 “문서가 부족하다”는 막연한 인식을 넘어, “정확히 무엇이 문서화되어 있지 않으며, 그것이 얼마나 중요한가”를 데이터로 보여줄 수 있다고 강조한다. 전통적인 방식에서는 누군가가 Miro 보드에 “이 부분 문서화 필요”라고 티켓을 직접 써야 했다면, 이제 그 작업을 스캐너가 자동으로, 그리고 우선순위와 함께 생성해 준다.
지식 저장소 설계: GitHub와 메타 모델
강연자는 정제된 컨텍스트 블록을 어디에 저장할 것인지에 대해서도 명확한 견해를 제시한다. 그는 GitHub 레포지토리를 강력히 권장한다. 그 이유는 실용적이다—GitHub는 이미 PR(Pull Request) 프로세스, 코드 리뷰, 접근 권한 관리 등의 인프라를 갖추고 있기 때문이다. 여러 도메인 전문가들이 동시에 지식 베이스에 기여하거나 에이전트가 자동으로 문서를 업데이트할 때 발생하는 충돌과 병합 문제를 GitHub의 기존 워크플로우로 자연스럽게 해결할 수 있다. 또한 GitHub에 저장하면 나중에 Confluence 등 다른 솔루션으로 퍼블리시하는 것도 자유롭다. 강연자는 언젠가 이 문제를 위한 2천만 달러 시드 투자를 받은 SaaS 솔루션이 등장하겠지만, 그 전까지는 GitHub가 가장 현실적인 선택이라고 본다.
메타 모델(Meta Model)에 대해서도 별도로 언급한다. 메타 모델이란 기업의 도메인이 어떻게 구조화되어 있는지—비즈니스 프로세스와 시스템이 어떻게 연결되고, 기술 용어와 비즈니스 용어가 어떻게 매핑되는지—를 정의하는 관계 지도다.
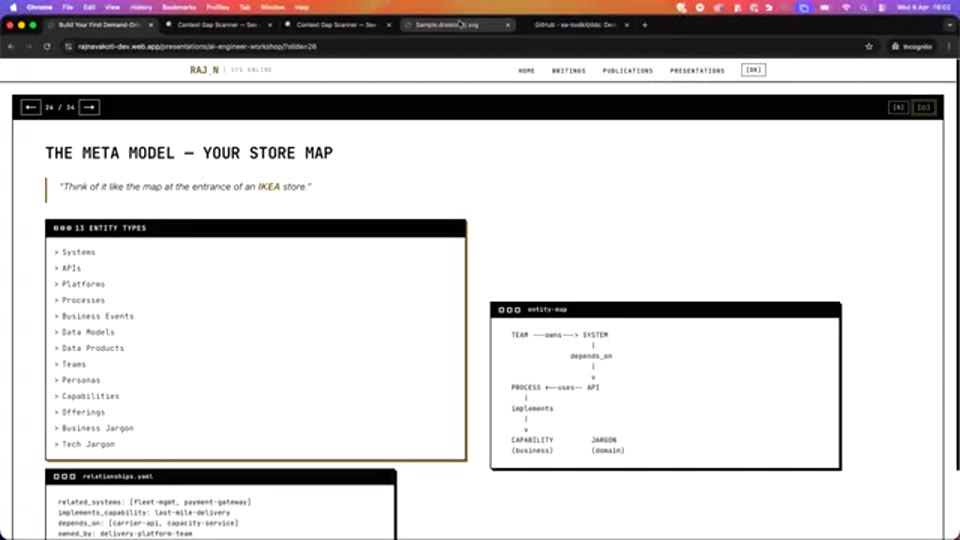
34:57 - 메타 모델 구조 다이어그램 - 비즈니스 프로세스·시스템·API·기술/비즈니스 용어 간의 관계를 시각화한 도메인 지식 지도
메타 모델은 이 접근법의 필수 요소는 아니지만 강력한 보완재가 된다. 현재 에이전트에게는 기관 지식 베이스를 탐색할 ‘지도(Map)‘가 없다. 수백 개의 파일 중 어디서부터 무엇을 찾아야 할지 모른 채 작업을 수행하는 것이다. 메타 모델이 있으면, “이 시스템을 수정하면 어떤 비즈니스 프로세스에 영향을 주고 어떤 API를 변경해야 하는가”라는 복잡한 연쇄 효과를 에이전트가 스스로 파악할 수 있게 된다. 파일 구조 자체가 메타 모델의 표현이 되어, 에이전트가 지식 베이스를 보다 효율적으로 탐색할 수 있게 되는 것이다.
논문 발표와 컨텍스트 윈도우의 관계
강연자는 이 접근법이 단순한 아이디어 수준을 넘어, 실제 데이터셋으로 검증하고 학술 논문으로 발표했음을 언급한다. 2025년 3월, 그는 arXiv에 ‘Demand-Driven Context’라는 제목의 프리프린트(Preprint)를 공개했으며, 관심 있는 청중에게 워크샵 이후 링크를 공유하겠다고 밝혔다. 논문에서 강연자는 ACE 등 유사한 선행 연구와의 차이점도 비교한다. ACE와 유사한 연구들이 AI와의 대화 과정에서 생성되는 ‘운영적 컨텍스트(Operational Context)‘의 개선에 집중하는 반면, 수요 주도 컨텍스트는 기업의 문서화된 도메인 지식 자체의 품질 향상에 초점을 맞춘다는 점에서 차별화된다.
청중 질의에서 Claude Code의 1백만 토큰 컨텍스트 윈도우 확장이 이 접근법에 미치는 영향에 대한 질문이 나왔다. 강연자는 여러 도메인의 지식을 실험해 본 결과, 도메인당 평균 약 96,000 토큰 수준의 지식이 필요했다고 답했다. 이는 현재의 대용량 컨텍스트 윈도우 안에 전체 지식 베이스를 직접 포함시키는 것이 가능함을 의미하며, 오히려 그 방법이 RAG보다 더 나은 결과를 내는 경우도 많다고 강조했다. 다만, 컨텍스트가 1백만 토큰에 근접할 정도로 방대해진다면 그때는 더 정교한 리트리벌 메커니즘을 고려해야 한다고 덧붙였다. 또한 코드 레포지토리와 Confluence를 동시에 지식 소스로 활용하면 에이전트가 두 소스 간의 충돌 상황에 직면하는 문제를 경험했다고 솔직히 인정했다. 이를 해결하기 위해서는 소스 오브 트루스(Source of Truth) 우선순위 규칙을 별도의 스킬로 정의해야 한다.
접근법의 실질적 가치와 현실적 한계
강연자가 직접 사용하거나 공유한 사람들에게서 확인한 가치는 크게 두 가지로 요약된다. 첫 번째는 ‘알려지지 않은 것을 발견하는 것(Knowing the Unknown)‘이다. 무엇이 문서화되어 있지 않은지는 이 접근법을 통해서만 표면화될 수 있다. 기존 방식에서는 누군가가 “이 문서가 없어요”라고 직접 말해주기 전까지는 무엇이 빠져 있는지조차 파악하기 어렵다. 하지만 수요 주도 컨텍스트에서는 에이전트가 작업을 시도하면서 스스로 공백을 발견하고 구체적으로 무엇이 필요한지를 보고하기 때문에, 문서화 공백의 우선순위 지도를 자동으로 획득할 수 있다.
두 번째 가치는 지식 관리를 에이전트에게 위임하는 것이다. 강연자는 더 이상 자신이 에이전트를 위한 ‘지식 관리자’ 역할을 하고 싶지 않다고 말한다. 에이전트가 스스로 필요한 지식을 발견하고, 제공받은 정보를 정제하여 저장하며, 이를 미래의 작업에 재활용한다면, 인간은 지식을 관리하는 노력 대신 더 높은 가치의 업무에 집중할 수 있다는 것이 그의 비전이다.
그러나 강연자는 한계에 대해서도 솔직하게 이야기한다. 이미 문서화 수준이 높은 소규모 팀에게는 이 접근법의 필요성이 크지 않을 수 있다. 반대로, 방대한 엔터프라이즈 환경에서 단번에 전사적 규모로 적용하려는 시도는 실패할 가능성이 높다. 강연자의 조언은 가능한 한 작은 범위—하나의 팀, 그 팀의 JIRA 티켓과 인시던트, 그 팀의 Confluence 페이지—에서 시작하여 점진적으로 확장하는 것이다. 또한, 조직 문화적으로 작업 항목에 충분한 상세 내용이 기록되지 않는 경우, 스캐너의 전제 자체가 무너질 수 있다는 청중의 지적도 강연자가 솔직히 인정했다. 이 접근법 자체가 아직 초기 단계임을 인정하며, 강연자는 “AI의 시대에는 어떤 접근법이나 앱이 얼마나 오래 살아남을지 아무도 모른다”고 겸손하게 마무리했다.
마무리: 컨텍스트가 다음 전쟁터다
강연자는 현재 업계의 집단적 관심이 LLM 모델 품질, 에이전트 프레임워크 하네스(Harness), 그리고 9억 달러 규모의 리트리벌 시장에 집중되어 있다고 진단한다. 그러나 아무도 개별 기업의 지식 베이스 자체를 고쳐주러 오지 않는다. LLM 벤더도, 에이전트 프레임워크 팀도, 리트리벌 솔루션 회사도 “당신 회사 Confluence의 40%가 부족 지식이어서 에이전트가 제대로 작동하지 않는다”는 문제를 해결해주지 않는다. 그것은 오롯이 기업 스스로가 해결해야 할 과제다.
강연자는 에이전트가 점차 반자율적이 되어가는 미래에서 우리의 역할이 ‘에이전트 관리자(Agent Manager)‘로 변화할 것이라고 전망한다. 그 전환이 매끄럽게 이루어지려면, 에이전트가 신뢰하고 활용할 수 있는 고품질 기관 지식 베이스가 먼저 갖춰져야 한다. 수요 주도 컨텍스트는 그 준비를 위한 하나의 실용적 접근법으로, 강연자는 GitHub 레포지토리, 컨텍스트 갭 스캐너, 그리고 단일 프롬프트로 시작할 수 있는 간단한 방법을 공유하며 청중이 직접 실험해볼 것을 권장했다. 코딩 에이전트의 역량이 놀라운 속도로 발전하는 지금, 강연자는 “첫 번째 AGI는 코딩 에이전트가 될 것”이라고 전망하면서도, 그 코딩 에이전트가 진정한 가치를 발휘하기 위해 남은 과제는 기술이 아닌 지식이라고 강조한다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | Let AI Agents Tell You What They Need — Raj Navakoti, IKEA |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-05-06 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.