The Base Model Is Dead — Varun Singh, Arcee AI
📺 원본 영상: The Base Model Is Dead — Varun Singh, Arcee AI
🎙️ 채널: AI Engineer
📅 정리 일자: 2026-08-01
⚠️ Note: 본 리포트는 영상의 음성을 텍스트로 변환(STT)하여 정리한 것입니다. 화면에 표시된 자료(차트, 코드, 슬라이드 등)는 포함되지 않을 수 있습니다.
개요
Varun Singh은 이 강연에서 “base model”이라는 개념이 더 이상 과거와 같은 의미로 작동하지 않는다고 주장한다. 과거의 base model은 대규모 웹 텍스트를 통해 인간 인터넷의 지식을 압축한 모델에 가까웠지만, reasoning model과 agentic model이 부상하면서 이제 base model은 강화학습(Reinforcement Learning, RL)을 잘 수행하기 위한 사전 조건, 즉 prior를 만드는 단계로 재정의되고 있다. 강연의 핵심은 pre-training이 사라졌다는 뜻이 아니라, pre-training의 목표와 데이터 구성이 바뀌고 있다는 점이다.
웹 지식 저장소로서의 Base Model
초기 대형 언어 모델에서 base model은 거의 “인터넷 전체를 읽은 모델”에 가까운 이미지로 이해되었다. 강연자에 따르면 GPT-3 시기의 학습 데이터는 Common Crawl, WebText2, 책, Wikipedia처럼 인간이 생산한 웹 텍스트와 고품질 문서에 크게 의존했다. 이때 pre-training은 next-token prediction을 통해 세계 지식과 언어적 표현을 축적하는 핵심 단계였고, post-training은 그 지식을 채팅 인터페이스에서 잘 드러나도록 다듬는 과정에 가까웠다.
이 구조에서는 base model의 품질이 곧 최종 모델의 상한선을 결정했다. pre-training이 전체 compute budget의 대부분을 차지했고, RL은 모델의 지식이나 능력을 새로 부여한다기보다 응답의 성향과 사용성을 조정하는 “마지막 장식”에 가까웠다. 다시 말해 모델이 무엇을 아는지는 pre-training에서 결정되고, 모델이 그것을 어떤 말투와 형식으로 꺼내는지는 post-training에서 결정되는 식이었다.
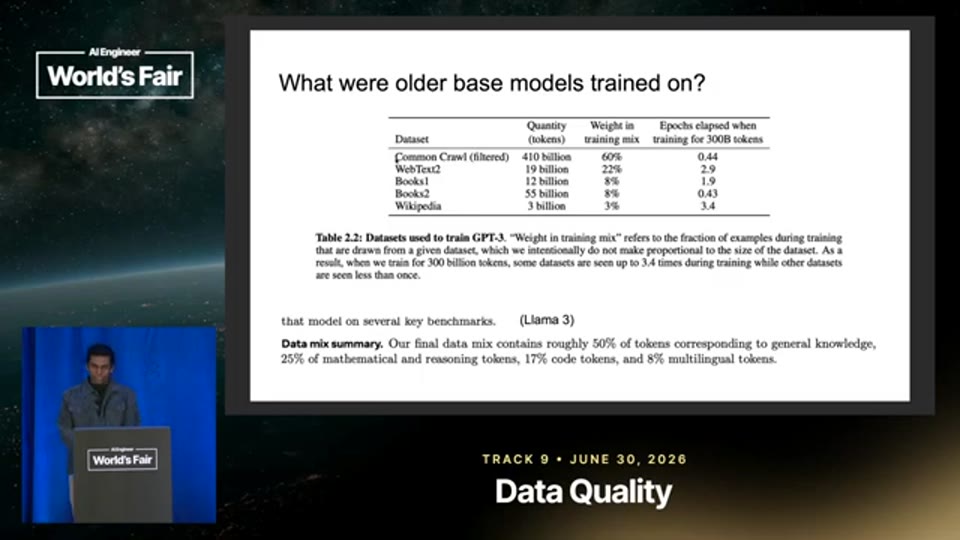
02:29 - GPT-3와 Llama 3의 학습 데이터 구성에서 web text 비중을 비교하는 화면
O1과 R1 이후, RL은 장식이 아니라 중심이 되었다
강연자는 2024년 OpenAI의 o1, 2025년 1월 DeepSeek R1을 전환점으로 제시한다. 이 시기부터 RL은 단순히 답변 스타일을 다듬는 기술이 아니라, 수학·코딩·도구 사용 같은 특정 과제에서 모델 성능을 크게 끌어올리는 핵심 학습 방식으로 부상했다. 특히 reasoning model은 정답을 바로 출력하는 모델이 아니라, 문제를 단계적으로 탐색하고 검증하는 행동 자체를 학습해야 하기 때문에 RL의 역할이 과거보다 훨씬 커질 수밖에 없다.
이 변화는 agentic coding 환경에서도 뚜렷하게 나타난다. 강연자는 Claude Code와 같은 도구를 언급하며, 모델이 터미널이나 소프트웨어 환경과 상호작용하면서 실제 애플리케이션을 만들고 수정하는 흐름을 설명한다. 이런 환경에서는 모델이 단순히 코드를 “알고 있는지”보다, 도구를 호출하고 결과를 관찰하며 다음 행동을 선택하는 능력이 중요해진다. 따라서 질문은 자연스럽게 바뀐다. 과연 전통적인 웹 텍스트 중심 base model이 이런 대규모 RL 단계에 가장 좋은 출발점인가?
Pre-training 데이터의 무게중심 이동
강연자가 제시하는 중요한 변화는 web text의 비중 감소다. GPT-3에서는 Wikipedia를 포함한 웹 텍스트가 학습 mix의 약 85%를 차지했지만, 최근 모델에서는 이 비중이 크게 줄어드는 추세라고 설명한다. STT 기준으로 MAI Thinking 1로 언급된 사례에서는 web text가 약 15% 수준까지 내려갔다고 하며, 이는 일반 웹 지식이 여전히 중요하지만 더 이상 학습 데이터의 절대 중심은 아니라는 신호로 읽힌다.
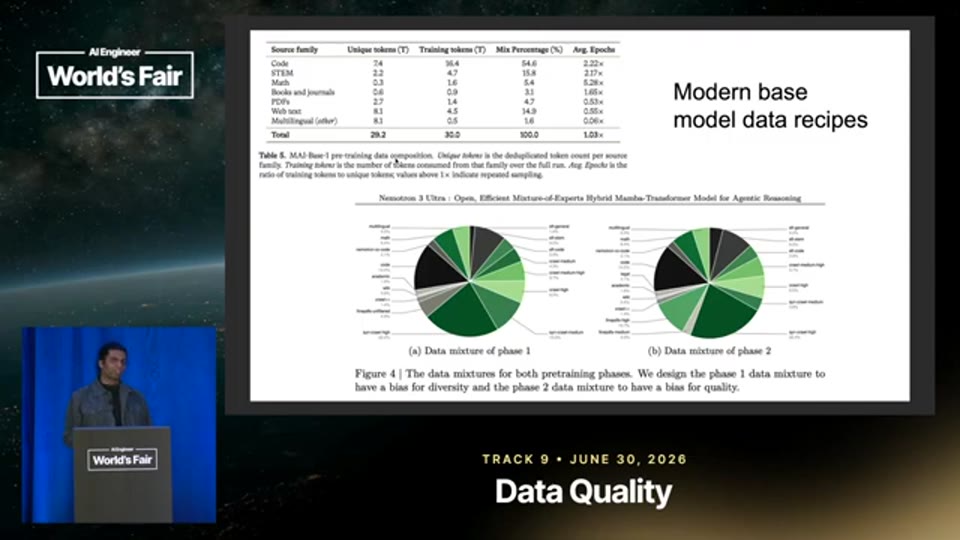
06:56 - MAI Thinking 1의 데이터 mix를 예로 들며 web text 비중 감소를 설명하는 화면
그 빈자리를 채우는 것은 code, STEM 데이터, SFT(Supervised Fine-Tuning) 형식의 질의응답 데이터, 그리고 synthetic data다. 과거 GPT-3식 모델에서는 명시적인 code dataset이 핵심 구성요소가 아니었지만, 오늘날의 모델 학습 recipe에서는 code가 지배적인 데이터 subset으로 올라섰다고 강연자는 말한다. 이는 모델이 단순한 대화 상대가 아니라 reasoning, coding, tool use, agentic workflow를 수행하는 시스템으로 쓰이기 시작했기 때문이다.
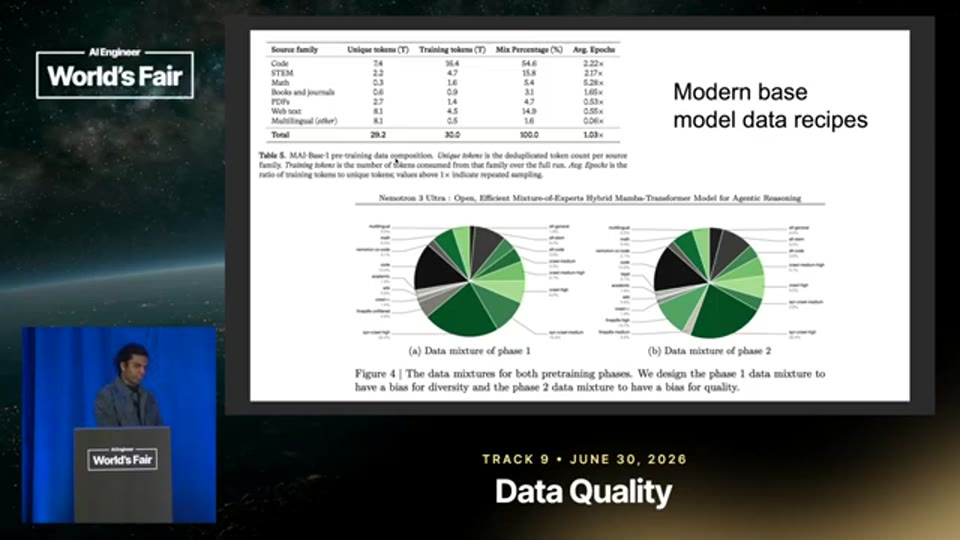
08:12 - Nemotron 계열 데이터 recipe에서 SFT 형식 데이터가 pre-training에 포함되는 구조를 설명하는 화면
Synthetic Data는 왜 다시 Pre-training으로 들어오는가
Synthetic data에 대해서는 흔히 모델 붕괴(model collapse)를 유발할 수 있다는 우려가 따라붙는다. 그러나 강연자는 synthetic data를 무작정 투입하는 방식이 아니라, seed data를 재표현하거나 더 깨끗하고 과제 지향적인 token으로 바꾸는 방식으로 사용하면 pre-training 단계에서도 의미 있는 효과를 낼 수 있다고 설명한다. Arcee AI의 자체 모델인 Trinity Large에서도 web-scale synthetic data를 사용했으며, 주된 방식은 같은 정보를 여러 표현으로 바꾸어 모델이 동일한 지식을 다양한 형태로 접하도록 하는 rephrasing이었다.
이 접근의 핵심은 token 수를 단순히 늘리는 것이 아니라 token의 모양을 바꾸는 데 있다. 모델이 나중에 post-training이나 RL에서 만나게 될 instruct 형식, question-answer 형식, agentic task 형식을 pre-training 초반부터 접하면, 모델은 downstream task의 구조를 더 일찍 학습할 수 있다. 강연자가 NVIDIA Nemotron 계열 사례를 언급한 것도 같은 맥락이다. SFT prefix가 붙은 데이터가 pre-training recipe 안으로 들어오면, 모델은 대화와 작업 수행의 패턴을 post-training이 아니라 처음부터 배울 수 있다.
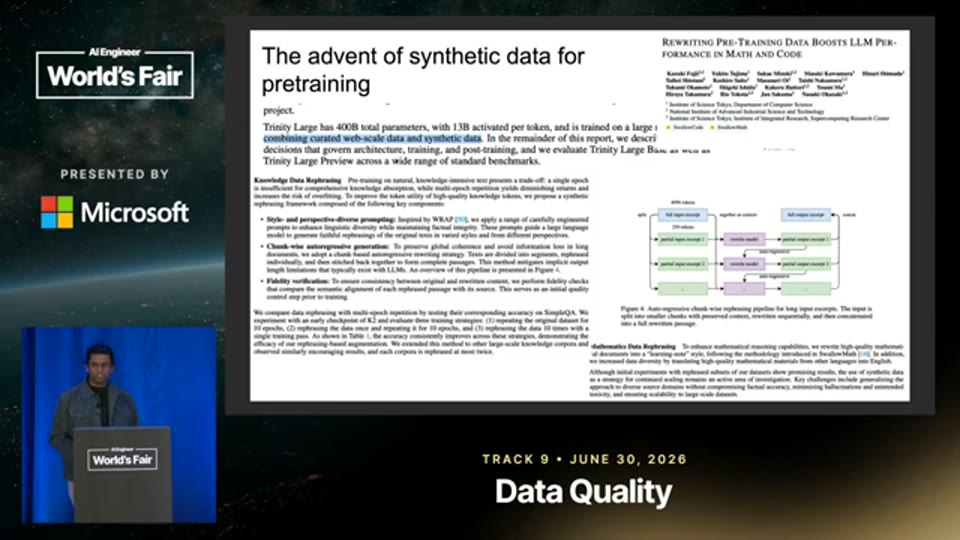
10:33 - Trinity Large, Kimi K2, Swallow Code·Math 사례를 통해 synthetic data 활용 방식을 설명하는 화면
MoE 모델에서 Early Task Exposure가 중요한 이유
Mixture of Experts(MoE) 모델에서는 이 문제가 더 기술적인 형태로 나타난다. MoE는 여러 expert가 입력에 따라 선택적으로 활성화되는 구조이기 때문에, 학습 중 expert 간 load balancing이 매우 중요하다. 만약 pre-training 동안 모델이 일반 웹 텍스트 중심 분포만 보다가 post-training에서 갑자기 질의응답, reasoning trace, agentic trace 같은 전혀 다른 분포를 만나면 expert 사용이 불균형해질 수 있다.
강연자는 MAI Thinking 1 보고서에서 보이는 사례를 언급하며, 이런 분포 차이를 보정하기 위해 SFT 단계에서 load balancing coefficient를 크게 높여야 했다고 설명한다. 그러나 이상적인 방향은 학습 후반에 균형을 억지로 맞추는 것이 아니라, pre-training 초기부터 downstream distribution을 어느 정도 노출해 안정적인 representation을 형성하게 하는 것이다. 이 관점에서 SFT 데이터와 agentic trace를 pre-training 또는 mid-training으로 끌어오는 흐름은 단순한 데이터 편의가 아니라 MoE 안정성 문제와도 연결된다.
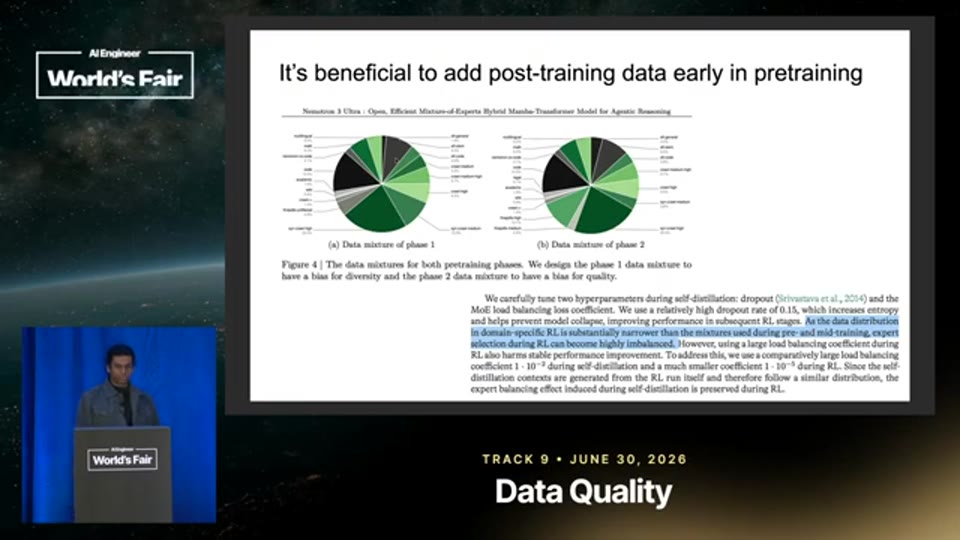
12:11 - MoE load balancing 문제와 post-training distribution shift를 설명하는 화면
Pre-training, Mid-training, Post-training의 경계가 흐려진다
강연자는 현재의 LLM 학습을 pre-training, mid-training, post-training, RL로 엄격하게 나누는 방식이 점점 덜 유용해지고 있다고 본다. 대신 그는 오늘날 LLM 학습을 크게 두 축으로 이해하는 편이 낫다고 말한다. 하나는 next-token prediction을 통한 supervised learning이고, 다른 하나는 환경 속에서 행동을 개선하는 RL이다. 이 구분은 학습 단계의 이름보다 모델이 어떤 능력을 어떤 방식으로 얻는지를 더 잘 드러낸다.
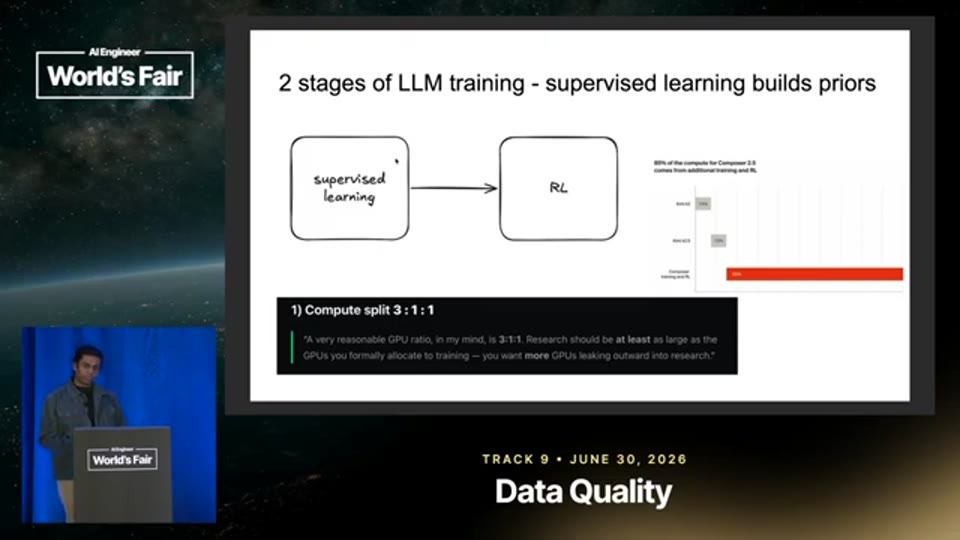
14:04 - pre-training과 post-training compute allocation을 비교하는 인터뷰 스크린샷 화면
이 관점에서는 supervised learning의 목적도 달라진다. 과거에는 supervised learning, 특히 pre-training이 모델 능력의 대부분을 만드는 단계였다면, 이제는 RL이 잘 작동하도록 atomic skill을 미리 심어두는 준비 과정으로 볼 수 있다. 강연자가 AlphaGo의 그래프를 언급한 것도 이 지점이다. AlphaGo에서 RL이 결국 supervised learning을 넘어섰듯, 언어 모델에서도 RL의 비중이 계속 커질 수 있지만, 인간 언어의 분포는 워낙 복잡하기 때문에 RL만으로 모든 것을 학습하는 미래가 올지는 아직 불확실하다.
Reasoning Trace와 Test-time Compute를 미리 학습시키는 흐름
최근 일부 연구실은 supervised learning 단계에서 모델이 이전에 거의 보지 못했을 새로운 형태의 데이터를 넣고 있다. 대표적인 예가 reasoning trace다. 인간이 자연스럽게 생산하는 일반 텍스트와 달리, reasoning trace는 문제 해결 과정을 구조화해 드러내는 인공적 형식에 가깝다. 모델이 이런 형태를 미리 접하면 RL 단계에서 더 넓은 탐색 공간을 안정적으로 탐험할 수 있다.
또 다른 흐름은 test-time compute scheme을 학습 초기에 예열하는 것이다. 즉, 모델이 추론 시 더 오래 생각하거나 여러 후보를 탐색하거나 중간 산출물을 활용하는 방식에 익숙해지도록 SFT 또는 pre-training 단계에서 관련 데이터를 제공하는 것이다. 강연자는 Zephyr의 Zaya 1 논문 스크린샷을 예로 들며, 데이터가 단순한 지식 전달 수단이 아니라 RL에서 필요한 탐색 능력과 행동 양식을 형성하는 장치가 될 수 있다고 설명한다.
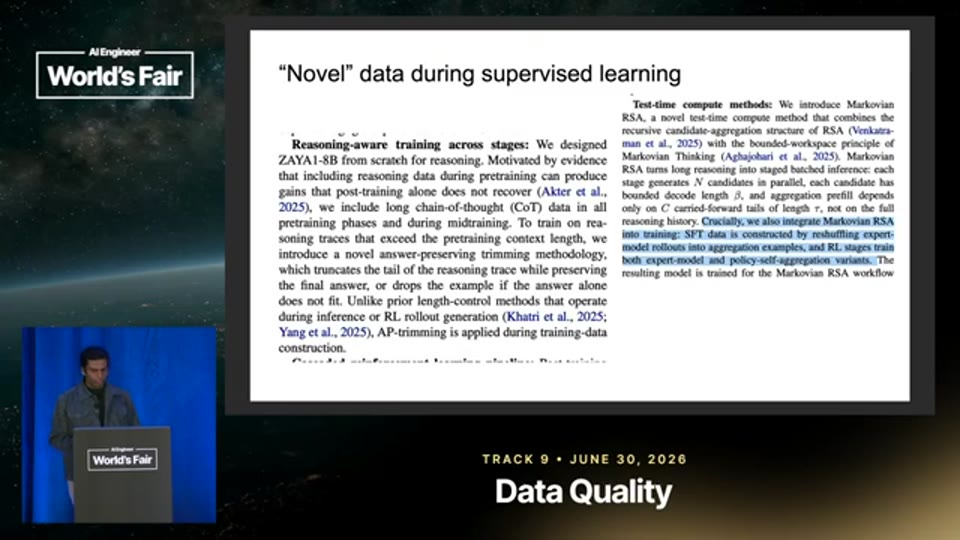
16:20 - Zephyr Zaya 1 논문 사례를 통해 reasoning trace와 test-time compute 학습을 설명하는 화면
마무리 / 핵심 정리
이 강연의 결론은 base model이 죽었다는 선언이라기보다, base model의 역할이 바뀌었다는 진단에 가깝다. 과거 base model은 일반 인간 지식과 world prior를 만드는 단계였지만, 현재의 base model은 reasoning과 agentic behavior를 위한 prior를 만드는 단계로 이동하고 있다. 따라서 좋은 base model이란 더 이상 웹 텍스트를 가장 많이 흡수한 모델만을 뜻하지 않는다. 앞으로의 base model은 RL이 조합할 수 있는 atomic skill을 충분히 갖고, downstream task의 분포를 일찍 경험하며, reasoning·coding·tool use 같은 실제 사용 환경에 맞는 representation을 안정적으로 형성한 모델에 가까워질 것이다.
이 변화는 LLM 개발의 경쟁축도 바꾸고 있다. 데이터의 양보다 데이터의 형식, pre-training과 post-training의 경계보다 RL을 위한 준비성, 단순한 지식 축적보다 환경 속 행동 능력이 더 중요해지고 있기 때문이다. 만약 다음 세대의 인터페이스가 현재의 chatbot이나 coding agent와 다른 형태로 이동한다면, base model도 다시 그 인터페이스를 위한 prior를 만들도록 재설계될 가능성이 높다. 그런 의미에서 “base model is dead”라는 제목은 종말론적 주장이라기보다, 기존 정의의 수명이 다했다는 선언으로 읽는 편이 정확하다.
📚 출처 및 참고
| 구분 | 내용 |
|---|---|
| 원본 영상 | The Base Model Is Dead — Varun Singh, Arcee AI |
| 채널 | AI Engineer |
| 리포트 작성 | 2026-08-01 |
| 작성 방식 | YouTube 영상 STT 변환 후 에디팅 |
💬 본 리포트는 영상 내용을 바탕으로 재구성되었습니다. 정확한 내용은 원본 영상을 참조해 주세요.
Related Reports
- Data and Environment Curation for Post-Training LLMs — Mahesh Sathiamoorthy, Bespoke Labs
- NVIDIA Nemotron은 그냥 AI 모델이 아니네요… Nemotron DevDay Seoul - 네모트론이 보여준 AI의 진짜 방향, 모델보다 중요한 데이터와 학습 구조
- The Prime Intellect Stack - Will Brown, Prime Intellect
- EP 81. DeepSeek이 바꿔버린 모든 것 - MoE와 RLVR, 2025년 AI 회고
- Data Quality Is the Compute Multiplier - Ari Morcos, DatologyAI